Habr AI
Источник AI-новостей. Материалы автоматически отбираются и адаптируются редакцией Hamidun News.
Последние публикации
ИИ-ассистенты в 2026 году: как соло-разработчик стал быстрее команды из трёх человек
Автор показывает, что в 2026 году один разработчик с набором open-source ИИ-инструментов может писать, тестировать и коммитить код быстрее, чем небольшая команда двумя годами раньше.
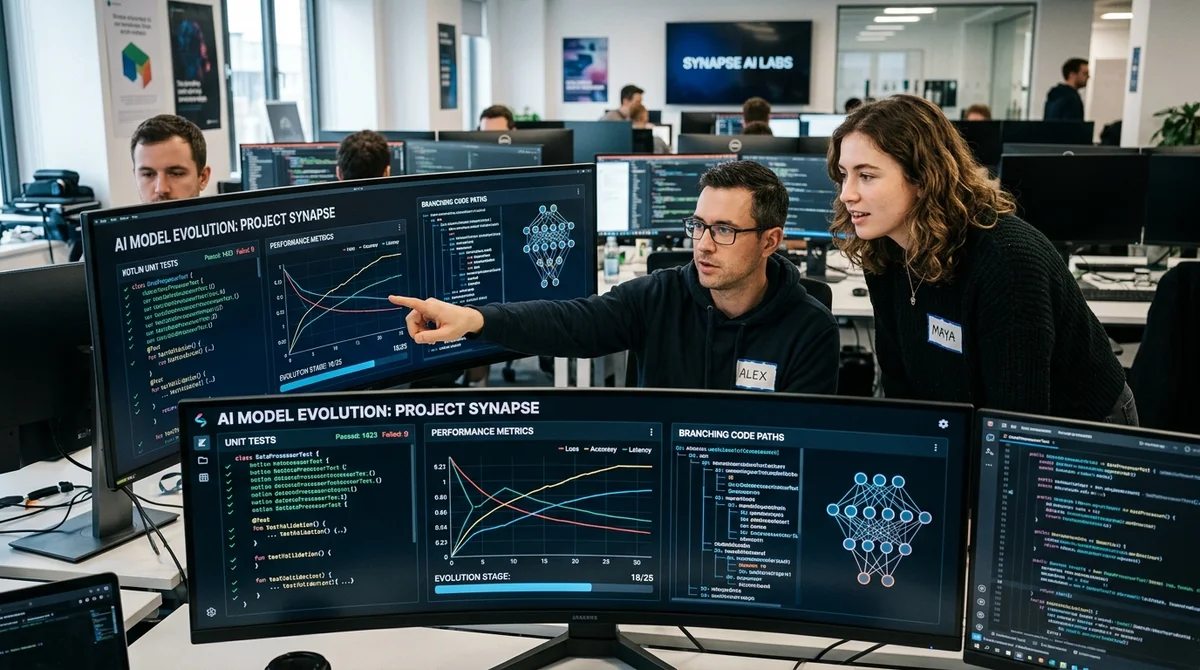
ecom.tech сравнила эволюционное дообучение Qwen3-4B с SFT и GRPO для тестов на Kotlin
Команда ecom.tech дообучила Qwen3-4B-Instruct для генерации unit-тестов на Kotlin и показала, что эволюционный алгоритм обходит SFT и GRPO по метрикам качества, но ухудшает общие способности модели.
Yandex Code Assistant проверили на задаче с секретами и сравнили по опыту с Cursor
Инженер «Инфосистем Джет» протестировал Yandex Code Assistant на задаче с хранением секретов и показал, что агент уже близок к Cursor, но всё ещё требует контроля со стороны разработчика.
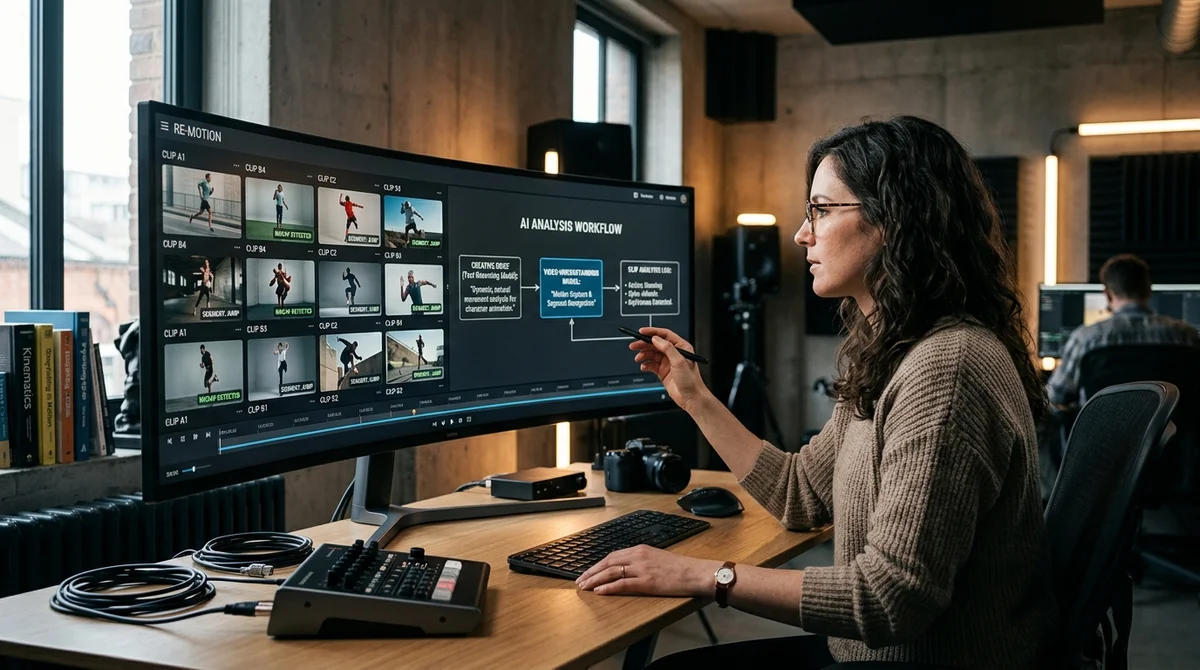
Claude и Qwen Omni: как разработчик подключил видеоанализ к рабочему пайплайну
Автор публикации на Habr связал Claude с Qwen Omni, чтобы обойти отсутствие прямой работы с видео и автоматически разобрать 29 анимационных референсов по движениям и категориям.
Как Совкомбанк сократил рутину продуктовой команды на 50% с помощью ИИ-ассистента
В Совкомбанке собрали ИИ-ассистента на базе LLM и единого промпта, чтобы забрать у продакт-менеджеров документацию, согласования и часть аналитики, освободив до половины времени.
Критики назвали партнёрство OpenAI с McKinsey и Accenture ставкой на AI-хайп
Автор жёсткой колонки утверждает, что программа OpenAI Frontier Alliances продаёт бизнесу не готовый результат, а дорогой процесс внедрения AI coworkers через крупных консультантов.
Google Veo, Runway и Kling вошли в топ бесплатных нейросетей для генерации видео в 2026 году
Авторы сравнили десять популярных бесплатных генераторов видео, включая Google Veo, Runway и Kling, и проверили их на сложной сцене с енотом, шерстью, стеклом и светом.
Rufler упрощает рои в Claude Code: один конфиг вместо ручной оркестрации агентов
Open-source инструмент Rufler сводит запуск автономных агентов в Claude Code к одному конфигу, автоматически собирает роли, задачи и MCP-серверы и упрощает контроль токенов и статусов.
Claude Code помог собрать приложение для анализа графов почти за час — кейс разработчика
Разработчик с низкими ожиданиями собрал рабочее приложение для анализа графов примерно за час, но потом потратил ещё три недели на тесты, документацию и приведение процесса в порядок.
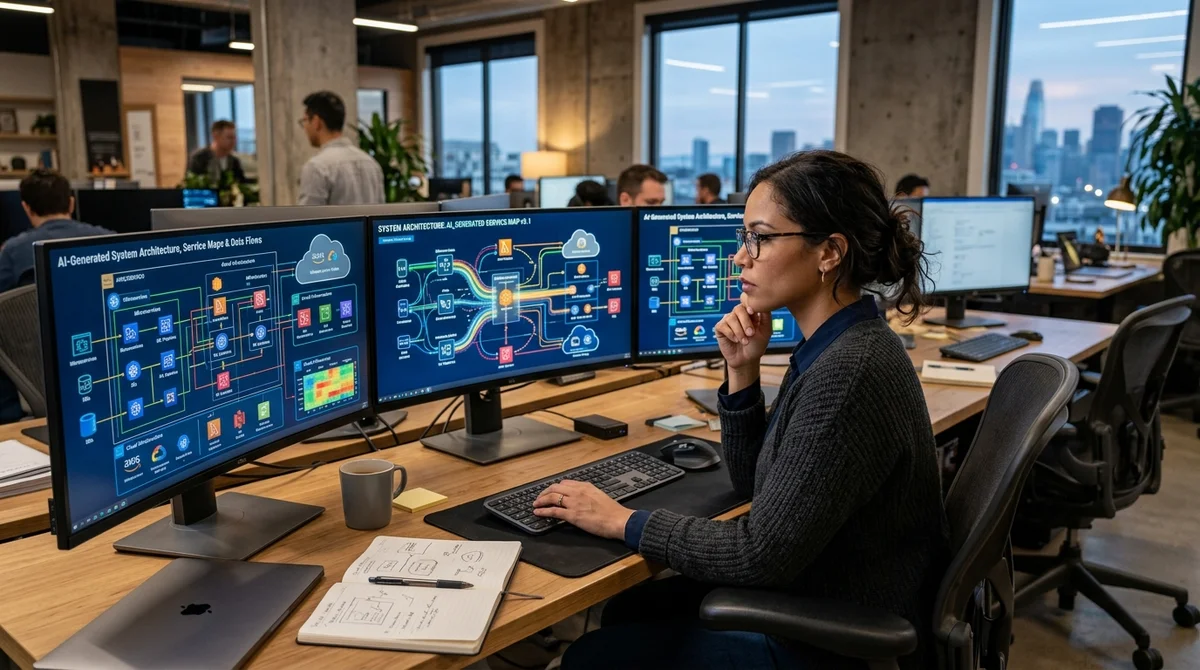
IBS объясняет, как нейросети меняют проектирование ПО и почему не заменят архитектора
IBS разбирает, как большие языковые модели и генеративные инструменты помогают проектировать системы, сравнивать компромиссы и ускорять работу архитектора, но не снимают с него ответственность.
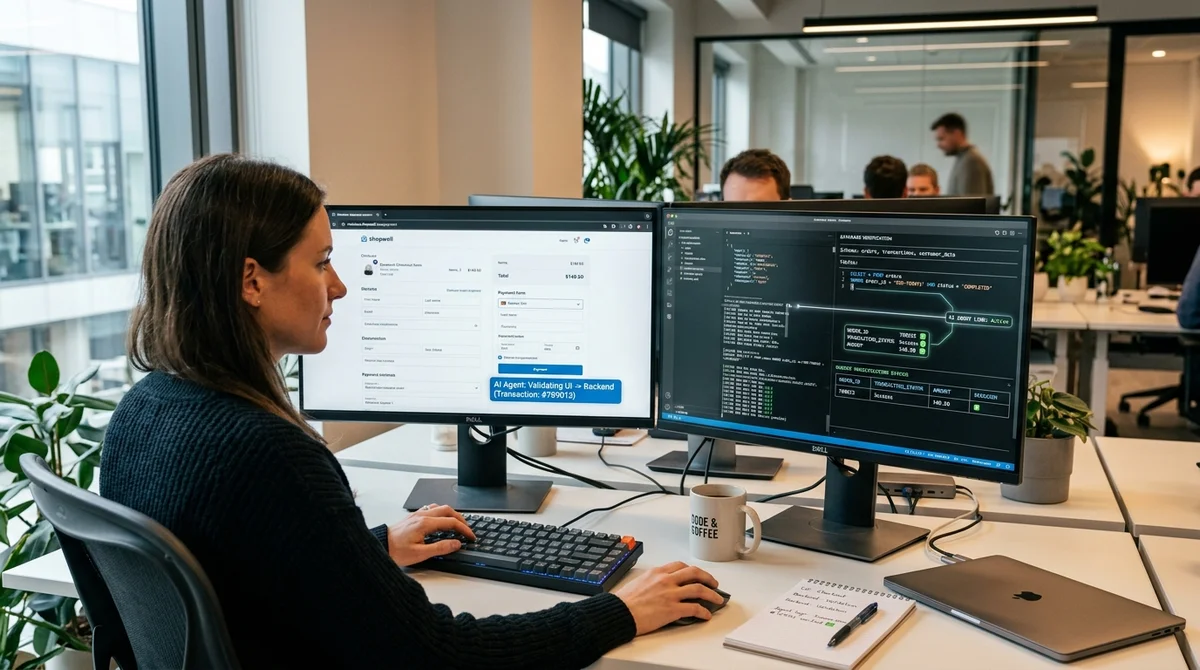
Playwright и MCP: как AI-агент проверяет UI и базу данных без ручных SQL-ассертов
Playwright-агент в связке с MCP может не только прогнать checkout в браузере, но и сразу подтвердить изменения в базе данных без ручных SQL-ассертов и лишнего тестового кода.
Почему модели OpenAI, Google и Anthropic становятся убедительнее, но ошибаются чаще
Крупные ИИ-лаборатории пытаются лечить ошибки моделей дополнительными вычислениями, но чем убедительнее становятся ответы, тем труднее заметить глубокие галлюцинации.
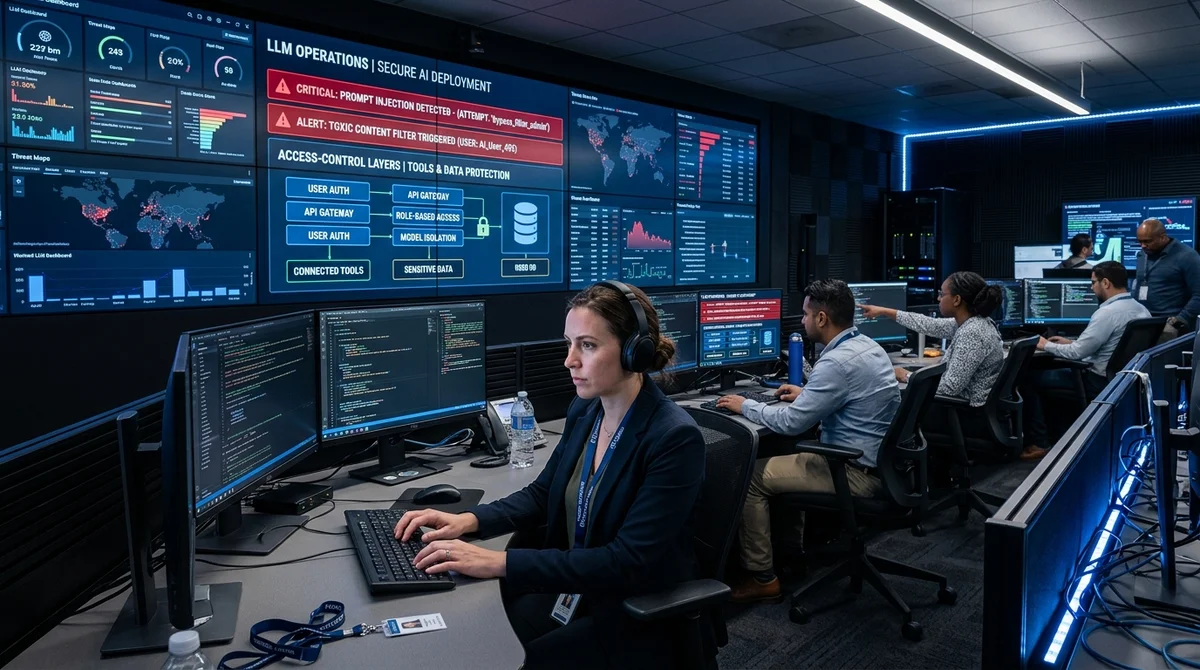
Habr AI: зачем языковым моделям guardrails и как защищаться от промпт-хакинга
Habr AI разбирает, почему для LLM уже нужен отдельный защитный слой: от токсичного контента и утечек данных до prompt injection, jailbreak-атак и контроля работы агентов.
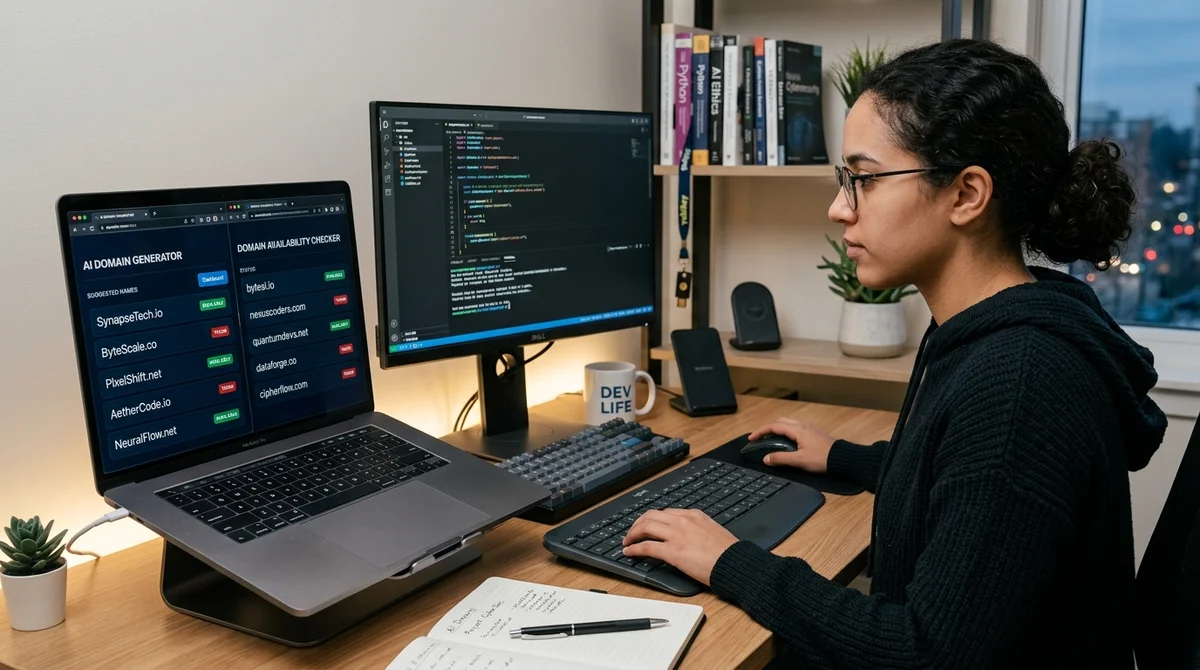
Инженер Selectel показал LLM-агента для автоматического подбора свободных доменов
Инженер Selectel собрал Python-сервис, который просит LLM генерировать доменные имена и сразу проверяет их через WHOIS, оставляя только свободные варианты.
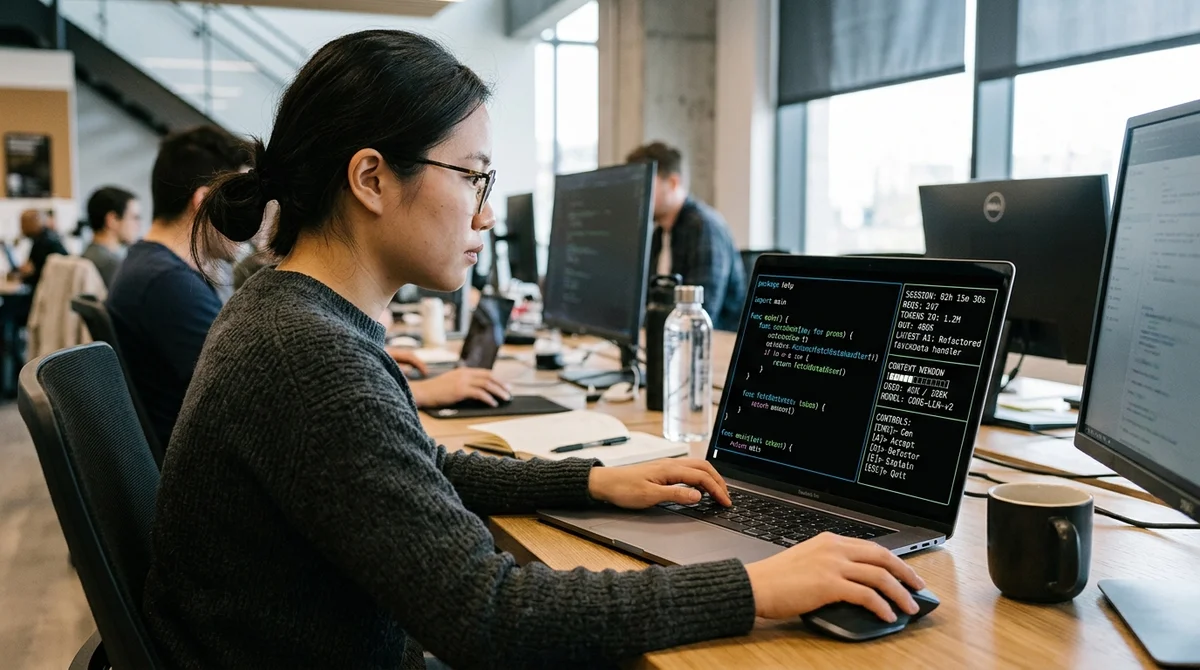
Anthropic объяснила, как и когда в Claude Code правильно начинать новую сессию
Anthropic выпустила команду /usage и объяснила, как в Claude Code управлять сессиями, чтобы миллион токенов контекста не превращался в шум и не ухудшал качество ответов.
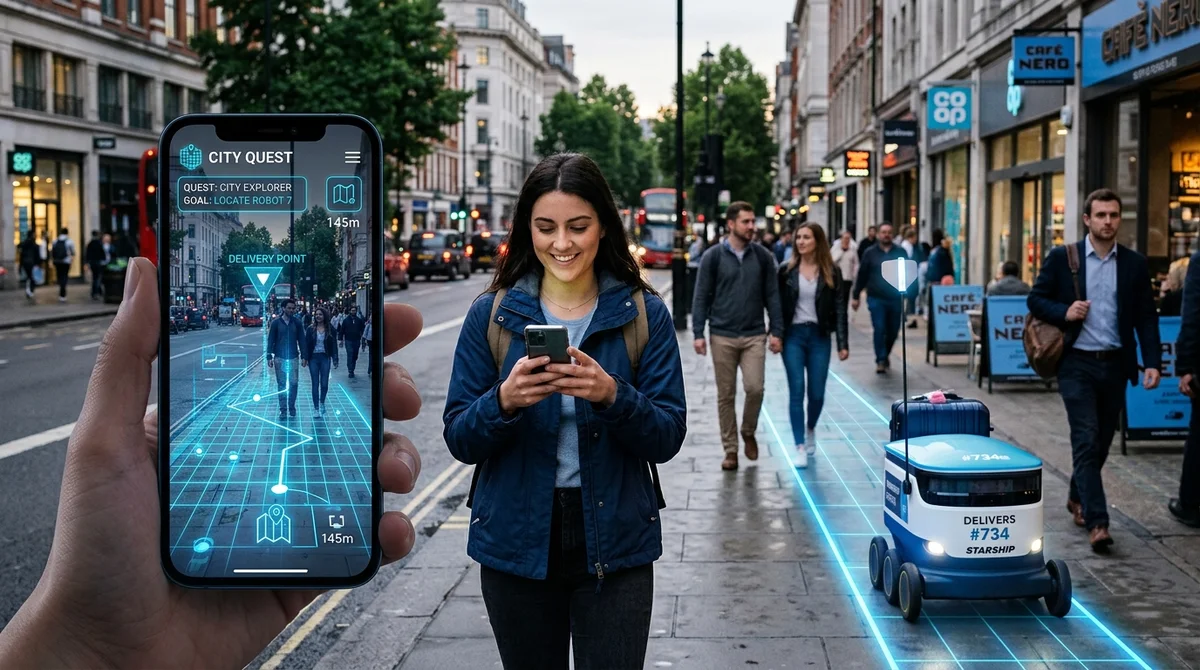
Niantic показала, как Pokémon Go превращает действия игроков в датасеты для ИИ
Niantic, Google и другие компании все чаще превращают обычные действия пользователей — от игры и поездок до капчи — в данные для обучения ИИ, навигации и роботов.
Positive Technologies перечислила лучшие бенчмарки для оценки LLM в кибербезопасности
Positive Technologies разделила кибербенчмарки для LLM на тесты знаний и практики и показала, что модели уже сильнее людей в теории, но все еще заметно проседают в реальных задачах.
ИИ-дефляция в IT: кейсы Klarna и IBM объясняют, почему вакансий больше, а рост зарплат слабее
В разработке возник новый парадокс: вакансий для инженеров стало на 11% больше, но рост зарплат в IT замедлился до 1,6%, а у части сеньоров доходы уже ушли в минус.
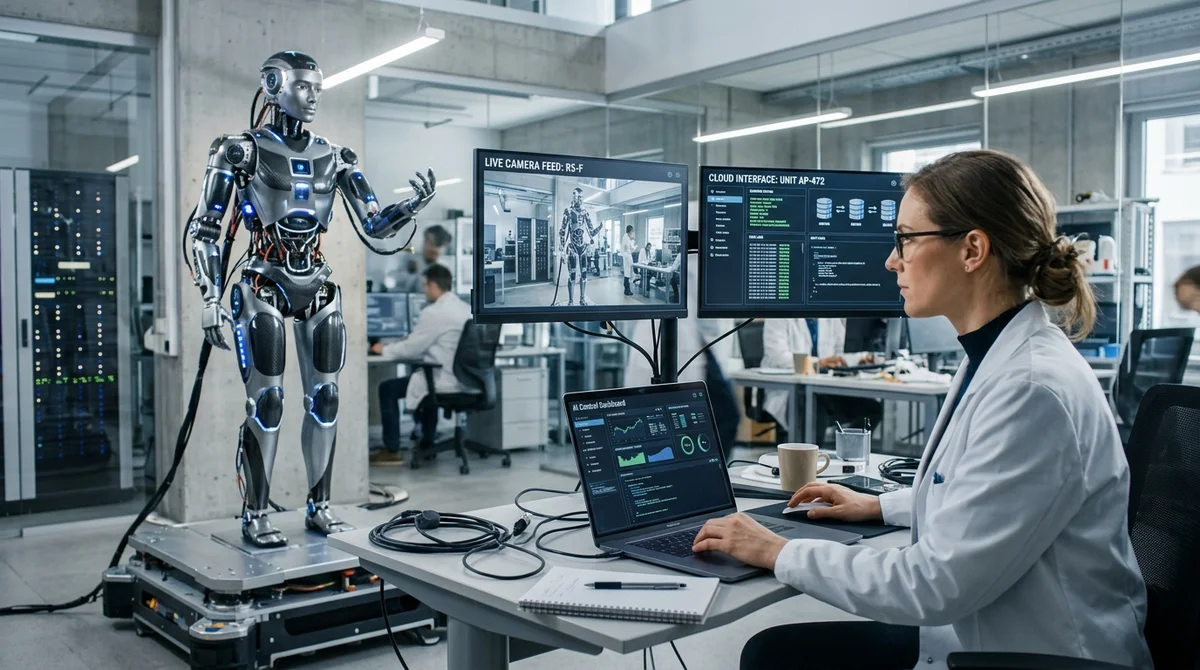
МТС показала, как OpenClaw подключили к роботу и вынесли AI-агента в физический мир
Команда MWS показала, что OpenClaw можно связать с физическим роботом через простую программную прослойку и облачную LLM, не строя сложную VLA-систему с нуля.
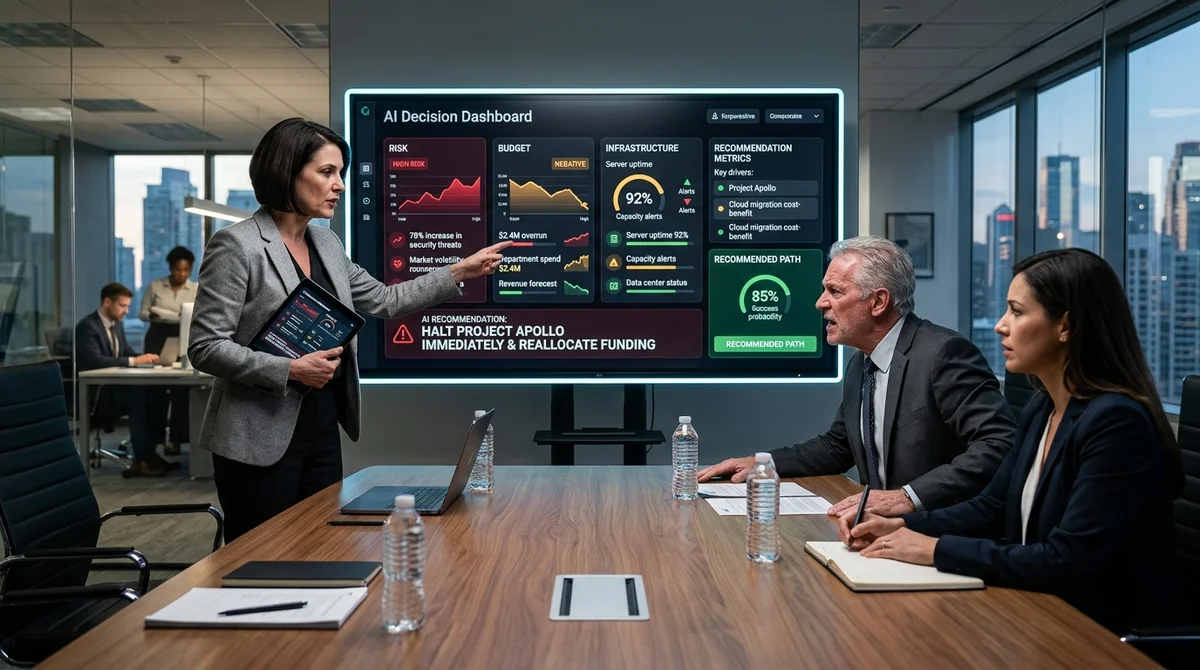
Claude Sonnet помог топ-менеджерам за 8 часов собрать ИИ-директора для жёстких решений
На закрытом хакатоне Snow BASE команда из CEO, CTO и CIO за восемь часов собрала CAITO — ИИ-директора на Claude Sonnet, который меняет позицию только при появлении новых фактов.
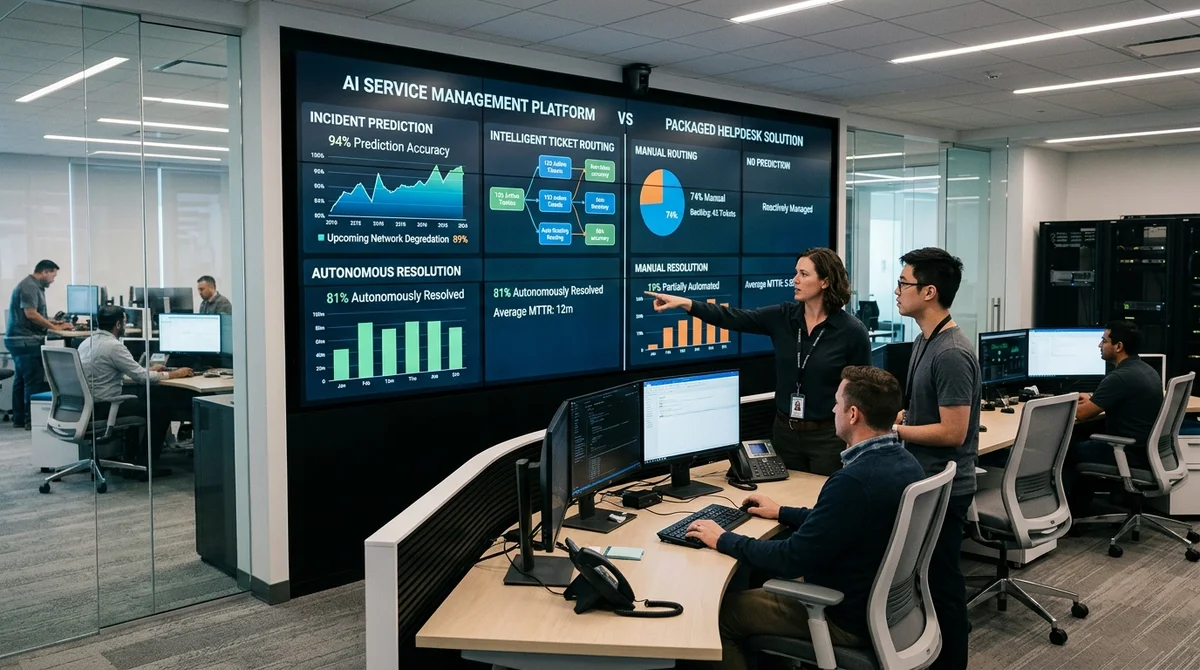
Почему ServiceNow, Atlassian и BMC меняют рынок ITSM и спор о платформе в 2026-м
Рынок ITSM с ИИ смещается от чат-ботов к управляемой инфраструктуре, где выбор между коробкой и платформой определяют безопасность, масштаб и контроль над агентами.
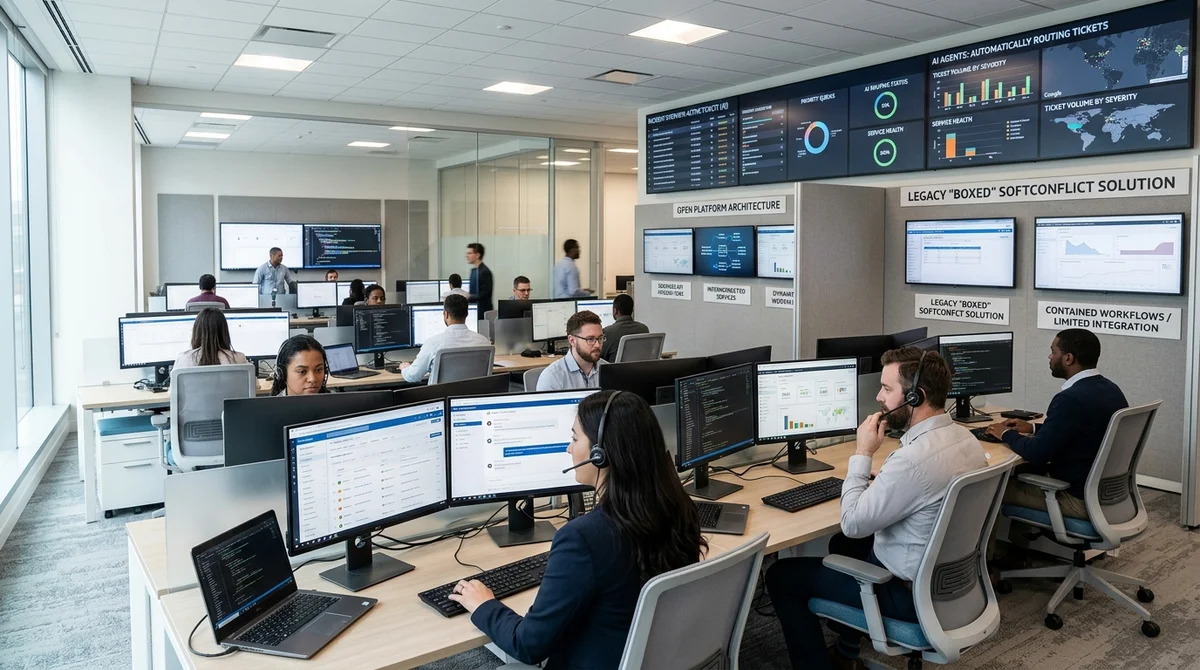
ServiceNow и Atlassian ведут рынок ITSM к AI-платформам вместо коробочных решений
AI в ITSM быстро смещается от чат-ботов к управляемой инфраструктуре: рынок сравнивает платформенный и коробочный подходы, а ключевыми становятся аудит, безопасность и гибкость.
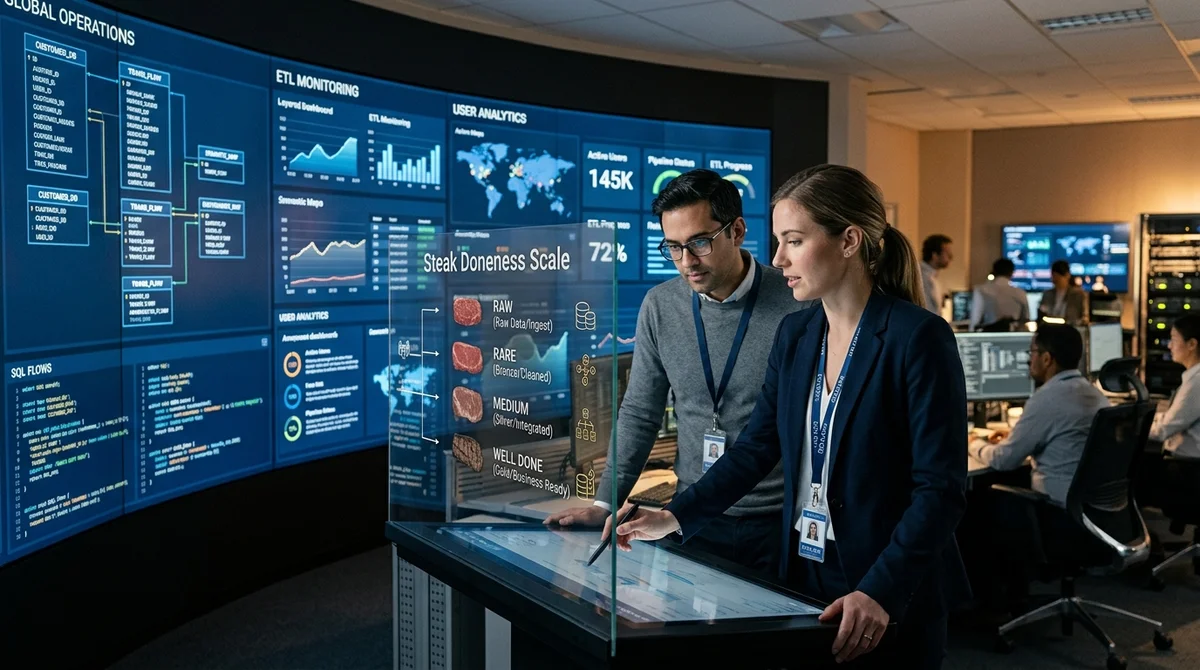
Wildberries & Russ описала, какой уровень зрелости данных нужен для точных ИИ-агентов
Wildberries & Russ описала трёхуровневую модель зрелости данных, где качество метаданных и семантического слоя напрямую определяет точность LLM, text-to-SQL и ИИ-агентов.
Midjourney в 2026 году: почему сильный визуальный стиль не делает его универсальным
Разбор Midjourney показывает, что в 2026 году его главный плюс — не универсальность, а узнаваемый стиль и глубокий контроль, который раскрывается только при осмысленной работе с промптами.
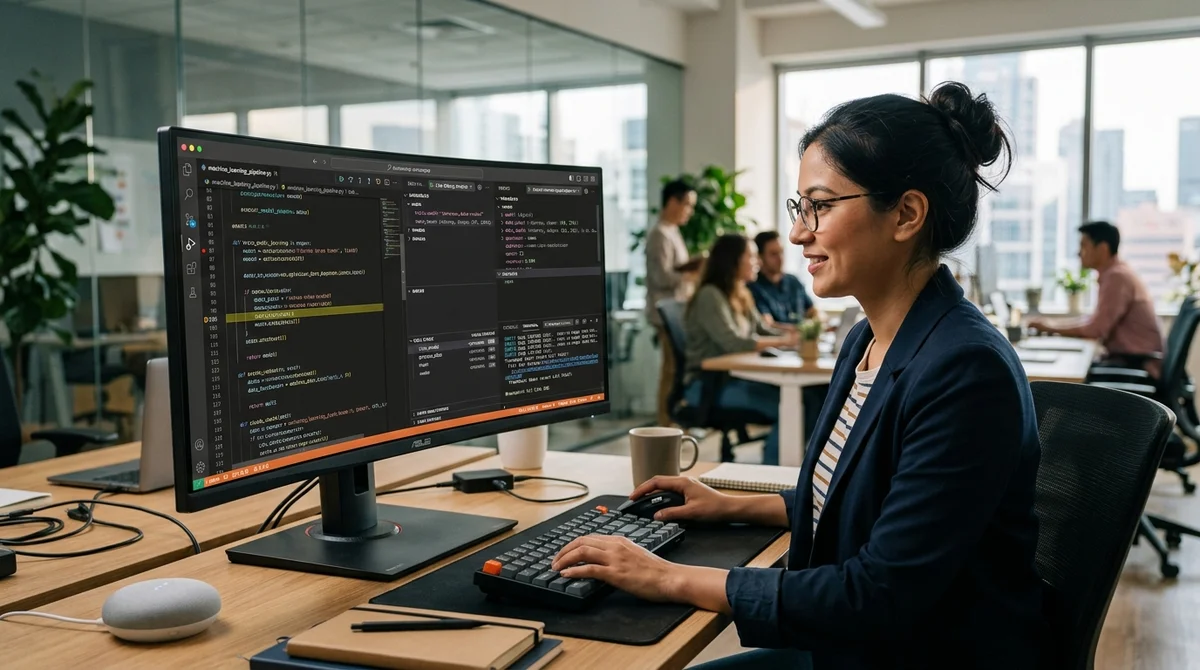
Cursor и Microsoft Research проверяют, нужен ли ИИ-агенту полноценный доступ к дебаггеру
Эксперимент с Debug2Fix и режимом Cursor Debug Mode показывает, что брейкпоинты, пошаговое выполнение и evaluate expression могут помочь ИИ-агенту заметно чаще чинить реальные баги.
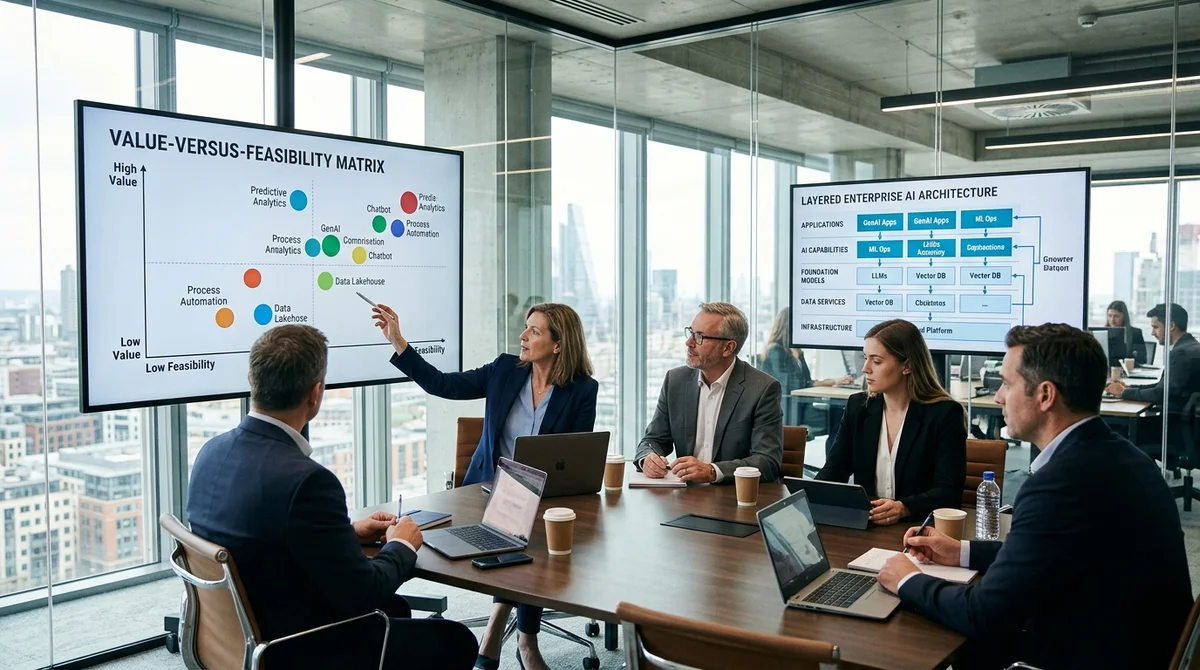
Raft показала, как приоритизировать AI-инициативы и собрать реалистичную дорожную карту
Raft разобрала, как оценивать ценность AI-инициатив, отсеивать слабые идеи через матрицу достижимости и собирать поэтапную дорожную карту трансформации.
Gemma 4 в Codex CLI: локальный запуск оказался рабочим, но пока слабее облака
Тест локальной Gemma 4 в Codex CLI показал, что модель уже умеет работать с tool calling и проходить тесты, но по качеству, стабильности и времени всё ещё уступает облачному GPT-5.4.
Почему LLM создают иллюзию творчества и не гарантируют настоящую новизну идей
LLM помогают быстро развивать замысел и доводить его до финальной формы, но их уверенный стиль легко маскирует вторичность, компиляцию и отсутствие реальной новизны.
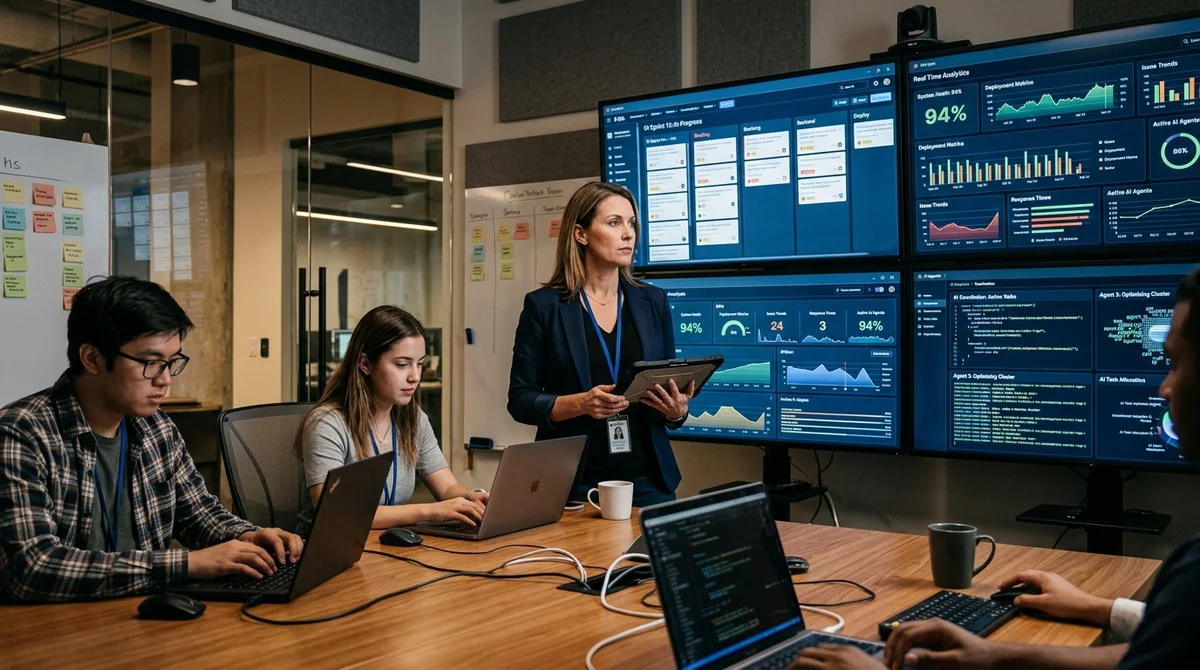
Как ИИ-агенты и IBM меняют управление IT-проектами и роль менеджера проекта
ИИ-агенты выходят за пределы чат-ботов: они уже помогают менеджерам проектов планировать спринты, оценивать риски и разбирать инциденты, а кейс IBM показывает заметный эффект.
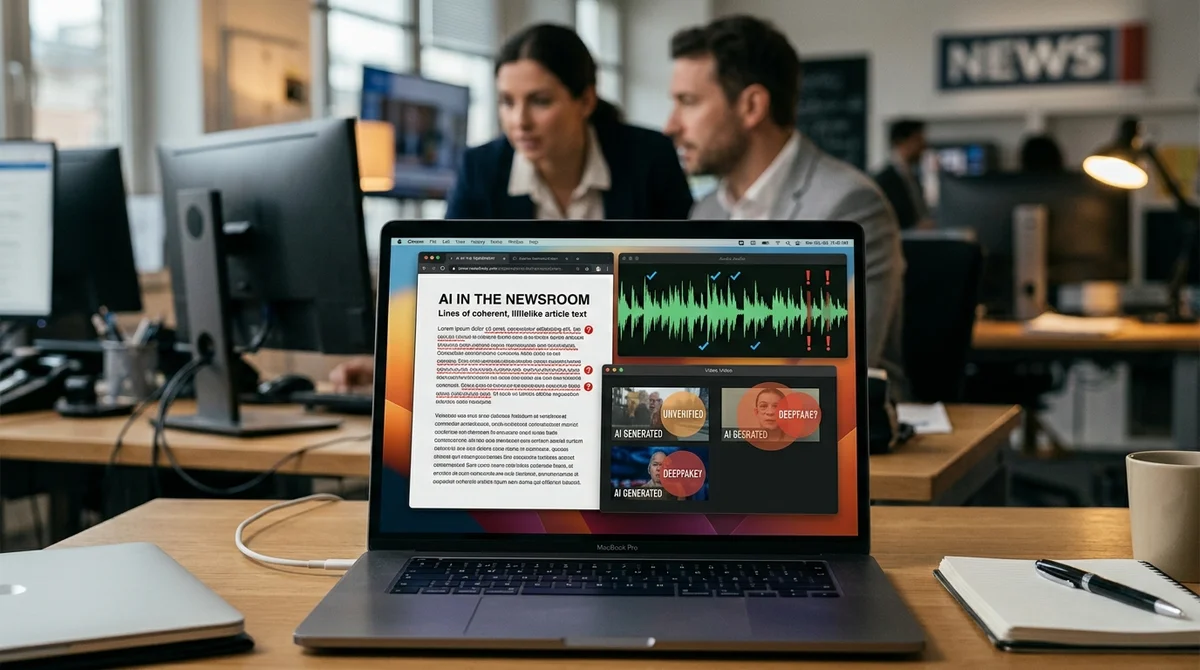
StudyAI: как генеративный ИИ подрывает доверие к текстам, голосам и видео в онлайне
StudyAI разбирает, как генеративный ИИ делает фейки убедительнее, обесценивает цифровые доказательства и толкает интернет к эпохе тотального недоверия.