Hugging Face Blog
Fonte de notícias de IA. Os artigos são selecionados e adaptados pela redação do Hamidun News.
Últimas publicações

Ai2 mostra que LLMs-juízes de novidade falham com poucas palavras no prompt
Ai2 testou seis LLMs-juízes em 299 ideias de reviews do ICLR 2026: mudar a redação do prompt derrubou o GPT-5.4 de 93,5% para 40,9% de precisão, e sistemas caros perderam para um prompt barato.

Liquid AI lança LFM3: seis modelos multimodais de 2B com contexto de 256K
O LFM3-1.7B supera o LFM2.5-2.6B com 35% menos parâmetros e cabe em 1 GB com 4 bits. Uma única base reúne modelos de texto, visão, áudio, omni e com respostas calibradas.

Black Forest Labs lança o FLUX.3 Klein: 1024×1024 em 2 segundos na H100
O FLUX.3 Image Klein, da Black Forest Labs, já funciona no Diffusers desde o primeiro dia: text-to-image, edição por referências e controle de layout via bounding box. Imagem em 1,93 s.

Liquid AI lança o LFM2.5-24B-A2B: um modelo para agentes com 2B de parâmetros ativos
A Liquid AI abriu os pesos de um modelo MoE de 24B parâmetros, dos quais só 2B ficam ativos. Ele gera 184 tok/s em um notebook com M5 Max e mais de 21 mil tok/s em uma única B300.

PyTorch 2.15 acelera modelos MoE no Mac em 5–6,5 vezes e traz FP8
A equipe da Hugging Face reescreveu operações críticas do MPS em Metal: o Qwen3.6-35B-A3B no M3 Ultra foi de 9,4 para 61,3 tokens/s, e o pico de memória do Wan2.2 caiu de 270 para 8 GiB.

NVIDIA Kumo Relational supera ML supervisionado em 41 tarefas sem treinamento
A NVIDIA lançou o Kumo Relational: modelo pré-treinado prevê churn e demanda direto no banco relacional, em uma única passada, e supera o AutoGluon em 8% de MRR no SAP SALT.

Apertus 1.5, da Suíça, ganha visão, audição e contexto de 262 mil tokens
O projeto Swiss AI lançou o Apertus 1.5 em 8B e 70B sob Apache 2.0: multimodalidade via tokenizador, modo de raciocínio, contexto 4 vezes maior e dados totalmente abertos.

Microsoft e Hugging Face treinam o Qwen3.8-27B com avaliações do banco de dados: de 38 para 107 tarefas
Verificações do estado final do banco de dados viraram recompensa para o GRPO: em 50 passos, o Qwen3.8-27B foi de 51,70% para 60,78% em pass@1 e quase triplicou as tarefas com 20/20.

Dharma-AI enxuga o vocabulário do Qwen3-4B e reduz o custo de inferência em 77%
A equipe brasileira Dharma-AI refez o tokenizador do Qwen3-4B para uma única tarefa. A resposta caiu de 350 para 101 tokens, e a qualidade subiu de 0,703 para 0,810.

Reflection lança o Beam: modelo MoE aberto de 501B de parâmetros sob Apache 2.0
O novo laboratório americano Reflection abriu o Beam: 501B de parâmetros, 23B ativos por token, contexto de 1M e licença Apache 2.0. O foco é código e agentes.

Meta abre o Muse Spark Open: MoE de 816 bilhões de parâmetros e contexto de 1 milhão de tokens
A Meta lançou o Muse Spark Open: modelo open-weight com 816 bilhões de parâmetros, 42 bilhões ativos por token, entrada de texto, imagem, áudio e vídeo e foco em codificação agêntica.

GPUs paradas como aviões em solo: Hugging Face explica as perdas ocultas das equipes de IA
A Hugging Face compara GPUs ociosas a aviões em solo e mostra por que a má gestão de GPUs custa às equipes de IA centenas de milhares de dólares por ano.

Nunchaku Lite: geração de imagens em 4 bits no Diffusers com até 50% menos VRAM
A Hugging Face integrou a inferência em 4 bits do Nunchaku Lite diretamente ao Diffusers: até 50% menos memória de vídeo e geração de imagens 30% mais rápida com uma única linha de código.

NVIDIA abre os datasets Nemotron: 10 trilhões de tokens para treinar agentes de IA
A NVIDIA lançou os datasets Nemotron, com mais de 10 trilhões de tokens e 2,4 bilhões de personas sintéticas para treinar agentes de IA em cenários reais e falhas de ferramentas.

Hugging Face: o backend de transformers no vLLM agora roda em velocidade nativa
A Hugging Face anunciou paridade de desempenho: a flag --model-impl transformers entrega a velocidade nativa do vLLM em mais de 450 arquiteturas, sem reescrever código.
Hugging Face lança nuvem sem cobrança por tráfego de saída
A integração entre SkyPilot e Hugging Face Storage permite treinar modelos em qualquer nuvem, guardando pesos e datasets por US$ 12-18/TB/mês sem cobrança de tráfego de saída.
Microsoft lança o Foundry Managed Compute: milhares de modelos do Hugging Face com um clique
Microsoft integra o Azure Foundry ao catálogo do Hugging Face: milhares de modelos abertos agora sobem na nuvem com um clique, segurança corporativa e cobrança unificada.
LeRobot v0.6.0, da Hugging Face: robôs aprendem a prever o futuro e a se autoavaliar
A Hugging Face lançou o LeRobot v0.6.0 com políticas de world model, modelos de recompensa para avaliar tarefas automaticamente e seis novos benchmarks, fechando o ciclo completo de treinamento.
Hugging Face atualiza o Kernels com editores confiáveis, assinatura de código e desenvolvimento com agentes
Em 6 de julho de 2026, a Hugging Face lançou uma grande atualização do Kernels: os kernels viraram um tipo próprio de repositório no Hub, com editores confiáveis e assinatura de código via Sigstore.
Hugging Face e Cerebras lançam IA de voz em tempo real com Gemma 4
Hugging Face e Cerebras apresentam um pipeline aberto de fala para fala baseado no Gemma 4, com latências previsíveis. Ele já roda em mais de 9000 robôs Reachy Mini.
PaddleOCR lança PP-OCRv6: reconhecimento de texto em 50 idiomas com 1,5 a 34,5 milhões de parâmetros
O PP-OCRv6, da Baidu PaddlePaddle, é um OCR universal para 50 idiomas em três configurações de 1,5 a 34,5 milhões de parâmetros, com +4,6–5,1 p.p. de precisão sobre a versão de servidor anterior.
ServiceNow: agente de IA vaza segredos corporativos por meio de uma cadeia de buscas
Pesquisadores da ServiceNow mostram que um agente de deep research expõe segredos corporativos sem querer: cada consulta é inofensiva, mas a cadeia inteira forma um mosaico.
Hugging Face compara todas as alternativas ao LoRA: qual método vence no ajuste fino de LLMs
A Hugging Face testou cinco métodos PEFT de ajuste fino de LLMs, do DoRA ao GaLore, e mostra quando é possível superar o LoRA e por quê.
Modelos híbridos predizem melhor palavras de conteúdo do que transformers — estudo da Allen AI
A Allen AI comparou as arquiteturas OLMo 3 e OLMo Hybrid: modelos híbridos predizem com mais precisão substantivos, verbos e adjetivos, mas ficam atrás dos transformers em trechos repetitivos de texto.
Hugging Face: agora é possível iniciar um servidor vLLM no HF Jobs com um único comando
A Hugging Face adicionou suporte a vLLM à plataforma HF Jobs: agora, um servidor de inferência pronto para produção para qualquer modelo do Hub pode ser implantado com um único comando de CLI.
AllenAI Lança olmo-eval — Uma Plataforma para Avaliar LLMs Durante o Treinamento
AllenAI lançou olmo-eval, um kit de ferramentas aberto para avaliação contínua de modelos de linguagem durante todo o ciclo de treinamento — checkpoint por checkpoint.
Cohere apresenta North Mini Code — modelo para desenvolvedores e agentes de IA
Cohere lançou North Mini Code — um modelo de 30 bilhões de parâmetros, especialmente treinado em programação e funcionamento com agentes de IA. O modelo é gratuito e acessível a todos.
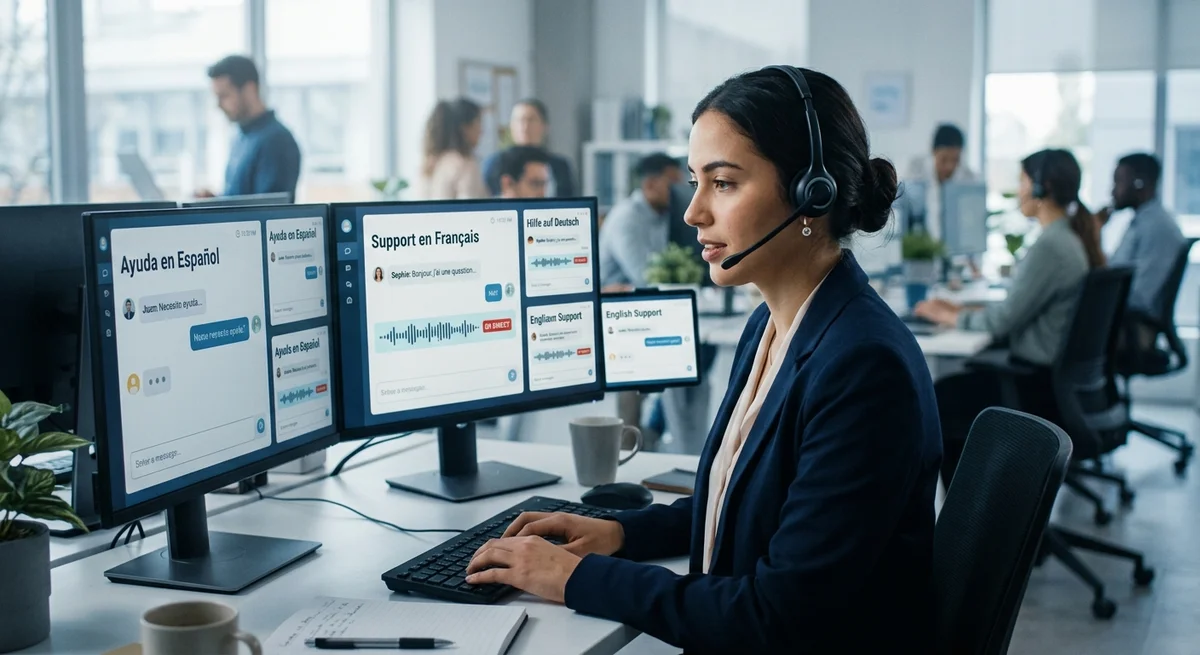
Agentes de voz não estão prontos para clientes bilíngues. Pesquisa ServiceNow-AI
Agentes de voz têm desempenho ruim com clientes bilíngues. Isso foi demonstrado por uma pesquisa da equipe ServiceNow-AI, que testou sete sistemas populares de reconhecimento de fala em exemplos de…
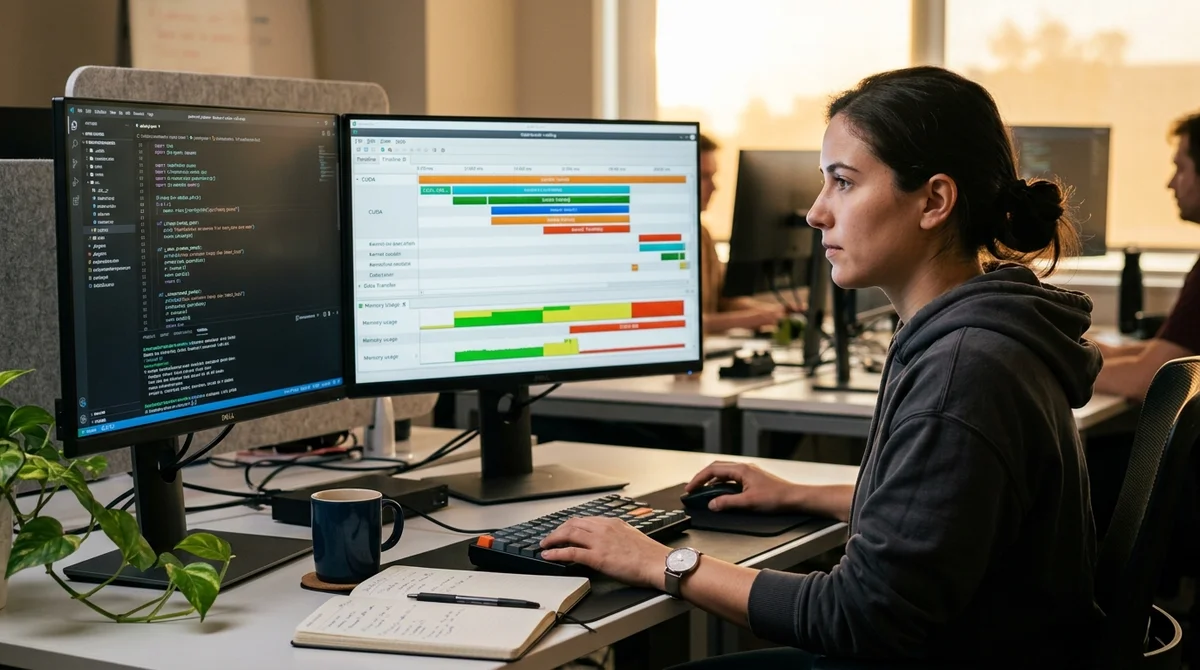
Como acelerar modelos PyTorch: guia prático do torch.profiler
Hugging Face falou sobre torch.profiler — ferramenta integrada do PyTorch para análise de desempenho. Ela ajuda a encontrar gargalos no treinamento e inferência de modelos.
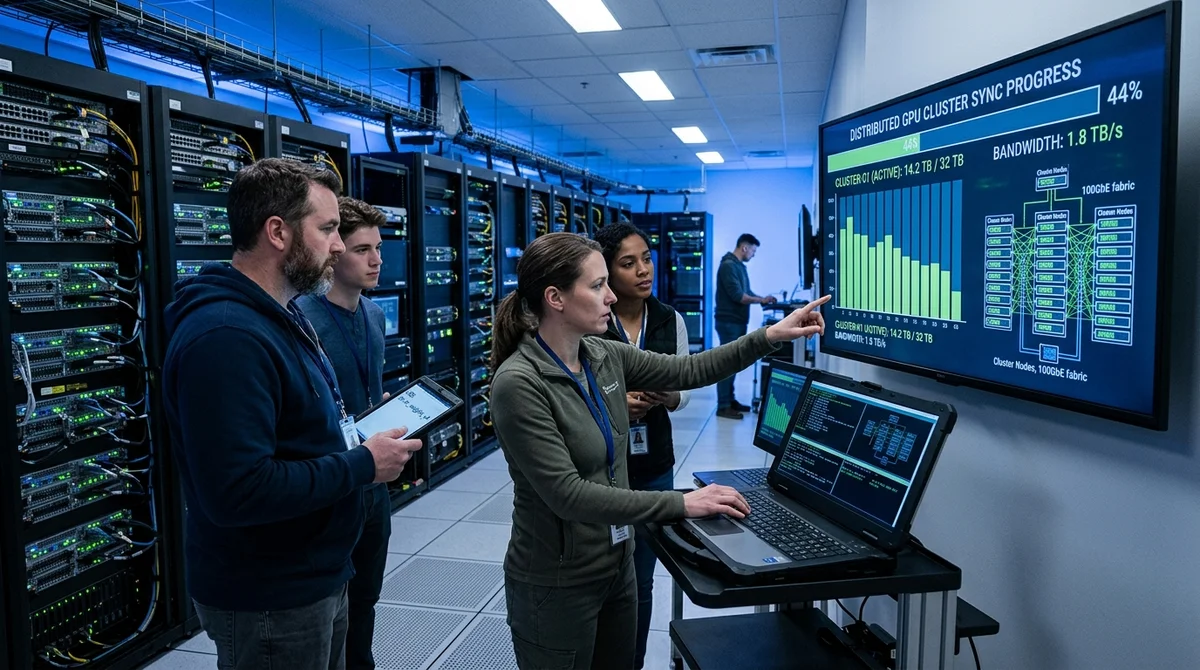
Hugging Face ensinou TRL a entregar um trilhão de parâmetros através de delta-pesos
Hugging Face adicionou Delta Weight Sync ao TRL — técnica que envia apenas mudanças de pesos em vez de arquivos completos, reduzindo dados em centenas de vezes no treinamento de modelos gigantes.