AllenAI Lança olmo-eval — Uma Plataforma para Avaliar LLMs Durante o Treinamento
AllenAI lançou olmo-eval — uma plataforma de avaliação para modelos de linguagem integrada diretamente no processo de treinamento. Em vez de testes finais — avaliação em cada checkpoint: você pode observar como mudanças no dataset ou ajustes de hiperparâmetros afetam os benchmarks em tempo real. A ferramenta é publicada no Hugging Face e se destina a pesquisadores que desejam que a avaliação seja parte do desenvolvimento, não um apêndice.
Processado por IA de Hugging Face Blog; editado por Hamidun News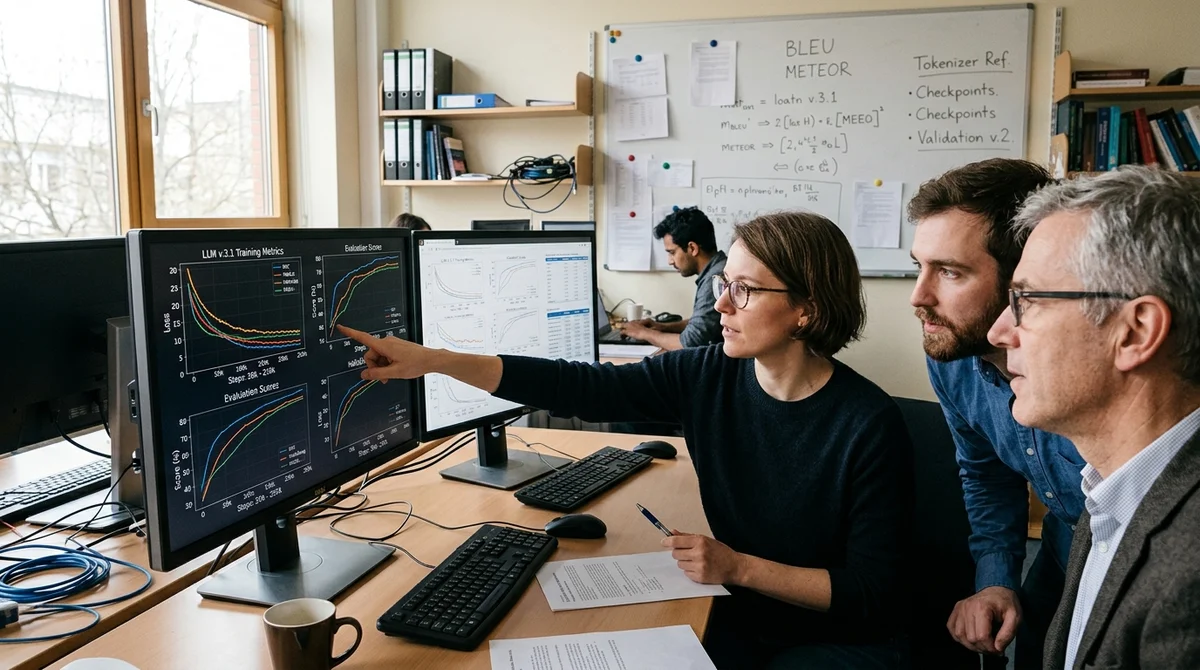
O grupo de pesquisa do Allen Institute for AI (AllenAI) lançou olmo-eval — um toolkit open-source para avaliar modelos de linguagem projetado especificamente para ser integrado ao ciclo de treinamento. O projeto está disponível no Hugging Face e destina-se a pesquisadores que desejam ver como um modelo muda durante o treinamento, e não apenas no final.
O Problema da Avaliação Final
O pipeline padrão de desenvolvimento de LLM funciona assim: um modelo treina por vários dias ou semanas, após o qual é executado por um conjunto de benchmarks — ARC, HellaSwag, MMLU e outros. Os resultados são registrados em uma tabela e entram em um artigo ou comunicado à imprensa. O problema é que nesse ponto já é tarde demais para mudar qualquer coisa. Se descobrir que o desempenho em tarefas de senso comum se degradou devido a uma mudança de conjunto de dados no meio do treinamento, essa descoberta é inútil: tudo já aconteceu. Os pesquisadores descartam a execução ou publicam o que obtiveram.
olmo-eval propõe uma lógica diferente: executar a avaliação não uma vez no final, mas em cada ponto de verificação salvo durante o treinamento. Então o desenvolvedor não vê um ponto final, mas uma curva de mudanças — e pode intervir a tempo.
O Que olmo-eval Pode Fazer
O toolkit é projetado para flexibilidade: ele aceita qualquer modelo do Hugging Face Hub ou um ponto de verificação local e o executa através de um conjunto selecionado de tarefas. Os resultados são automaticamente comparados com execuções anteriores.
- Suporte para benchmarks acadêmicos padrão: ARC, HellaSwag, MMLU, WinoGrande e outros
- Execução via CLI ou API Python sem configuração complexa
- Integração com sistemas de logging de experimentos
- Capacidade de adicionar tarefas de avaliação personalizadas
- Código totalmente open-source
O valor especial está na velocidade. olmo-eval é otimizado para execuções frequentes: a avaliação seletiva em um subconjunto de exemplos de teste oferece uma visão aproximada em minutos, não horas.
Papel no Ecossistema OLMo
AllenAI desenvolve a família de modelos de linguagem OLMo (Open Language Model), que difere fundamentalmente de outros projetos open-source: a organização publica não apenas os pesos, mas também dados de treinamento, código de treinamento e — agora — um sistema de avaliação. olmo-eval se tornou parte dessa pilha. A equipe o usou ao treinar versões recentes do OLMo: as avaliações foram executadas automaticamente em cada ponto de verificação e os resultados foram registrados junto com as métricas de perda.
"A avaliação deve ser parte do ciclo de desenvolvimento, não um ponto final" — este princípio
AllenAI incorpora na base do olmo-eval.
A abordagem reflete uma tendência mais ampla: laboratórios líderes usam há muito tempo avaliação contínua internamente, mas raramente divulgam detalhes. AllenAI disponibiliza essa infraestrutura para todos.
O Que Isso Significa
Para grupos acadêmicos e pesquisadores independentes, olmo-eval é uma infraestrutura de avaliação em nível empresarial sem restrições proprietárias. Integrar avaliação contínua ao ciclo de treinamento ficou significativamente mais fácil. Para o mercado como um todo, este é um sinal: a cultura de abertura do AllenAI se estende não apenas a dados e modelos, mas a todo o toolkit de pesquisa.
- 25 de out. de 2026Anthropic classifica o GLM-5.3 como grave ameaça cibernética e reacende a polêmica sobre modelos abertos
- 25 de out. de 2026Anthropic dá à METR acesso equivalente ao de funcionários para avaliar a segurança de seus sistemas
- 24 de out. de 2026Google abre o código do TorchTPU e dá ao PyTorch suporte nativo a TPUs
- 24 de out. de 2026Agentes de IA reduziram um ataque de duas semanas para dez horas: oito premissas de segurança ruíram
Perguntas frequentes sobre a notícia
O que se sabe sobre O Problema da Avaliação Final?
O pipeline padrão de desenvolvimento de LLM funciona assim: um modelo treina por vários dias ou semanas, após o qual é executado por um conjunto de benchmarks — ARC, HellaSwag, MMLU e outros. Os resultados são registrados em uma tabela e entram em um artigo ou comunicado à imprensa. O problema é que nesse ponto já é tarde demais para mudar qualquer coisa. Se descobrir que o desempenho em tarefas de senso comum se degradou devido a uma mudança de conjunto de dados no meio do treinamento, essa descoberta é inútil: tudo já aconteceu. Os pesquisadores descartam a execução ou pu
O Que olmo-eval Pode Fazer?
O toolkit é projetado para flexibilidade: ele aceita qualquer modelo do Hugging Face Hub ou um ponto de verificação local e o executa através de um conjunto selecionado de tarefas. Os resultados são automaticamente comparados com execuções anteriores. Suporte para benchmarks acadêmicos padrão: ARC, HellaSwag, MMLU, WinoGrande e outros Execução via CLI ou API Python sem configuração complexa Integração com sistemas de logging de experimentos Capacidade de adicionar tarefas de avaliação personalizadas Código totalmente open-source O valor especial está na velocidade. olmo-eva
O que se sabe sobre Papel no Ecossistema OLMo?
AllenAI desenvolve a família de modelos de linguagem OLMo (Open Language Model), que difere fundamentalmente de outros projetos open-source: a organização publica não apenas os pesos, mas também dados de treinamento, código de treinamento e — agora — um sistema de avaliação. olmo-eval se tornou parte dessa pilha. A equipe o usou ao treinar versões recentes do OLMo: as avaliações foram executadas automaticamente em cada ponto de verificação e os resultados foram registrados junto com as métricas de perda. "A avaliação deve ser parte do ciclo de desenvolvimento, não um ponto
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.