Reachy Mini aprendeu a conversar localmente sem nuvem
O robô Reachy Mini agora pode conversar completamente localmente. Toda a pilha — VAD, STT, LLM, TTS — funciona sem nuvem e API. Os usuários escolhem os modelos, sem custos de nuvem, privacidade total e controle sobre os dados.
Processado por IA de Hugging Face Blog; editado por Hamidun News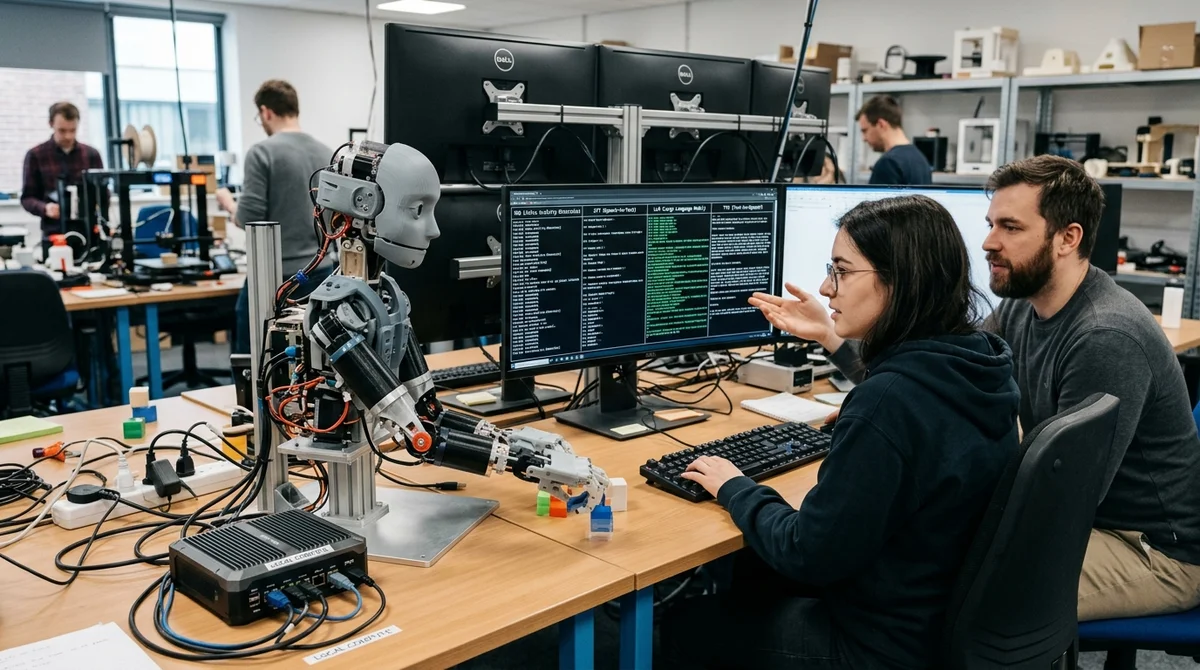
O robô humanóide Reachy Mini da Pollen Robotics agora pode funcionar completamente localmente. Toda a pilha de reconhecimento de fala — da voz à resposta — é executada no dispositivo local sem enviar dados para a nuvem. Este é o primeiro exemplo completo de como um robô de IA pode ser totalmente independente dos serviços em nuvem.
Como exatamente funciona a pilha local
O Reachy Mini usa um pipeline em cascata, onde cada componente passa seu resultado para o próximo no dispositivo local. A pessoa fala — VAD (Voice Activity Detection) detecta a fala, STT (Speech-to-Text) converte em texto, LLM processa o texto e gera uma resposta, então TTS (Text-to-Speech) verbaliza o resultado. Hugging Face forneceu um exemplo pronto com componentes abertos e API WebSocket, compatível com o padrão Realtime API, para que os desenvolvedores possam começar a usar imediatamente.
A execução requer apenas o mínimo: instalar um LLM local via llama.cpp, mlx (para Apple Silicon) ou outro framework, depois executar a biblioteca speech-to-speech. Tudo isso levará apenas alguns comandos no terminal.
O robô se conecta ao backend local através da interface do aplicativo.
Quais componentes estão na pilha
A pilha local consiste em quatro módulos, cada um dos quais pode ser substituído:
- VAD (Voice Activity Detection) — Silero VAD v5 detecta com precisão quando uma pessoa começou e terminou de falar, ignorando ruído de fundo
- STT (Speech-to-Text) — Parakeet-TDT 0.6B v3 converte fala em texto com latência mínima
- LLM (Language Model) — Gemma, Llama ou qualquer outro modelo de sua escolha, pode ser local ou em um servidor remoto
- TTS (Text-to-Speech) — Qwen3-TTS verbaliza a resposta do robô em tempo real
O desenvolvedor pode substituir qualquer componente. Por exemplo, se for necessário suporte a um idioma específico, encontre o melhor modelo STT para esse idioma. Se a tarefa requer velocidade máxima de resposta, otimize VAD e LLM para baixa latência.
Por que isso é importante para desenvolvedores e empresas
Antes, um robô de IA estava preso a um provedor em nuvem: qualquer que fosse o modelo que OpenAI ou Google usava, você usava aquele, pagava por cada minuto, e os dados eram enviados aos servidores da corporação. Agora essa limitação desaparecerá. A pilha local resolve três problemas-chave simultaneamente. Primeiro, privacidade: fluxos de áudio e texto nunca saem da rede local — isso é crítico para cenários de produção, medicina e ambientes corporativos. Segundo, economia: sem custos com APIs em nuvem, que podem ser substanciais em sessões longas. Terceiro, controle total: o usuário escolhe os modelos, pode mudá-los sem estar vinculado a um provedor em nuvem.
«Cascatas são a opção mais flexível no ecossistema de código aberto hoje», — escrevem os autores em um post do
Hugging Face, enfatizando que os componentes são facilmente combinados e substituídos.
O que isso significa para o futuro da robótica
Este é um passo importante na democratização da robótica de IA. Robôs humanóides estão se tornando não apenas serviços em nuvem com mecânica, mas sistemas independentes completos que qualquer um pode personalizar para suas tarefas. Os pesquisadores agora podem se concentrar em algoritmos e integração, em vez de infraestrutura em nuvem.
- 28 de out. de 2026Anthropic transforma o Claude Code em plataforma: Claude Mods invertem a lógica do harness do agente
- 28 de out. de 2026Liquid AI lança o LFM2.5-24B-A2B: um modelo para agentes com 2B de parâmetros ativos
- 28 de out. de 2026OpenAI lança Decisions API: decisões de agentes até 10 vezes mais rápidas
- 28 de out. de 2026Meta lança Muse Spark Open: 816B de parâmetros e liderança entre os modelos open-weight dos EUA
Perguntas frequentes sobre a notícia
Como exatamente funciona a pilha local?
O Reachy Mini usa um pipeline em cascata, onde cada componente passa seu resultado para o próximo no dispositivo local. A pessoa fala — VAD (Voice Activity Detection) detecta a fala, STT (Speech-to-Text) converte em texto, LLM processa o texto e gera uma resposta, então TTS (Text-to-Speech) verbaliza o resultado. Hugging Face forneceu um exemplo pronto com componentes abertos e API WebSocket, compatível com o padrão Realtime API, para que os desenvolvedores possam começar a usar imediatamente. A execução requer apenas o mínimo: instalar um LLM local via llama.cpp, mlx (para
O que se sabe sobre Quais componentes estão na pilha?
A pilha local consiste em quatro módulos, cada um dos quais pode ser substituído: VAD (Voice Activity Detection) — Silero VAD v5 detecta com precisão quando uma pessoa começou e terminou de falar, ignorando ruído de fundo STT (Speech-to-Text) — Parakeet-TDT 0.6B v3 converte fala em texto com latência mínima LLM (Language Model) — Gemma, Llama ou qualquer outro modelo de sua escolha, pode ser local ou em um servidor remoto TTS (Text-to-Speech) — Qwen3-TTS verbaliza a resposta do robô em tempo real O desenvolvedor pode substituir qualquer componente. Por exemplo, se for neces
Por que isso é importante para desenvolvedores e empresas?
Antes, um robô de IA estava preso a um provedor em nuvem: qualquer que fosse o modelo que OpenAI ou Google usava, você usava aquele, pagava por cada minuto, e os dados eram enviados aos servidores da corporação. Agora essa limitação desaparecerá. A pilha local resolve três problemas-chave simultaneamente. Primeiro, privacidade: fluxos de áudio e texto nunca saem da rede local — isso é crítico para cenários de produção, medicina e ambientes corporativos. Segundo, economia: sem custos com APIs em nuvem, que podem ser substanciais em sessões longas. Terceiro, controle total: o
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.