Como acelerar modelos PyTorch: guia prático do torch.profiler
A Hugging Face publicou a primeira parte de seu guia sobre o torch.profiler, ferramenta de análise de desempenho embutida no PyTorch. Ela rastreia cada operação na GPU e na CPU, expõe gargalos nos cálculos e ajuda a reduzir o tempo de treinamento dos modelos. O guia é útil para engenheiros de ML e pesquisadores que querem entender para onde vai o poder computacional e acelerar seus projetos.
Processado por IA de Hugging Face Blog; editado por Hamidun News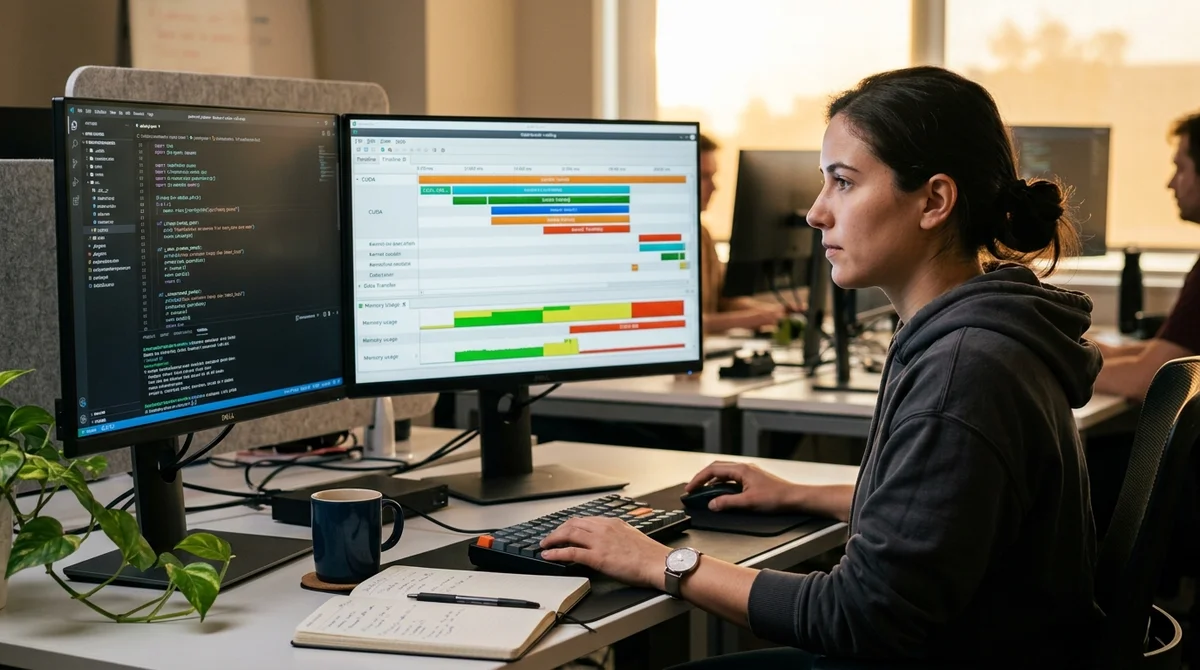
O PyTorch inclui uma ferramenta nativa, o torch.profiler, para analisar o desempenho de modelos. Ela rastreia cada operação na GPU e na CPU, ajudando a achar gargalos nos cálculos e a otimizar o tempo de treinamento.
Por que fazer profiling dos modelos
Sem profiling, o desenvolvedor vê apenas o número final: "a época treinou por 2 horas". Mas por que 2 horas? Onde o tempo foi parar? Será que o dataloader está lento? Ou alguma operação na GPU é ineficiente? Ou a GPU fica ociosa esperando dados da CPU?
Otimizar às cegas é chute. Você muda o batch size, a velocidade de carregamento, a precisão dos cálculos, e o resultado não melhora, porque você está otimizando o gargalo errado. O torch.profiler evita esse desperdício de tempo: mostra a distribuição exata de tempo e memória por operação.
Como o torch.profiler funciona
A ferramenta rastreia a execução do código no nível dos kernels CUDA e das threads de CPU. Para cada operação, como a multiplicação de matrizes em uma camada Linear ou a convolução em Conv2d, ela registra o horário de início, o de término e a memória usada. Os resultados podem ser exportados em um formato compatível com o Chrome DevTools e visualizados como timeline.
As principais métricas do profiler:
- Exclusive time: tempo que a operação levou por conta própria (sem as operações aninhadas)
- Inclusive time: tempo da operação junto com todas as chamadas aninhadas
- Memory: pico de uso de memória da GPU durante a operação
- Sync time: tempo gasto na sincronização entre CPU e GPU (o gargalo número um)
Quando o torch.profiler revela problemas
Um cenário típico: o modelo treina devagar, você acha que precisa de uma GPU mais rápida, mas o profiler mostra que 60% do tempo da época é espera por dados do dataloader. O problema não está na GPU, e sim no carregamento de dados. A solução: aumentar num_workers no DataLoader ou usar pinned memory.
Outro exemplo: o modelo treina em um sistema distribuído (várias GPUs), e o profiler mostra que muito tempo vai para a sincronização de gradientes entre dispositivos. É um sinal para otimizar o grafo de comunicação ou rever a estratégia de paralelismo.
Um esclarecimento importante: o próprio profiling adiciona overhead. Se você rodar o profiler em todo o ciclo de treinamento, ele pode desacelerar os cálculos em 10–30%. Para medições precisas, é melhor fazer profiling apenas do bloco de código de interesse (por exemplo, uma passada forward-backward).
O que isso significa
O torch.profiler é o primeiro passo antes de qualquer otimização. Não adivinhe onde está o gargalo: faça o profiling, analise os resultados e otimize exatamente o que está travando. Isso pode poupar semanas de experimentos e direcionar o esforço para onde ele realmente trará resultado. Para engenheiros de ML que querem acelerar o treinamento de modelos, é uma ferramenta básica.
- 22 de nov. de 2026Grant do Yandex foi para um motor de LLM: modelo de 35B na RTX 2080 Ti é três vezes mais rápido que o llama.cpp
- 22 de nov. de 2026Ações da Nvidia caem 14% na sexta-feira e 46% em sete semanas, perda de US$ 2,6 trilhões
- 22 de nov. de 2026SEC investiga a contabilidade da Nvidia: ações caem 14% em um único dia
- 22 de nov. de 2026Nasdaq 100 cai 10,4% em uma semana: pior desempenho desde a pandemia
Perguntas frequentes sobre a notícia
Por que fazer profiling dos modelos?
Sem profiling, o desenvolvedor vê apenas o número final: "a época treinou por 2 horas". Mas por que 2 horas? Onde o tempo foi parar? Será que o dataloader está lento? Ou alguma operação na GPU é ineficiente? Ou a GPU fica ociosa esperando dados da CPU? Otimizar às cegas é chute. Você muda o batch size, a velocidade de carregamento, a precisão dos cálculos, e o resultado não melhora, porque você está otimizando o gargalo errado.
Como o torch.profiler funciona?
A ferramenta rastreia a execução do código no nível dos kernels CUDA e das threads de CPU. Para cada operação, como a multiplicação de matrizes em uma camada Linear ou a convolução em Conv2d, ela registra o horário de início, o de término e a memória usada. Os resultados podem ser exportados em um formato compatível com o Chrome DevTools e visualizados como timeline.
Quando o torch.profiler revela problemas?
Um cenário típico: o modelo treina devagar, você acha que precisa de uma GPU mais rápida, mas o profiler mostra que 60% do tempo da época é espera por dados do dataloader. O problema não está na GPU, e sim no carregamento de dados. A solução: aumentar num_workers no DataLoader ou usar pinned memory. Outro exemplo: o modelo treina em um sistema distribuído (várias GPUs), e o profiler mostra que muito tempo vai para a sincronização de gradientes entre dispositivos.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.