Russo custa o dobro no ChatGPT, e a culpa é da tokenização
No ChatGPT e em outros LLMs na nuvem, um texto em russo custa 2 vezes mais que o mesmo conteúdo em inglês. A culpa é de como as redes neurais dividem o texto em tokens. Uma palavra em inglês costuma virar um único token, enquanto uma palavra em russo exige 2-4 pedaços. Com isso, a janela de contexto encolhe pela metade.
Processado por IA de Habr AI; editado por Hamidun News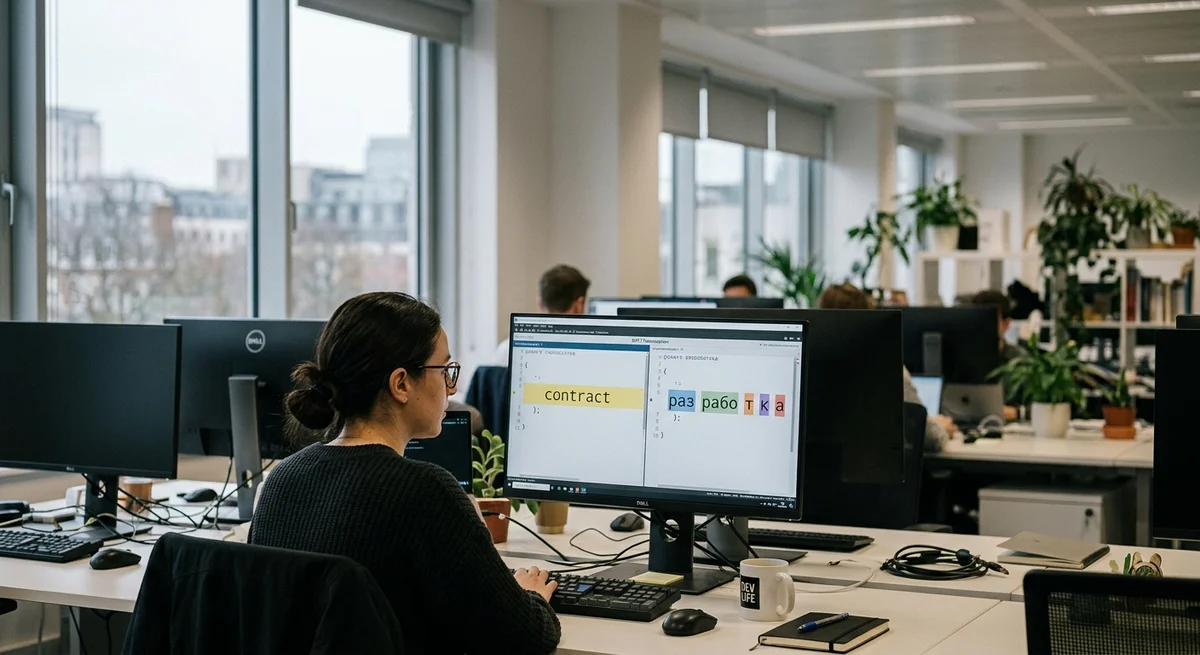
Quando você envia um prompt ao ChatGPT ou a outra rede neural na nuvem, ela não trabalha diretamente com letras e palavras. Primeiro, o texto é dividido em tokens, pequenos fragmentos de significado que o modelo consegue processar. Essa divisão define o custo da requisição, a velocidade da resposta e quanta informação cabe na janela de contexto de uma só vez.
Como funciona a tokenização
Tokenização é o processo de fatiar o texto, e cada rede neural faz isso de um jeito diferente. O inglês é fatiado de forma muito eficiente: uma palavra costuma ocupar um ou dois tokens. A palavra «contract» é sempre um único token. Um texto em inglês de 1000 palavras exige cerca de 1200-1500 tokens.
O russo não tem a mesma sorte: o mesmo conteúdo exige 2-3 vezes mais pedaços. A palavra «разработка» (desenvolvimento) consome dois ou três tokens. «Программирование» (programação), três ou quatro. Já um adjetivo como «искусственный» (artificial) pode ocupar quatro ou cinco tokens. Um texto em russo de 1000 palavras já exige 2500-3500 tokens.
Isso acontece porque o inglês foi usado de forma muito mais intensa que o russo no treinamento dos grandes modelos de linguagem atuais. Seu vocabulário está mais bem representado no dicionário de tokens, que os criadores dos modelos montaram a partir de enormes volumes de conteúdo em inglês. Para as redes neurais, o cirílico continua sendo um estrangeiro.
Quanto isso custa na prática
Por causa dessa desigualdade na tokenização, texto em russo em serviços na nuvem como os da OpenAI sai cerca de 2 vezes mais caro que texto em inglês com o mesmo volume real de informação. Se você paga 1 dólar para processar 1000 tokens de texto em inglês, o russo vai custar 2 dólares.
O efeito fica mais evidente em projetos grandes: localizar um aplicativo para o russo, traduzir documentação ou manter um chatbot em russo custa o dobro dos mesmos serviços para um usuário de língua inglesa.
Mas o preço mais alto é só o começo. O processamento de texto em russo é visivelmente mais lento, porque o modelo precisa passar por mais tokens. Quanto mais tokens, mais demora a resposta. E a janela de contexto, o espaço de memória em que o modelo consegue reter informação, fica com metade do tamanho em conteúdo real. Se um modelo tem janela de contexto de 128 mil tokens, em russo você só consegue encaixar metade da informação.
Quem sai mais prejudicado
- Desenvolvedores de língua russa que usam AI para trabalhar com documentação e código
- Empresas que processam grandes volumes de texto em russo (traduções, chatbots, análise de dados)
- Startups de língua russa que constroem produtos sobre LLMs e não podem arcar com os custos da OpenAI
- Pesquisadores que trabalham com o idioma russo e precisam de análises aprofundadas via redes neurais
- Autores e editoras que querem usar AI para editar e reescrever textos
Como medir com seus próprios dados
O autor do artigo recomenda verificar a proporção real de tokens para os seus textos específicos: pegue uma amostra em inglês e em russo, conte os tokens pela API da OpenAI e compare. Isso leva uns cinco minutos e mostra o custo exato do seu caso.
O que isso significa
A desigualdade na tokenização é um imposto oculto sobre o idioma russo na era dos grandes modelos de linguagem. Não se trata de um erro dos desenvolvedores, e sim de uma consequência natural de como esses modelos foram construídos: com base no conteúdo em inglês da primeira geração da internet.
Para a comunidade de língua russa, isso significa aceitar a realidade: ou pagar mais e receber respostas mais lentas, ou buscar alternativas treinadas com melhor suporte ao cirílico.
- 1 de nov. de 2026OpenAI reescreve as regras de comportamento do GPT: cinco valores e uma cadeia de prioridades
- 1 de nov. de 2026Google admite que o AI Mode reduz a receita da Busca; ações caem 15%
- 31 de out. de 2026Autor leva roteiro a julgamento por jurados de IA, e o veredito custa 850 mil tokens
- 31 de out. de 2026Anthropic: unir subagentes em um único loop deixou as tarefas de um cliente duas vezes mais rápidas
Perguntas frequentes sobre a notícia
Como funciona a tokenização?
Tokenização é o processo de fatiar o texto, e cada rede neural faz isso de um jeito diferente. O inglês é fatiado de forma muito eficiente: uma palavra costuma ocupar um ou dois tokens. A palavra «contract» é sempre um único token. Um texto em inglês de 1000 palavras exige cerca de 1200-1500 tokens. O russo não tem a mesma sorte: o mesmo conteúdo exige 2-3 vezes mais pedaços. A palavra «разработка» (desenvolvimento) consome dois ou três tokens. «Программирование» (programação), três ou quatro. Já um adjetivo como «искусственный» (artificial) pode ocupar quatro ou cinco toke
O que se sabe sobre Quanto isso custa na prática?
Por causa dessa desigualdade na tokenização, texto em russo em serviços na nuvem como os da OpenAI sai cerca de 2 vezes mais caro que texto em inglês com o mesmo volume real de informação. Se você paga 1 dólar para processar 1000 tokens de texto em inglês, o russo vai custar 2 dólares. O efeito fica mais evidente em projetos grandes: localizar um aplicativo para o russo, traduzir documentação ou manter um chatbot em russo custa o dobro dos mesmos serviços para um usuário de língua inglesa. Mas o preço mais alto é só o começo. O processamento de texto em russo é visivelmente
O que se sabe sobre Quem sai mais prejudicado?
Desenvolvedores de língua russa que usam AI para trabalhar com documentação e código Empresas que processam grandes volumes de texto em russo (traduções, chatbots, análise de dados) Startups de língua russa que constroem produtos sobre LLMs e não podem arcar com os custos da OpenAI Pesquisadores que trabalham com o idioma russo e precisam de análises aprofundadas via redes neurais Autores e editoras que querem usar AI para editar e reescrever textos
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.