MELT-1: como a Metabolic AI testa a sobrevivência de agentes
O Habr publicou um artigo sobre o MELT-1, um benchmark que não mede MMLU, mas quanto tempo um agente de IA sobrevive sob drift de distribuição. A Metabolic AI obteve resultado 1600 vezes melhor que o Llama-7B INT8 na tarefa de manipulação. O benchmark é aberto: cenários, oráculo e código estão disponíveis.
Processado por IA de Habr AI; editado por Hamidun News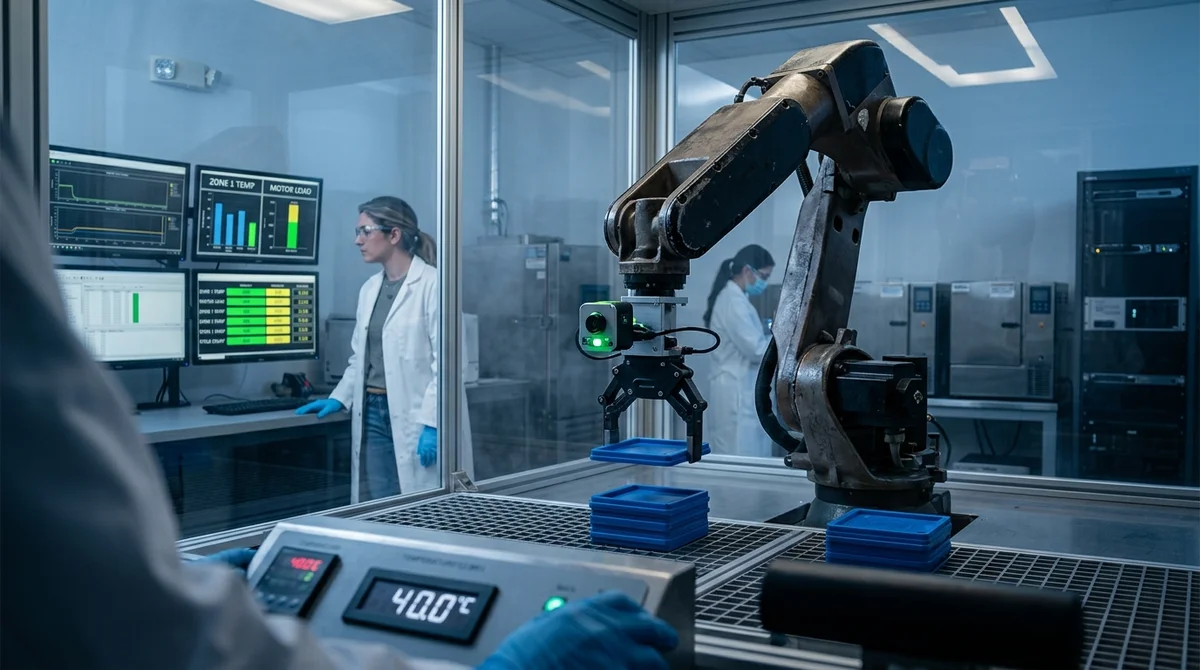
O MELT-1 não é o MMLU nem o MMLU Pro. É um novo benchmark aberto para testar agentes de IA em condições reais: não mede "o que o modelo sabe", mas "quantas horas ele sobrevive quando tudo ao redor muda".
Três eixos em vez de um único número
Os benchmarks tradicionais (MMLU, ARC, GPQA) pressupõem condições ideais: perguntas estáticas e distribuição de dados estável. O MELT-1 mede três coisas ao mesmo tempo:
- Economia da computação: quanto custa manter um agente em operação real ($/1M de decisões bem-sucedidas)
- Sobrevivência sob drift: quantas horas o agente funciona sem retreinamento antes de começar a errar
- Latência sob estresse: tempo p99 do sensor ao atuador a uma temperatura de 40°C
O teste dura 30 dias de inferência contínua, com 5 seeds e dois perfis de temperatura. Não é um teste de laboratório: é um cenário em que um robô de verdade precisa trabalhar de dia e de noite, no verão e no inverno.
Resultados: diferença de 1600×
Em manipulação em malha fechada (um robô pega e organiza objetos), a Metabolic AI, uma arquitetura sem transformer, superou um modelo da classe Llama de 7B INT8 em 9,4 vezes no custo e em 8,5 vezes na sobrevivência sob drift. No composto: 1600×. Não é porque o Llama seja ruim. É porque os transformers de 7B foram projetados para recuperação de conhecimento estático, não para um agente incorporado que precisa ficar ativo 24/7.
"Transformers morrem em 11 horas sob drift", escrevem os autores.
Abertura como padrão
A arquitetura da Metabolic AI é fechada (a patente está em exame), mas o benchmark é totalmente aberto: harness, cenas de teste, oráculo, scripts de sensibilidade e um codificador VAE de drift para reprodução. A metodologia está em um PDF com uma seção sobre ameaças à validade. Os pesquisadores convidam outros a rodar seus próprios agentes e colocar os resultados lado a lado.
É assim que a ciência de deep learning deveria ser feita: propriedade intelectual fechada, benchmarks abertos e reprodutibilidade por meio de código.
O que isso significa
O MELT-1 pode se tornar um novo padrão para robótica e IA incorporada. O MMLU mostra se um modelo é "inteligente". O MELT-1 mostra se ele é "resistente".
- 2 de nov. de 2026Assistente Muse, da Meta, mantém dossiê sobre pessoas próximas e recebe root no Ubuntu por padrão
- 2 de nov. de 2026Jornalista da The Verge monta um rival do Meta Muse Charm por $50 com ajuda do Claude Code
- 1 de nov. de 2026Camada de proteção MoneyGate barrou os 42 pedidos fraudulentos feitos a IAs locais
- 31 de out. de 2026Gateway de LLM open source KTMS 1.0 conecta GPUs próprias à nuvem e sobrevive a falhas
Perguntas frequentes sobre a notícia
O que se sabe sobre Três eixos em vez de um único número?
Os benchmarks tradicionais (MMLU, ARC, GPQA) pressupõem condições ideais: perguntas estáticas e distribuição de dados estável. O MELT-1 mede três coisas ao mesmo tempo: Economia da computação: quanto custa manter um agente em operação real ($/1M de decisões bem-sucedidas) Sobrevivência sob drift: quantas horas o agente funciona sem retreinamento antes de começar a errar Latência sob estresse: tempo p99 do sensor ao atuador a uma temperatura de 40°C O teste dura 30 dias de inferência contínua, com 5 seeds e dois perfis de temperatura. Não é um teste de laboratório: é um cená
O que se sabe sobre Resultados: diferença de 1600×?
Em manipulação em malha fechada (um robô pega e organiza objetos), a Metabolic AI, uma arquitetura sem transformer, superou um modelo da classe Llama de 7B INT8 em 9,4 vezes no custo e em 8,5 vezes na sobrevivência sob drift. No composto: 1600×. Não é porque o Llama seja ruim. É porque os transformers de 7B foram projetados para recuperação de conhecimento estático, não para um agente incorporado que precisa ficar ativo 24/7. "Transformers morrem em 11 horas sob drift", escrevem os autores.
O que se sabe sobre Abertura como padrão?
A arquitetura da Metabolic AI é fechada (a patente está em exame), mas o benchmark é totalmente aberto: harness, cenas de teste, oráculo, scripts de sensibilidade e um codificador VAE de drift para reprodução. A metodologia está em um PDF com uma seção sobre ameaças à validade. Os pesquisadores convidam outros a rodar seus próprios agentes e colocar os resultados lado a lado. É assim que a ciência de deep learning deveria ser feita: propriedade intelectual fechada, benchmarks abertos e reprodutibilidade por meio de código.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.