Como o BERTopic com LLM local ajuda a Rostelecom a analisar grandes volumes de texto
Um desenvolvedor de NLP da Rostelecom apresentou um pipeline de BERTopic que automatiza por completo a análise de grandes volumes de texto: avaliações, chamados de suporte, comentários e redes sociais. A melhoria principal é um modelo de linguagem local integrado, que gera nomes de tópicos interpretáveis sem enviar dados para a nuvem, preservando a confidencialidade. Na prática, o método reduz o trabalho manual de várias semanas para poucas horas.
Processado por IA de Habr AI; editado por Hamidun News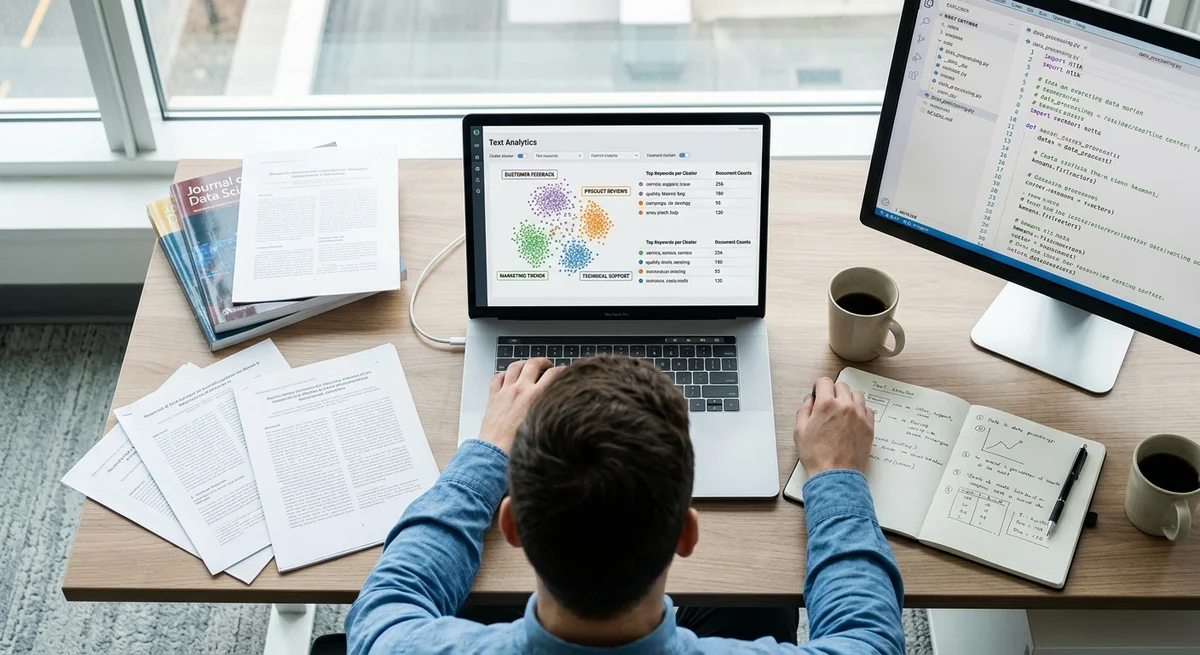
Automatizar a análise de textos é uma das tarefas mais trabalhosas e subestimadas em NLP. Quando uma empresa recebe dezenas de milhares de avaliações, chamados de suporte ou comentários por dia, a categorização manual não é apenas impossível, mas também sem sentido do ponto de vista do ROI. Anton, engenheiro de NLP da Rostelecom, propôs uma solução: um pipeline baseado em BERTopic com um LLM local integrado para obter nomes de tópicos interpretáveis.
Por que automatizar a análise de textos
Grandes volumes de texto são uma mina de ouro de dados não estruturados para qualquer empresa. Nas avaliações estão escondidas reclamações sobre bugs e falhas específicas, nos chamados de suporte aparecem problemas sistêmicos e pontos fracos, e nos comentários de redes sociais há ideias para novos recursos e produtos. Mas nem uma equipe pequena de analistas consegue destrinchar tudo isso manualmente em um dia ou em uma semana.
A abordagem clássica é ler cada texto manualmente, entender a essência e distribuir por categorias. Com volumes de 10.000 textos ou mais, isso se torna economicamente inviável, exaustivo para o especialista e demorado. Soma-se a isso a subjetividade: um analista classifica a reclamação como "problemas de rede", outro como "qualidade do serviço" e um terceiro como "outros". A consistência se perde e as conclusões deixam de ser confiáveis.
Como o BERTopic resolve o problema de clusterização
O BERTopic é um framework que combina várias técnicas de aprendizado de máquina para encontrar tópicos em textos automaticamente. O processo funciona assim:
- Embeddings (BERT): cada texto é convertido em um vetor de números (embedding), em que textos semanticamente parecidos ficam próximos em um espaço multidimensional. Para texto em russo, é possível usar o ruBERT ou outros modelos.
- Clusterização (HDBSCAN): um algoritmo rápido encontra agrupamentos naturais de textos nesse espaço, sem exigir que se saiba de antemão o número de tópicos.
- Interpretação: o BERTopic gera o nome de cada cluster com base em TF-IDF, as palavras mais significativas do grupo.
O resultado? Do caos de 50.000 textos saem, por exemplo, 15 tópicos claros e naturais: "problemas com a internet", "dúvidas sobre cobrança", "bugs no aplicativo móvel", "pedidos de benefícios" e assim por diante.
Mas há um porém. A interpretação padrão do BERTopic costuma gerar nomes estranhos como "абонент_услуга_номер" ou "бага_баг_ошибка" (algo como "assinante_serviço_número" e "falha_bug_erro"), difíceis de explicar para o negócio. É aqui que entra o modelo de linguagem.
Integrando um LLM local para a interpretação
Em vez de escolher palavras do cluster de forma mecânica, um modelo de linguagem local (por exemplo, Mistral 7B ou Llama 2) lê as principais palavras e os principais documentos do cluster e gera uma descrição completa em russo: "Clientes reclamam da lentidão da internet em áreas rurais, principalmente nos fins de semana".
"Integrar um LLM local protege a confidencialidade dos dados: todos os dados atuais ficam dentro da empresa, sem envio para a OpenAI, a API do Claude ou outros serviços de nuvem.
Isso é crítico para empresas que trabalham com informações sensíveis", destaca Anton.
Além disso, o modelo local é mais rápido que requisições de API e totalmente independente de cotas, limites e do custo por token processado. O pipeline funciona sem internet, o que reduz a latência e aumenta a confiabilidade do sistema.
Resultado prático e escala
O pipeline da Rostelecom permite fazer em poucas horas o que antes levava várias semanas de trabalho manual:
1. Carregar um conjunto de textos no BERTopic (podem ser milhares ou dezenas de milhares de registros) 2. Obter clusters prontos com descrições de tópicos geradas pelo LLM, em linguagem compreensível para o negócio 3. Exportar os resultados para Excel, CSV ou banco de dados, para continuidade do trabalho de analistas e product managers
Há ainda a possibilidade de reutilização: chegou um novo lote no suporte? O pipeline é retreinado em minutos e entrega de novo um resultado estruturado.
O que isso significa para a indústria de NLP
As ferramentas de NLP estão saindo do laboratório e dos artigos científicos para a produção real. Quando um único engenheiro consegue montar em um dia um pipeline completo que antes exigia de duas a três semanas de trabalho manual e a experiência de uma equipe inteira, o NLP se torna uma ferramenta prática, e não um experimento científico acessível apenas a grandes empresas de TI.
- 1 de nov. de 2026Modelos locais perdem para Opus e Codex: 0,21 ponto no MacBook contra 1,00 do Codex
- 1 de nov. de 2026Kimi marca 96,2% em teste de análise em base 1C e vira reserva caso o Claude seja bloqueado
- 1 de nov. de 2026OpenAI reescreve as regras de comportamento do GPT: cinco valores e uma cadeia de prioridades
- 1 de nov. de 2026Google admite que o AI Mode reduz a receita da Busca; ações caem 15%
Perguntas frequentes sobre a notícia
Por que automatizar a análise de textos?
Grandes volumes de texto são uma mina de ouro de dados não estruturados para qualquer empresa. Nas avaliações estão escondidas reclamações sobre bugs e falhas específicas, nos chamados de suporte aparecem problemas sistêmicos e pontos fracos, e nos comentários de redes sociais há ideias para novos recursos e produtos. Mas nem uma equipe pequena de analistas consegue destrinchar tudo isso manualmente em um dia ou em uma semana. A abordagem clássica é ler cada texto manualmente, entender a essência e distribuir por categorias. Com volumes de 10.000 textos ou mais, isso se tor
Como o BERTopic resolve o problema de clusterização?
O BERTopic é um framework que combina várias técnicas de aprendizado de máquina para encontrar tópicos em textos automaticamente. O processo funciona assim: Embeddings (BERT): cada texto é convertido em um vetor de números (embedding), em que textos semanticamente parecidos ficam próximos em um espaço multidimensional. Para texto em russo, é possível usar o ruBERT ou outros modelos. Clusterização (HDBSCAN): um algoritmo rápido encontra agrupamentos naturais de textos nesse espaço, sem exigir que se saiba de antemão o número de tópicos. Interpretação: o BERTopic gera o nome
O que se sabe sobre Integrando um LLM local para a interpretação?
Em vez de escolher palavras do cluster de forma mecânica, um modelo de linguagem local (por exemplo, Mistral 7B ou Llama 2) lê as principais palavras e os principais documentos do cluster e gera uma descrição completa em russo: "Clientes reclamam da lentidão da internet em áreas rurais, principalmente nos fins de semana". "Integrar um LLM local protege a confidencialidade dos dados: todos os dados atuais ficam dentro da empresa, sem envio para a OpenAI, a API do Claude ou outros serviços de nuvem. Isso é crítico para empresas que trabalham com informações sensíveis", destac
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.