KDnuggets publica guia de análise local de chamadas com Whisper, BERTopic e Streamlit
O KDnuggets mostrou como montar um analisador local de ligações de clientes sem APIs na nuvem. A combinação usa Whisper para transcrever o áudio, RoBERTa do Hugging Face para sentimento e emoções, BERTopic para os temas e Streamlit para o painel. O projeto roda na própria máquina e exige Python 3.9+, FFmpeg e cerca de 1,5–2 GB para os modelos.
Processado por IA de KDnuggets; editado por Hamidun News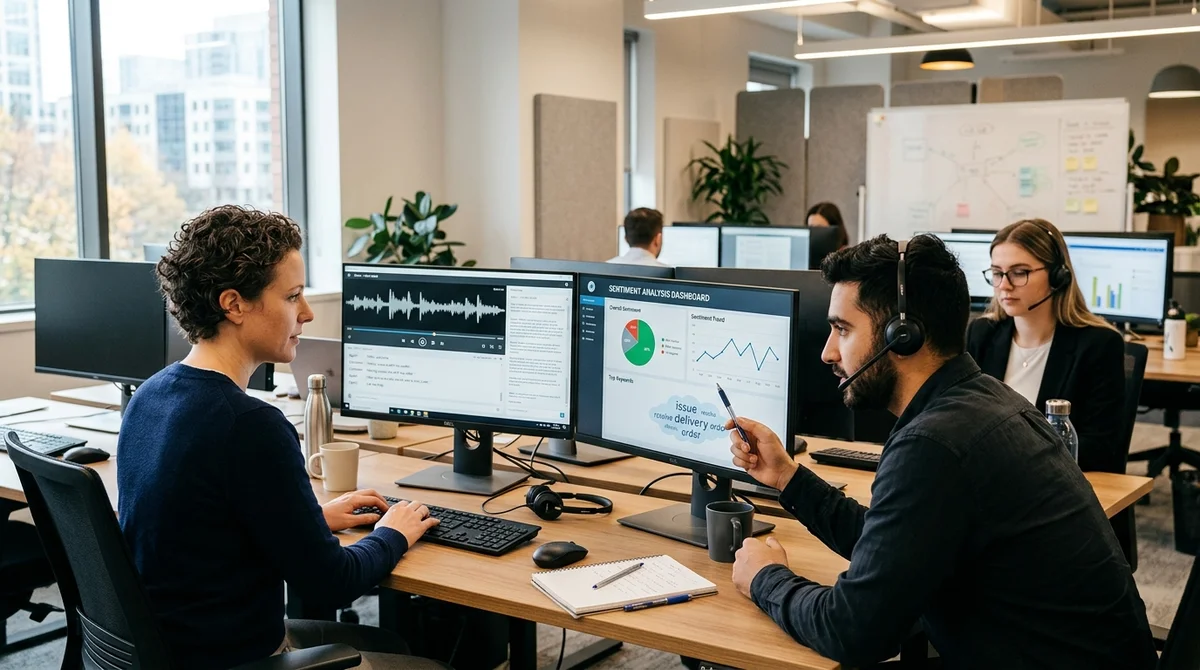
Em 17 de abril de 2026, o KDnuggets publicou uma análise passo a passo de uma ferramenta open source para analisar ligações de clientes. O projeto monta um pipeline local: o Whisper transcreve o áudio, modelos do Transformers identificam sentimento e emoções, e o BERTopic encontra temas recorrentes sem enviar as gravações para APIs externas.
Como funciona a stack
O material gira em torno de um esquema modular simples, que dá para reproduzir em uma máquina comum. Primeiro, o Whisper transforma a gravação da ligação em texto e a divide em segmentos com marcações de tempo. O autor usa a versão base ou small do modelo como meio-termo entre velocidade e qualidade.
Depois, a transcrição segue para o modelo cardiffnlp/twitter-roberta-base-sentiment-latest, que calcula as probabilidades de positive, neutral e negative e em seguida gera um rótulo final e uma pontuação compound de menos um a mais um. Na sequência, o BERTopic agrupa as conversas por significado e extrai temas-chave, como problemas de cobrança, entrega ou suporte técnico.
Em separado, o autor explica por que tema e sentimento resolvem problemas diferentes. O sentimento responde se a experiência foi boa ou ruim, enquanto as emoções mostram o que exatamente o cliente sente: irritação, urgência, satisfação. Para os temas, usa-se uma combinação de sentence-transformers, UMAP, HDBSCAN e c-TF-IDF.
Um detalhe prático importante: a extração de temas não funciona bem com uma única ligação, mas com um conjunto de pelo menos cinco a dez transcrições, no qual já aparecem padrões repetidos.
Por que rodar localmente
A ideia central do artigo não é fazer mais um projeto de demonstração de NLP, mas mostrar um cenário corporativo útil, sem depender de APIs na nuvem. Para call centers, isso se resume a privacidade, custo e requisitos de armazenamento de dados. Após o primeiro download dos modelos, que ocupa cerca de 1,5 GB, o sistema pode funcionar offline. Para começar, são necessários Python 3.9+, FFmpeg para processar o áudio e cerca de 2 GB de espaço em disco, ou seja, a barreira de entrada é bem baixa, mesmo para uma equipe pequena.
"A principal vantagem é que tudo funciona localmente, e os dados
sensíveis dos clientes não saem da sua máquina."
O artigo apresenta isso como um argumento não só de segurança, mas também de previsibilidade de custos. Não há cobrança por chamada de API, nem limites do provedor, nem o risco de ter que entregar mais uma gravação de cliente a uma infraestrutura externa.
O autor também compara os transformers com métodos mais antigos baseados em dicionários, como o VADER: modelos simples podem errar em frases com negação, enquanto o transformer entende melhor o contexto da fala coloquial, o que é especialmente importante em reclamações reais e formulações ambíguas.
O que o painel mostra
A camada final do projeto é uma interface em Streamlit com gráficos do Plotly, voltada não para o engenheiro de ML, mas para um gerente ou analista. Por ela, é possível enviar vários arquivos mp3 ou wav, aguardar o processamento e ver na hora um resumo das ligações. Para ganhar velocidade, há cache de recursos, de modo que os modelos pesados não sejam recarregados a cada ação na interface.
O projeto prevê vários modos de execução: demo sem áudio, análise de um único arquivo, processamento em lote de um diretório e o painel completo no navegador.
- Upload de arquivos de áudio e processamento em lote
- Transcrição com destaque de sentimento
- Linha do tempo de emoções para conversas longas
- Visualização de temas e distribuição das ligações por clusters
- Acesso direto a uma conversa específica
Na prática, é uma base pronta para serviços internos de suporte, análise de produto e controle de qualidade de operadores. Uma equipe pode pegar o repositório, trocar os dados de entrada, refinar ou substituir os modelos e rapidamente obter uma ferramenta aplicada, em vez de um notebook abstrato. É isso que dá valor ao artigo: ele não discute o futuro dos sistemas agênticos, mas mostra um cenário concreto e reproduzível em que uma stack open source já resolve um problema de negócio.
O que isso significa
Publicações assim mostram a rapidez com que as ferramentas de IA saem do campo dos experimentos e entram na prática das equipes de operações. Se antes a análise de ligações costumava exigir um serviço SaaS e processamento externo de dados, agora é possível montar um sistema básico localmente, de forma transparente e sem grandes orçamentos de API.
- 1 de nov. de 2026Juiz do EditAgent, da Adobe, escolhe uma edição aceitável em 81,3% dos casos, contra 74,8% do EditScore
- 1 de nov. de 2026Teste com 16 modelos em 7 buscadores: Exa fez em média 10,5 pontos de 14; SearXNG, cerca de 3
- 1 de nov. de 2026Camada de proteção MoneyGate barrou os 42 pedidos fraudulentos feitos a IAs locais
- 1 de nov. de 2026Tokenizador do BERT na Hugging Face fica 50 vezes mais rápido ao eliminar trabalho desnecessário com ASCII
Perguntas frequentes sobre a notícia
Como funciona a stack?
O material gira em torno de um esquema modular simples, que dá para reproduzir em uma máquina comum. Primeiro, o Whisper transforma a gravação da ligação em texto e a divide em segmentos com marcações de tempo. O autor usa a versão base ou small do modelo como meio-termo entre velocidade e qualidade. Depois, a transcrição segue para o modelo cardiffnlp/twitter-roberta-base-sentiment-latest, que calcula as probabilidades de positive, neutral e negative e em seguida gera um rótulo final e uma pontuação compound de menos um a mais um. Na sequência, o BERTopic agrupa as convers
Por que rodar localmente?
A ideia central do artigo não é fazer mais um projeto de demonstração de NLP, mas mostrar um cenário corporativo útil, sem depender de APIs na nuvem. Para call centers, isso se resume a privacidade, custo e requisitos de armazenamento de dados. Após o primeiro download dos modelos, que ocupa cerca de 1,5 GB, o sistema pode funcionar offline. Para começar, são necessários Python 3.9+, FFmpeg para processar o áudio e cerca de 2 GB de espaço em disco, ou seja, a barreira de entrada é bem baixa, mesmo para uma equipe pequena. "A principal vantagem é que tudo funciona localmente
O que o painel mostra?
A camada final do projeto é uma interface em Streamlit com gráficos do Plotly, voltada não para o engenheiro de ML, mas para um gerente ou analista. Por ela, é possível enviar vários arquivos mp3 ou wav, aguardar o processamento e ver na hora um resumo das ligações. Para ganhar velocidade, há cache de recursos, de modo que os modelos pesados não sejam recarregados a cada ação na interface. O projeto prevê vários modos de execução: demo sem áudio, análise de um único arquivo, processamento em lote de um diretório e o painel completo no navegador. Upload de arquivos de áudio
Ship AI Faster with Founders, Engineers & Weekly Architecture Reviews
Inside Vibe Club (hamidun.com/club) — weekly live masterminds with Zhemal Khamidun, Tech Radar, full LMS access, and 370+ production Claude Code skills.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.