ruGPT3XL ganha contexto de 8k: modelo restaurado ultrapassa o limite de 2k quase sem perdas
Depois da restauração, o ruGPT3XL ganhou não só um sparse attention funcional, mas também uma janela de contexto de 8k em vez dos 2k tokens originais. O autor do projeto primeiro encontrou um erro no mecanismo de atenção que derrubava a qualidade e depois refinou o modelo em duas etapas: 2k→4k e 4k→8k. Com isso, a PPL em 8k ficou em 13.00, enquanto no contexto base de 2k quase não mudou.
Processado por IA de Habr AI; editado por Hamidun News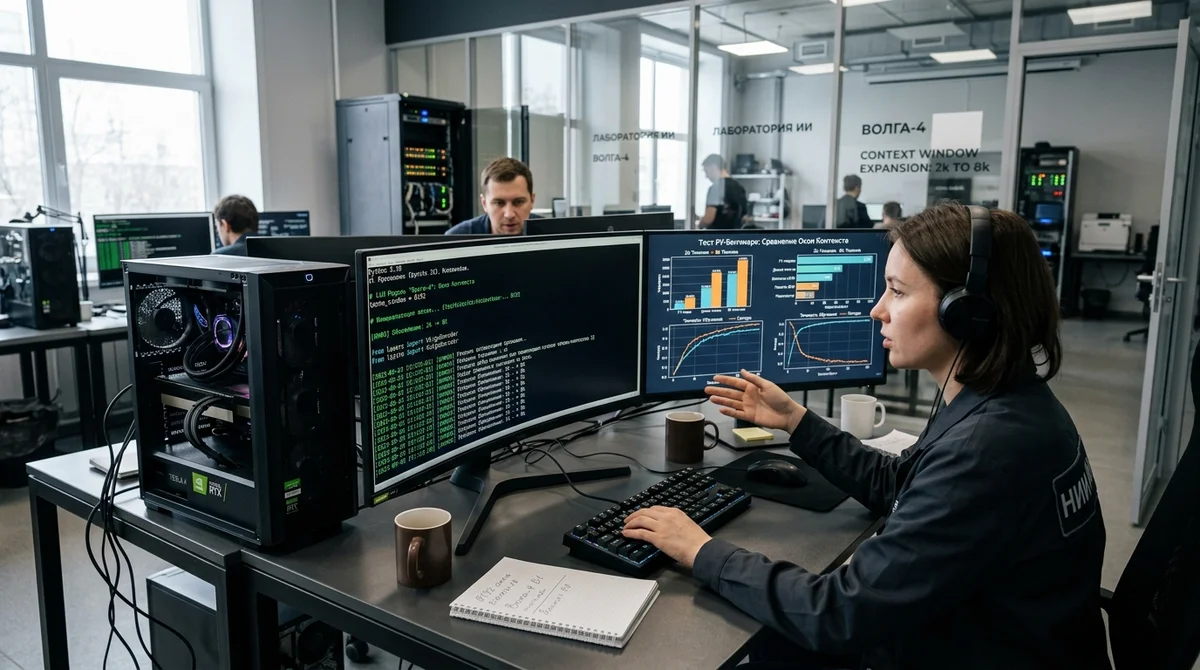
O ruGPT3XL, restaurado a partir de um antigo checkpoint do Megatron-LM, ganhou uma janela de contexto completa de 8 mil tokens, em vez dos 2 mil originais, e quase não perdeu qualidade em textos curtos. De quebra, o autor do projeto corrigiu um erro central no mecanismo de atenção, que fazia a versão inicial do modelo parecer bem pior que a original, embora formalmente rodasse e gerasse texto.
O projeto começou como uma restauração técnica de um antigo modelo em russo: os pesos do ruGPT3XL foram convertidos para o formato Hugging Face, uma versão GGUF foi preparada para o llama.cpp e os testes começaram. Foi nessa etapa que se descobriu que a conversão não funcionava totalmente certo. Em vez do sparse attention original, o modelo usava na prática o dense attention comum do GPT-2, e por isso a qualidade despencava em sequências longas. A métrica de perplexity confirmou rapidamente: a primeira verificação mostrou PPL de 50.1, enquanto o ruGPT3XL original tem declarado 12.05.
Depois da restauração do alternating sparse attention, o quadro mudou radicalmente. A PPL caiu para 11.68, ou seja, o modelo voltou a se aproximar dos valores originais e passou a calcular a atenção como previsto na arquitetura de origem. Em paralelo, foi preciso atualizar também o suporte no llama.cpp: o patch anterior levava os pesos para o GGUF, mas não implementava o sparse attention em si, então a versão local também calculava no esquema denso.
Além disso, o autor corrigiu um erro na máscara para batches com mais de um exemplo e adicionou aceleração via SDPA, torch.compile e Triton. Em uma RTX 4090, isso trouxe um ganho de velocidade de treinamento de cerca de 1.85 vez em relação à implementação eager básica.
O principal objetivo da etapa seguinte era prático: eliminar o antigo limite de 2048 tokens, que atrapalhava o trabalho com chats e documentos longos. Mas, no ruGPT3XL, não basta trocar um número na configuração. O modelo usa learned absolute positional embeddings, que não extrapolam bem para novas posições sem retreinamento, e o esquema de sparse attention também depende do comprimento máximo do contexto.
Por isso a ampliação foi feita por etapas: primeiro de 2k para 4k, depois de 4k para 8k. Para as novas posições, aplicou-se tiling dos embeddings posicionais, para não quebrar as sequências curtas já aprendidas, e o dataset foi misturado com exemplos longos e curtos na proporção de 60 para 40. O treinamento no dataset Gazeta levou cerca de 2.6 horas na primeira etapa e 3.9 horas na segunda.
O resultado ficou caprichado, e não só de vitrine. Na janela original de 2k, a versão final de 8k registrou PPL de 11.77 contra 11.68 do modelo base, uma regressão de apenas 0.09. Em 4k, o valor final foi 11.99 e, na janela completa de 8k, 13.00, o que parece muito digno para um contexto quatro vezes maior.
Em memória, o experimento também se mostrou viável: graças ao sparse attention, o crescimento do consumo não virou uma catástrofe, e treinamento e inferência couberam em uma RTX 4090 com 48 GB de VRAM. Durante o treinamento em 8k surgiu mais um problema prático, a fragmentação da memória CUDA, mas ela foi contornada com a configuração expandable_segments, e o consumo de pico caiu de 46.8 para 38.5 GB.
A velocidade de geração, claro, cai conforme o prompt cresce, mas com o contexto completo de 8k o modelo ainda mantém cerca de 38 tokens por segundo. Não se trata, portanto, só de um truque de pesquisa, mas de um cenário local perfeitamente utilizável.
Para o segmento open source em russo, é um sinal importante: mesmo modelos antigos não precisam ser apenas arquivados, e podem ser levados a um estado de trabalho moderno se os detalhes arquiteturais forem restaurados com cuidado e a validação não for poupada. No caso do ruGPT3XL, já não é uma atualização cosmética, mas um ganho real de utilidade: o modelo ficou mais próximo do original em qualidade, ganhou suporte em ferramentas populares e aprendeu a trabalhar com contexto longo sem perda séria em tarefas curtas.
- 2 de nov. de 2026NVIDIA lança Nemotron 3.5 Bolt E4B com 4 GB e 133 tokens por segundo na RTX 5070
- 2 de nov. de 2026Cosmos gerou vídeo de treinamento para drones: o mAP@50–95 do detector subiu 10,3%
- 2 de nov. de 2026Anthropic precisa crescer a receita 32% ao ano para cobrir contratos de US$ 850 bilhões
- 2 de nov. de 2026TensorFold 1.2.0 aumenta em 44,2% a vazão do Qwen3.8-27B no M3 Ultra com 16 fluxos
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.