Scikit-LLM mostra como incluir sumarização de texto em um pipeline de ML com scikit-learn
A Scikit-LLM mostrou como embutir a sumarização diretamente em um pipeline habitual do scikit-learn. No exemplo, avaliações longas são comprimidas primeiro pelo modelo gratuito DistilBART, do Hugging Face, e depois passam por TF-IDF e LogisticRegression. A abordagem reduz o volume de texto, simplifica a preparação de atributos e mantém todo o processo, do texto bruto à classificação, dentro de um único pipeline reproduzível.
Processado por IA de Machine Learning Mastery; editado por Hamidun News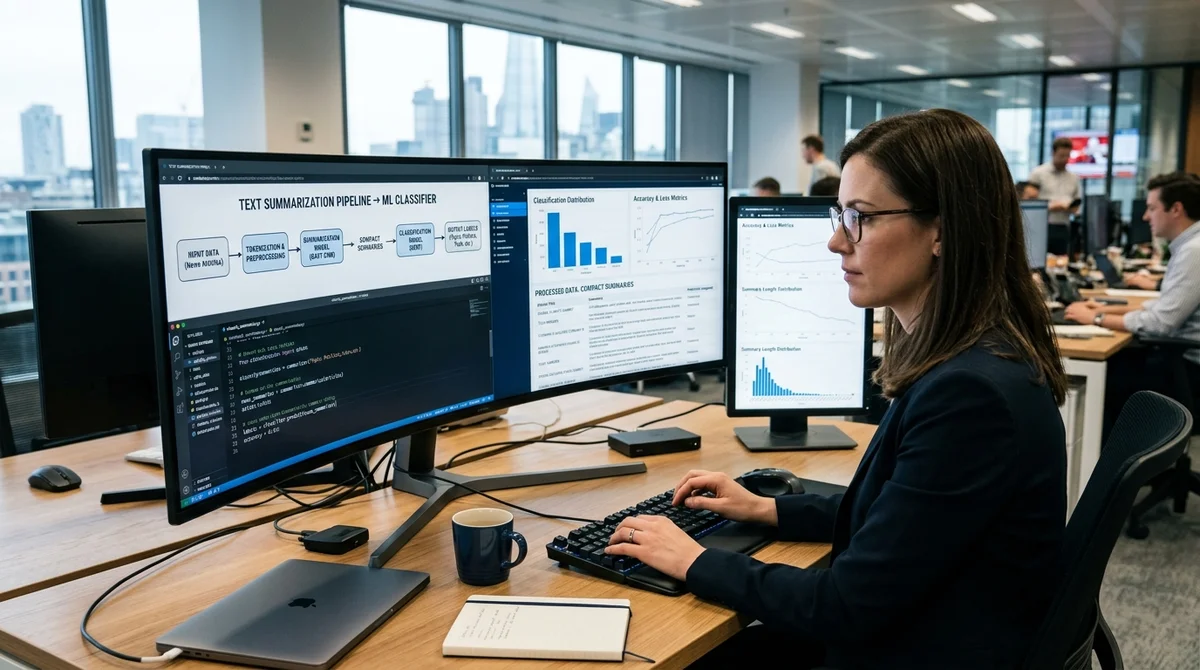
A Scikit-LLM mostrou uma forma prática de embutir a sumarização de texto diretamente em um pipeline clássico de ML com scikit-learn. A ideia é simples: documentos longos são comprimidos primeiro por um LLM em resumos curtos, depois viram atributos numéricos e seguem para um classificador. Assim, é possível trabalhar com textos grandes sem uma etapa manual de pré-processamento e deixar todo o pipeline unificado, do texto bruto à previsão final.
Na análise, o autor usa a Scikit-LLM como elo entre as ferramentas tradicionais de aprendizado de máquina e os modelos de linguagem modernos. Por padrão, a biblioteca se apoia em modelos da OpenAI, mas o exemplo escolhe uma opção gratuita via Hugging Face: o modelo sshleifer/distilbart-cnn-12-6. Para isso, também se instala a biblioteca transformers na versão 4.37.2. A escolha importa: a sumarização pode ser chamada muitas vezes, e o custo de inferência logo pesa se ela rodar em APIs comerciais.
O elemento central do exemplo é uma classe própria, HuggingFaceSummarizer, compatível com o scikit-learn. Ela herda de BaseEstimator e TransformerMixin, então pode entrar em um Pipeline comum como qualquer outro transformador. No método fit, a classe carrega um modelo pré-treinado na memória; no transform, recebe uma lista de textos, executa o pipeline de sumarização e devolve os resumos curtos já prontos. O hardware também é considerado: se houver GPU disponível, o modelo roda nela; caso contrário, usa a CPU.
Essa sumarização se torna então o primeiro passo do pipeline de ML. Depois dela entra o TfidfVectorizer, que transforma os textos reduzidos em atributos numéricos, e em seguida o LogisticRegression é treinado com essas representações. A demonstração usa apenas dois exemplos: uma avaliação positiva de um aspirador de pó e uma avaliação negativa de uma mochila, com atraso na entrega e zíper problemático. Para um modelo real, claro, isso não basta, mas o ponto aqui é outro: mostrar que um texto longo e não estruturado pode ser condensado automaticamente e alimentar direto um esquema padrão de classificação.
Outro ponto útil é que todo o processo é disparado por uma chamada comum a fit. Nessa etapa, o pipeline baixa o modelo, resume os textos longos, vetoriza as versões reduzidas e só então treina o classificador. O autor também mostra os resumos intermediários: na avaliação positiva, permanece a ideia de que o aparelho é bom no geral, embora meio pesado e não muito claro de configurar; na negativa, ficam as queixas sobre o atraso na entrega, o zíper que emperra e o tecido barato. Mesmo um modelo compacto consegue extrair o sinal principal, que depois pode ser usado em ML convencional.
Como esperado, o resultado dessa abordagem minimalista é um meio-termo. O autor afirma sem rodeios que a qualidade dos resumos fica nitidamente abaixo da que se obtém com o ChatGPT ou o Google Gemini. O DistilBART, leve e gratuito, extrai as ideias principais, mas de forma mais grosseira e menos cuidadosa. Em compensação, o exemplo ilustra bem a arquitetura: a sumarização deixa de ser uma ferramenta externa e vira parte embutida do processo de treinamento. Isso é especialmente útil em tarefas com muitos documentos longos e um modelo posterior sensível à dimensionalidade e ao ruído do texto.
O valor prático do esquema é que o desenvolvedor ganha um único pipeline reproduzível para preparar os textos e treinar o modelo. Em vez de vários scripts soltos, há um só fluxo que pode ser treinado, testado e levado à produção pelas regras padrão do scikit-learn. Se o modelo leve for trocado por um mais forte, a qualidade da sumarização sobe e, com ela, pode subir a da classificação.
A Scikit-LLM funciona aqui como ponte entre a stack habitual de aprendizado de máquina e as abordagens com LLM, uma ponte que dá para adotar sem reconstruir a infraestrutura. É especialmente interessante para equipes que já vivem no ecossistema scikit-learn e querem adicionar recursos de LLM pontualmente, sem reescrever por completo os pipelines, a infraestrutura de treinamento e os procedimentos de validação.
- 2 de nov. de 2026Assistente Muse, da Meta, mantém dossiê sobre pessoas próximas e recebe root no Ubuntu por padrão
- 1 de nov. de 2026Modelos locais perdem para Opus e Codex: 0,21 ponto no MacBook contra 1,00 do Codex
- 1 de nov. de 2026Kimi marca 96,2% em teste de análise em base 1C e vira reserva caso o Claude seja bloqueado
- 1 de nov. de 2026OpenAI reescreve as regras de comportamento do GPT: cinco valores e uma cadeia de prioridades
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.