Scikit-LLM: classificação multirrótulo de texto com LLMs e sem dados de treino
A Scikit-LLM conecta o scikit-learn aos modelos de linguagem GPT-4 e permite atribuir vários rótulos a um mesmo texto sem um conjunto de treino. Um classificador clássico atribui uma única categoria por documento. Aqui, basta listar as tags possíveis, e o modelo zero-shot decide quais se aplicam. A ferramenta funciona com textos em qualquer idioma e é compatível com Pipeline. Entre os usos estão a marcação de notícias, contratos e solicitações de clientes.
Processado por IA de Machine Learning Mastery; editado por Hamidun News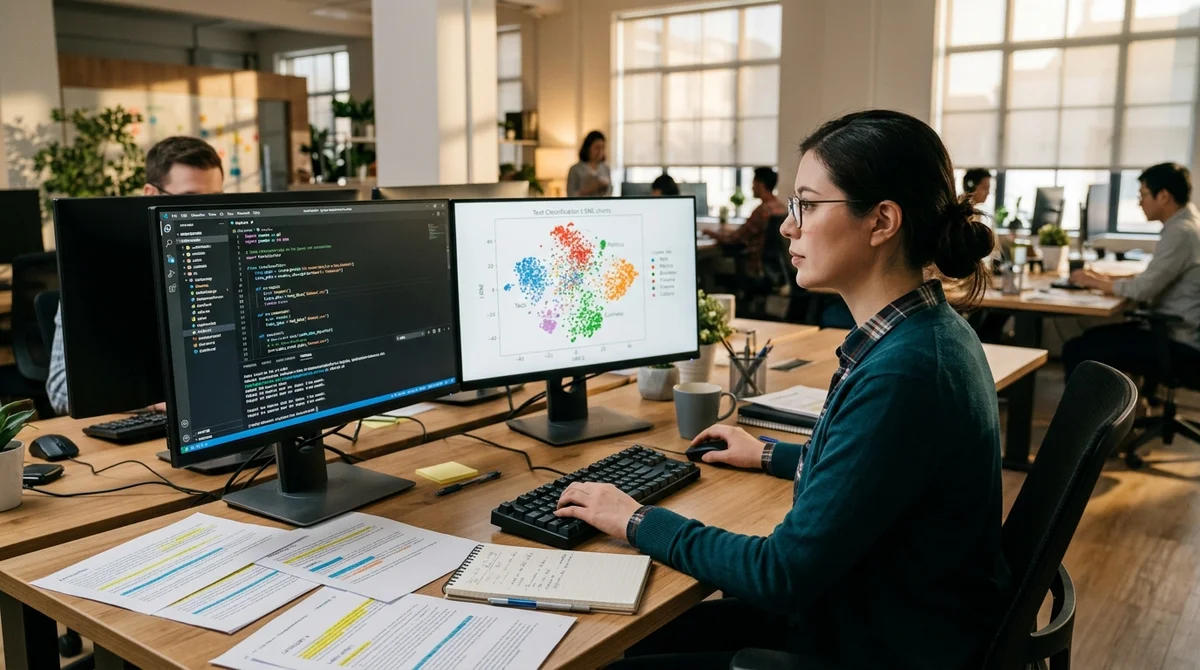
A Scikit-LLM é uma biblioteca Python que dá acesso a modelos de linguagem pela interface já conhecida do scikit-learn. Seu classificador zero-shot consegue atribuir automaticamente vários rótulos a um texto, sem dataset rotulado e sem fine-tuning do modelo.
Por que a classificação tradicional não basta?
As abordagens padrão de classificação de texto seguem a lógica de "um documento, um rótulo". Uma avaliação é positiva ou negativa. A solicitação de um cliente trata de entrega, de devolução ou de pagamento.
Para tarefas simples, isso é suficiente. Textos reais são mais complexos. Um artigo sobre uma nova regulação de AI envolve, ao mesmo tempo, tecnologia, direito, negócios e política.
Uma avaliação de smartphone fala da câmera, da bateria e da qualidade de construção de uma só vez. A classificação multirrótulo foi criada justamente para esses casos: cada texto recebe um conjunto de rótulos adequados, e não apenas um. Antes dos LLMs, isso exigia um dataset cuidadosamente rotulado, a escolha de uma arquitetura (Binary Relevance, Classifier Chain ou Label Powerset) e um longo ajuste dos limiares de classificação.
Cada nova categoria significava mais exemplos rotulados. Os LLMs mudam essa equação.
Como funciona o modo zero-shot A
Scikit-LLM usa o modelo de linguagem como um "classificador inteligente por descrição". O desenvolvedor só precisa passar a lista de categorias em texto comum, e o GPT-4, o GPT-4o Mini ou um provedor compatível determina quais delas se aplicam a cada documento. O parâmetro `multi_label=True` coloca o classificador no modo multirrótulo.
Vale destacar que zero-shot não significa baixa qualidade. Os LLMs atuais entendem contexto e semântica em um nível que modelos BERT só alcançam após fine-tuning com centenas de exemplos rotulados. Em muitas tarefas reais, um LLM zero-shot supera classificadores especializados treinados com milhares de documentos anotados.
A interface continua totalmente compatível com o ecossistema do scikit-learn: métodos `.fit()` e `.predict()`, suporte a `Pipeline` e validação cruzada via `GridSearchCV`.
Trocar um classificador tradicional por um baseado em LLM pode levar literalmente uma linha de código. Principais características da abordagem: Dispensa dados de treino: basta listar as categorias em texto Funciona com textos em qualquer idioma, sem configuração adicional Compatibilidade total com `Pipeline` e `GridSearchCV` do scikit-learn Modo few-shot: é possível adicionar alguns exemplos para aumentar a precisão em domínios especializados Saída em arrays NumPy padrão, compatíveis com o restante da stack de ML ## Onde isso é aplicado A classificação multirrótulo com LLMs já resolve várias tarefas práticas recorrentes. *Mídia e conteúdo.
Plataformas de notícias marcam automaticamente as matérias por tema, gênero e geografia. Cada matéria recebe vários rótulos sem intervenção de um editor, o que agiliza a moderação e melhora os algoritmos de recomendação. Atendimento ao cliente.
As solicitações são encaminhadas para várias equipes ao mesmo tempo: um único e-mail pode tratar de entrega, qualidade do produto e reembolso, e entrar de uma vez em três filas de atendimento. Textos jurídicos.** Contratos são classificados por tipo de obrigação, legislação aplicável e nível de risco, sem rotulagem manual por advogados.
Isso reduz o tempo da auditoria inicial de dias para minutos. Corpora de pesquisa. Milhares de documentos são rotulados em horas, e não em semanas.
Isso é especialmente valioso no início de um novo projeto de NLP ou no trabalho com acervos legados.
"A diferença entre a classificação single-label e a multi-label é a
diferença entre enxergar em preto e branco e enxergar em cores", costumam explicar desenvolvedores de sistemas de NLP ao lidar com dados reais.
O que isso significa A
Scikit-LLM reduz a barreira de entrada para tarefas complexas de NLP a algumas linhas de código. A classificação multirrótulo, que antes exigia dados rotulados e um modelo especializado, agora pode ser resolvida em modo zero-shot em minutos. Para equipes que trabalham com texto não estruturado, isso muda não só o ferramental, mas também quais tarefas vale a pena encarar.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.