Servidor próprio para IA: chega de sofrer com o notebook de casa e de ouvir coaches
Rodar um LLM no notebook de casa é diversão para uma noite: logo esbarra na falta de memória de vídeo e na velocidade de tartaruga. Se você precisa de uma ferramenta de trabalho, e não de um brinquedo, é hora de migrar para soluções de servidor. Não faltam dicas sobre como rodar uma Llama "capada", mas modelos assim têm pouca utilidade prática. A inferência de verdade começa onde terminam as placas de vídeo de consumo e onde entra a configuração cuidadosa de hardware e software. Vamos ao plano passo a passo: da escolha da GPU à otimização dos pesos. É um investimento em privacidade e em independência de gigantes da nuvem como OpenAI e Anthropic.
Processado por IA de Habr AI; editado por Hamidun News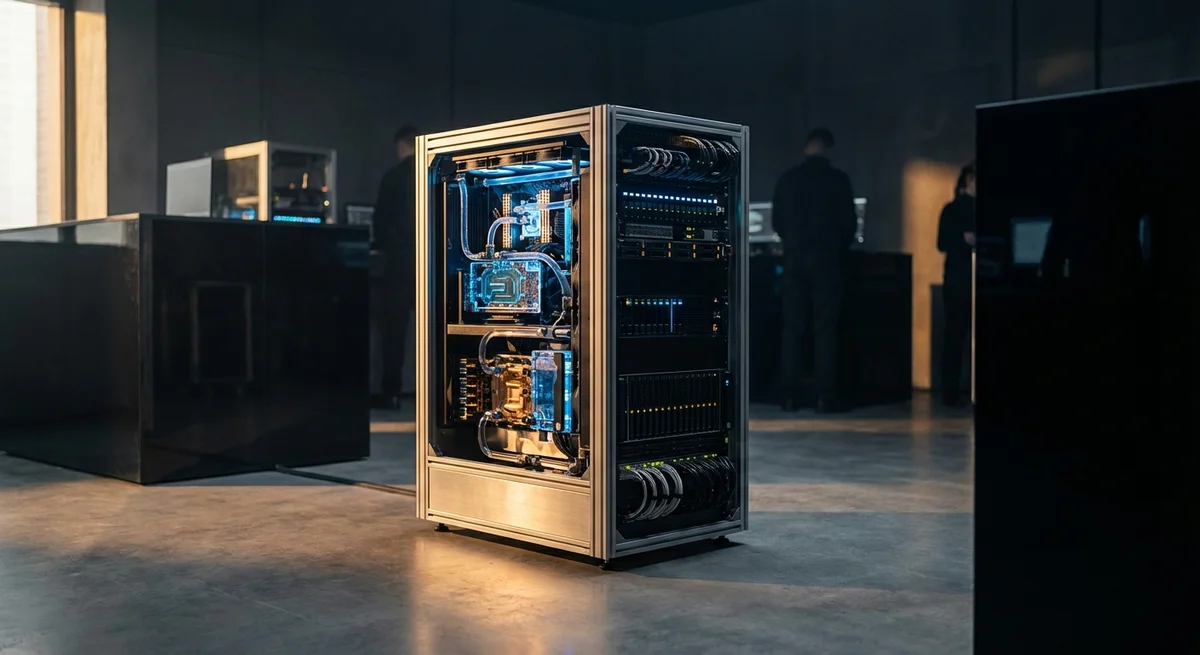
Lembra da sensação de rodar a Llama no seu notebook pela primeira vez? Primeiro vem a empolgação de ver aquilo funcionando. Cinco minutos depois, vem a irritação: o modelo cospe duas palavras por segundo, e as ventoinhas parecem prestes a decolar rumo à estratosfera. A internet hoje está lotada de guias de autoproclamados especialistas que prometem inteligência artificial completa em hardware de cinco anos atrás. Sejamos honestos: isso é autoengano. Trabalhar a sério com modelos de linguagem locais exige uma abordagem séria de infraestrutura. Se você quer que a IA ajude de verdade a programar ou a analisar documentos, e não só divirta você com piadas tortas, chegou a hora de montar seu próprio servidor.
Por que se dar ao trabalho de ter hardware próprio quando as APIs da OpenAI e da Anthropic estão à mão? A resposta cabe em duas palavras: privacidade e controle. Num mundo em que as corporações mudam as regras do jogo de uma hora para outra, impõem censura rígida e podem bloquear sua conta sem dar explicações, ter seu próprio cérebro digital vira uma questão de segurança. Você não compartilha seus segredos comerciais com servidores na Califórnia e não depende de Sam Altman decidir amanhã triplicar os preços. Além disso, com uso intenso, as faturas de nuvem começam a parecer número de telefone, e a compra de GPUs próprias se paga mais rápido do que parece à primeira vista.
O principal problema na montagem de um servidor desses é a memória de vídeo. É ela, e não a frequência do processador, que define qual modelo você conseguirá rodar e quão inteligente ele será. Para modelos minúsculos, de 7 bilhões de parâmetros, uma placa de vídeo gamer intermediária dá conta.
Já para algo realmente potente, como o Mixtral ou as versões maiores da Llama 3, são necessários dezenas ou centenas de gigabytes de VRAM. Aqui entramos na zona dos trade-offs difíceis. Ou você gasta uma fortuna em placas profissionais do nível da NVIDIA A100 ou H100, ou aprende a arte da quantização.
A quantização permite comprimir os pesos do modelo quase sem perda de qualidade, e essa é uma etapa crítica da configuração, que separa o amador do profissional.
Mas a memória é só metade do problema. O segundo, que iniciantes costumam esquecer, é a largura de banda. Você pode comprar muita memória barata, mas, se o barramento de dados for estreito, seu modelo vai pensar com uma lentidão agonizante. É por isso que soluções de servidor baseadas em arquiteturas de alta largura de banda valem o que custam. Estamos saindo da era dos usuários comuns de IA e entrando na era dos operadores de sistemas locais. Saber implantar, otimizar e manter sua própria capacidade computacional hoje vale muito mais do que simplesmente saber escrever prompts num chatbot.
A parte de software é tão interessante quanto a escolha do hardware. Simplesmente rodar o modelo pelo terminal é só o começo. Para transformar o servidor numa ferramenta útil, é preciso configurar o ambiente de inferência com ferramentas modernas como vLLM ou Ollama. É preciso aprender a gerenciar filas de requisições, ajustar a janela de contexto e integrar o modelo aos seus fluxos de trabalho habituais. Isso transforma uma pilha de hardware caro numa máquina bem azeitada, que trabalha para você 24 horas por dia, sem folgas nem feriados.
No fim das contas, ter um servidor próprio é ter liberdade para experimentar. Com uma máquina potente à disposição, você começa a testar hipóteses nas quais antes simplesmente não valia a pena gastar tokens pagos. Dá para fazer fine-tuning de modelos com seus dados específicos, criar agentes autônomos e não temer que amanhã seu acesso à tecnologia seja restringido por mais uma mudança na política de privacidade. É o ingresso para a primeira divisão da independência tecnológica, onde você mesmo define as regras do jogo e controla cada byte de informação.
O principal: um servidor local é a única forma de ter uma IA realmente privada e de alto desempenho sem depender das corporações. Você está pronto para investir na sua independência digital ou vai continuar alugando cérebros dos gigantes do Vale do Silício?
- 1 de nov. de 2026OpenAI reescreve as regras de comportamento do GPT: cinco valores e uma cadeia de prioridades
- 1 de nov. de 2026Google admite que o AI Mode reduz a receita da Busca; ações caem 15%
- 31 de out. de 2026Autor leva roteiro a julgamento por jurados de IA, e o veredito custa 850 mil tokens
- 31 de out. de 2026Anthropic: unir subagentes em um único loop deixou as tarefas de um cliente duas vezes mais rápidas
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.