LLM locaux
Les LLM locaux sont des modèles de langage qui tournent directement sur votre propre matériel — un ordinateur portable, un PC avec GPU ou un serveur domestique — sans cloud, sans abonnement et sans que vos données quittent votre machine. Ollama, llama.cpp et LM Studio, avec les versions GGUF quantifiées de Llama, Qwen et Gemma, rendent cela possible même sur une carte graphique vieille de dix ans. Voici toute notre couverture de l’IA en local : guides, tests de matériel, quantification et confidentialité.


Comment Utiliser l'IA Gratuitement pour la Programmation : Un Guide Réaliste
Aperçu des outils d'IA gratuits disponibles pour la programmation : capacités, limitations et quand passer à la version payante.

GPUDirect et TurboQuant : AWS accélère le chargement des grands LLMs sur GPU
De nouveaux outils AWS aident à accélérer le chargement de modèles avec des centaines de milliards de paramètres dans la mémoire GPU, réduisant les temps…

Exécuter GLM-5.1 Localement : Guide Complet pour llama.cpp et GGUF
Habr a publié un guide détaillé pour déployer le modèle GLM-5.1 sur du matériel local en utilisant les outils llama.cpp et les formats GGUF pour l'optimisation…

Microsoft mise sur ses propres modèles d'AI pour réduire ses coûts
Microsoft a lancé Foundry Managed Compute : des milliers de modèles Hugging Face d'un seul clic
Gemma 4 Analyse les PDFs Comme des Images : Approche Zero-Shot Sans OCR et Sans Cloud
Apple présente FlowEval : évaluation des interfaces IA via des scénarios de navigation réels
Broadcom Prolonge son Partenariat avec Apple pour la Fourniture de Puces Personnalisées Jusqu'en 2031
Broadcom et Apple ont signé de nouveaux accords pluriannuels pour le développement et la fourniture de puces personnalisées pour iPhone — le contrat prolongé…
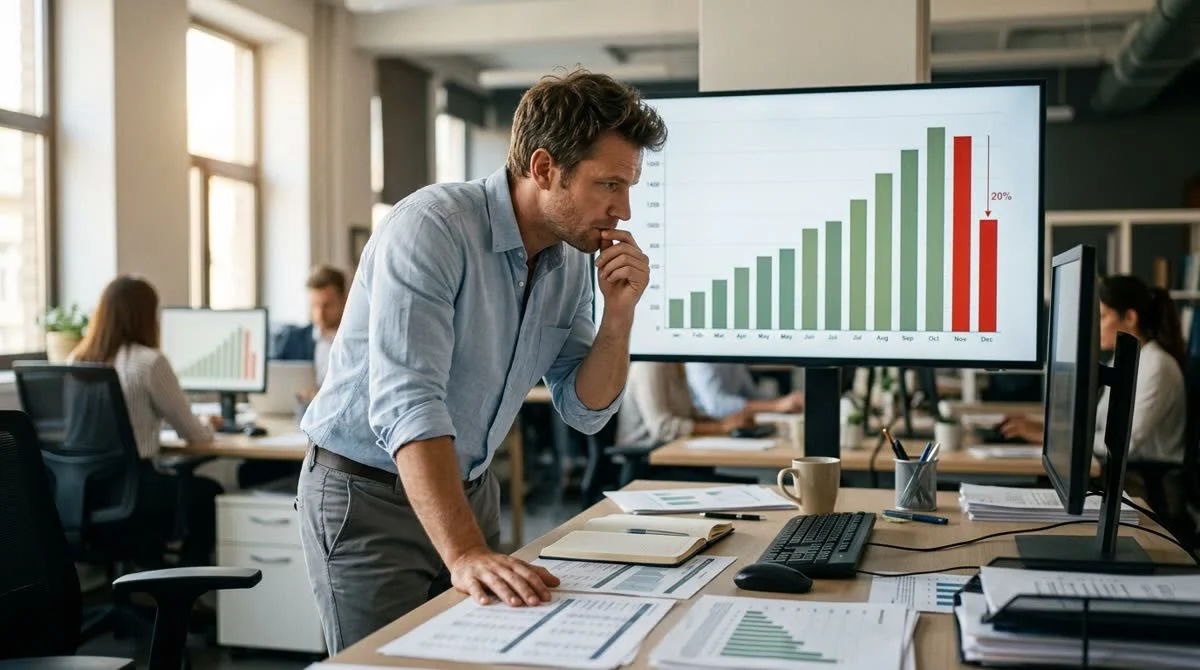
L'Indice des Dépenses en Tokens d'IA de Silicon Data a Baissé de 20% en Juin Après une Croissance Record
Les analystes de Silicon Data ont enregistré une baisse de près de 20% de l'indice clé LLM Token Expenditure Index par rapport au pic de mai — après une croissance…
Proton a lancé Lumo 2.0 — chat AI privé sans entraînement sur les données des utilisateurs
WebBrain : l’agent AI open source pour navigateur fonctionne sans cloud et sans abonnement
NVIDIA TensorRT met désormais à l’échelle l’inférence d’AI générative sur plusieurs GPU
7 Meilleurs Modèles de Codage pour Exécution Locale en 2026 : Qwen, DeepSeek et Autres
PDG de Qualcomm : les agents AI deviendront les nouvelles applications, 40 appareils à venir
Google DeepMind lance DiffusionGemma — un modèle MoE ouvert de 26B avec une génération 4 fois plus rapide
Google a lancé Gemma 4 12B : 150 millions de téléchargements, fonctionne sur un ordinateur portable avec 16 GB de VRAM
NVIDIA TensorRT transforme les checkpoints FP8 en moteurs pour une inférence rapide
NVIDIA a expliqué comment convertir un checkpoint quantifié en FP8 en moteur TensorRT — une étape qui transforme un modèle optimisé en véritable outil de production.
Comment créer un agent AI dans Google Colab sans frameworks : tutoriel avec mémoire et MCP
Tutoriel pas à pas pour créer un agent AI léger dans Google Colab — avec enregistrement des outils, mémoire de session, skills et serveur MCP, sans frameworks…