Les systèmes RAG déraillent sur des données réelles : le coupable, c'est le retrieval, pas le modèle
Les pipelines RAG échouent souvent à cause du retrieval, pas du modèle. Quand le système ne trouve pas le bon document ou le bon extrait, même GPT-4 se met à halluciner. Un modèle ne vaut que par le contexte qu'on lui fournit.
Traité par IA depuis Habr AI ; édité par Hamidun News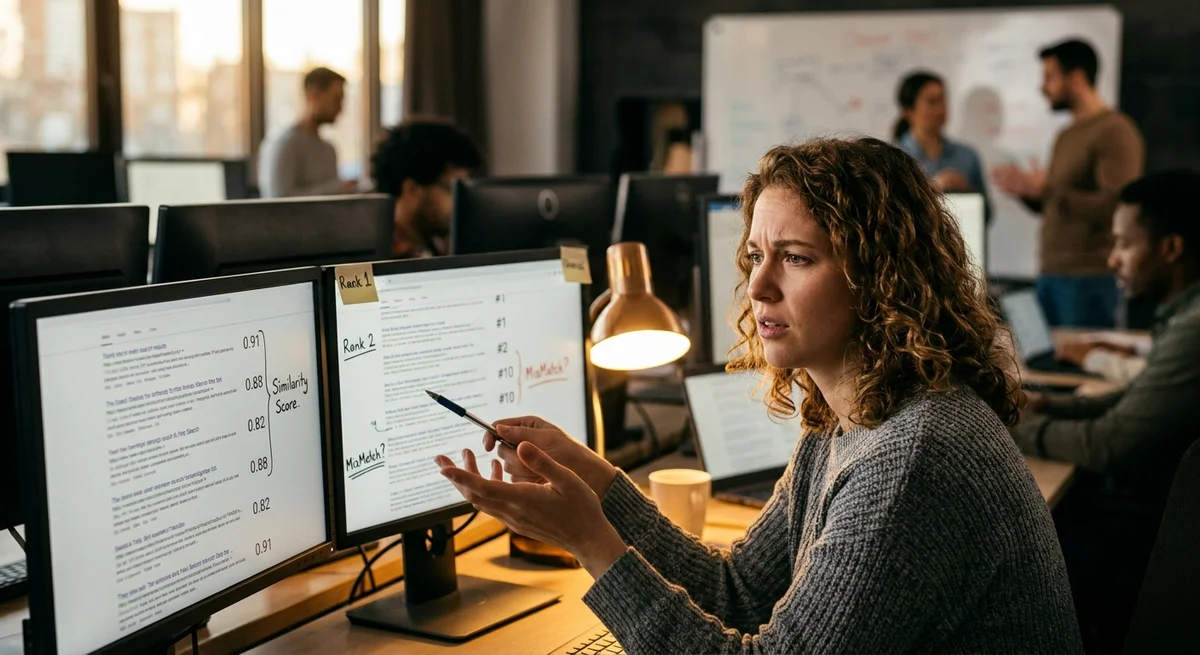
Un pipeline RAG ressemble à de la magie : on charge les documents, on les découpe en chunks, on génère des embeddings, on branche une base de données vectorielle. On pose une question, et le modèle répond avec aplomb et en détail. On le montre au client, qui est enthousiaste. Mais le test réel commence alors, avec de vraies questions, et il apparaît que le système passe à côté de la moitié d'entre elles.
Le goulot d'étranglement du RAG
Sur des questions réelles, le système répond souvent de travers. Tantôt il trouve un tout autre document. Tantôt il trouve le bon document, mais en extrait le mauvais passage. Tantôt il ne récupère rien de pertinent, et le modèle hallucine avec assurance.
On croit que le problème vient du modèle. En réalité, le coupable est le retrieval. GPT-4 et Claude répondent très bien quand on leur fournit le bon contexte. Si le contexte est mauvais, l'hallucination est garantie, aussi bon soit le modèle. Le modèle répond exactement aussi bien que le contexte qu'on lui fournit.
Le problème n'est pas les modèles. Le problème, c'est le retrieval : la façon dont nous cherchons les passages pertinents dans votre base de documents. C'est le goulot d'étranglement par lequel passe tout le pipeline RAG. Si le retrieval donne au modèle un mauvais contexte, tout le reste n'est que temps et argent gaspillés.
«
Le modèle répond aussi bien que le contexte qu'on lui fournit. »
Quand le retrieval casse
Le retrieval peut casser pour des dizaines de raisons. Voici les plus fréquentes :
- Le découpage en chunks est trop grossier ou trop fin. Un chunk de 512 mots peut capter le contexte voisin au lieu du passage voulu. La question porte sur la politique de retour, mais le chunk contient la description d'un tableau des tailles.
- Les embeddings ont été générés pour des données en anglais, alors que la question est en russe. La distance sémantique entre le vecteur de la question et ceux des documents est énorme, et il n'y a aucune correspondance.
- La question est reformulée de sorte que son vecteur d'embedding ne coïncide pas avec ceux de la base. Vous cherchez « retourner une commande », mais les documents disent « retour de marchandise » : la sémantique diffère.
- Le document pertinent arrive 8e sur 10, mais on n'a fourni au modèle que les 5 premiers résultats. Le contexte nécessaire n'entre tout simplement pas dans la fenêtre visible.
- L'index est rempli de doublons et de bruit. De nombreux chunks non pertinents chassent l'information correcte des résultats.
Chacun de ces problèmes mène au même résultat : le modèle hallucine au lieu de donner la bonne réponse.
Le prix du retrieval
Optimiser le retrieval n'est pas un passe-temps pour passionnés. C'est un vrai travail : une ou deux semaines de développeur consacrées à l'analyse révéleront que le système se situe 30-40 % sous la précision attendue. La cause n'est pas le modèle, mais le fait que le retrieval cherche mal. Sur des projets réels, la perte est énorme : du temps passé sur le RAG, de l'argent dépensé en infrastructure, et un système qui ne fonctionne pas parce que les vecteurs des documents ne correspondent pas à ceux des questions.
Ce que cela signifie
Le RAG ne fonctionne que si le retrieval fonctionne. Sans cela, même le meilleur modèle se trompera. Cela signifie qu'avant de lancer un RAG en production, il faut consacrer un temps sérieux à l'optimisation de la recherche, aux tests sur des données réelles, puis à l'amélioration itérative du pipeline de retrieval.
- 1 nov. 2026Les modèles locaux battus par Opus et Codex : 0,21 sur MacBook contre 1,00 pour Codex
- 1 nov. 2026Kimi obtient 96,2 % à un test d'analytique sur une base 1C et s'impose comme solution de repli en cas de blocage de Claude
- 1 nov. 2026OpenAI réécrit les règles de comportement de GPT : cinq valeurs et une chaîne de priorités
- 1 nov. 2026Google reconnaît que l'AI Mode réduit les revenus de la recherche, l'action chute de 15%
Questions clés sur cet article
Que sait-on sur Le goulot d'étranglement du RAG ?
Sur des questions réelles, le système répond souvent de travers. Tantôt il trouve un tout autre document. Tantôt il trouve le bon document, mais en extrait le mauvais passage. Tantôt il ne récupère rien de pertinent, et le modèle hallucine avec assurance. On croit que le problème vient du modèle. En réalité, le coupable est le retrieval. GPT-4 et Claude répondent très bien quand on leur fournit le bon contexte. Si le contexte est mauvais, l'hallucination est garantie, aussi bon soit le modèle. Le modèle répond exactement aussi bien que le contexte qu'on lui fournit. Le prob
Quand le retrieval casse?
Le retrieval peut casser pour des dizaines de raisons. Voici les plus fréquentes : Le découpage en chunks est trop grossier ou trop fin. Un chunk de 512 mots peut capter le contexte voisin au lieu du passage voulu. La question porte sur la politique de retour, mais le chunk contient la description d'un tableau des tailles. Les embeddings ont été générés pour des données en anglais, alors que la question est en russe. La distance sémantique entre le vecteur de la question et ceux des documents est énorme, et il n'y a aucune correspondance. La question est reformulée de sorte
Que sait-on sur Le prix du retrieval ?
Optimiser le retrieval n'est pas un passe-temps pour passionnés. C'est un vrai travail : une ou deux semaines de développeur consacrées à l'analyse révéleront que le système se situe 30-40 % sous la précision attendue. La cause n'est pas le modèle, mais le fait que le retrieval cherche mal. Sur des projets réels, la perte est énorme : du temps passé sur le RAG, de l'argent dépensé en infrastructure, et un système qui ne fonctionne pas parce que les vecteurs des documents ne correspondent pas à ceux des questions.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.