Anthropic crée un outil pour traduire les « pensées » de Claude en langage humain
Anthropic a présenté les Natural Language Autoencoders, une méthode qui transforme les activations internes de Claude en explications textuelles. Elle permet de voir en temps réel comment le modèle traite l'information et prend ses décisions, et fait de la boîte noire du réseau de neurones un mécanisme transparent. Au lieu de deviner à partir de la réponse finale, les chercheurs peuvent observer ce que le modèle « pense » en interne.
Traité par IA depuis MarkTechPost ; édité par Hamidun News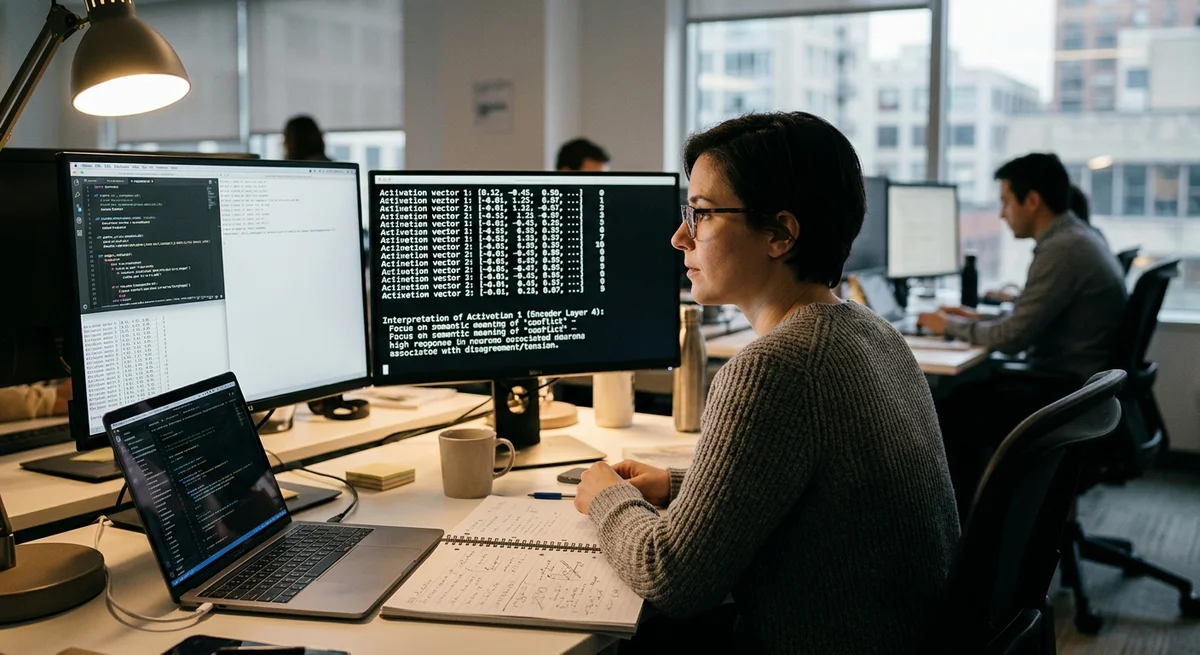
Anthropic a développé les Natural Language Autoencoders, une nouvelle technique qui traduit les activations internes du réseau de neurones Claude en explications textuelles. Concrètement, il devient possible de voir ce que le modèle « pense » en interne, au lieu de deviner à partir de sa réponse finale.
Que sont les Natural Language Autoencoders ?
Lorsque vous envoyez un message à Claude, celui-ci traverse une chaîne de transformations cachées. Le texte est encodé en longs vecteurs de nombres appelés activations. C'est à ce niveau que le modèle analyse le sens, relie les informations et prend ses décisions.
Le problème, c'est que pour un humain, ces vecteurs ne sont que des nombres. Anthropic a créé un outil qui prend ces représentations numériques et les reconvertit en langage naturel : des explications compréhensibles de ce qui s'est passé à chaque étape du traitement.
Comment cela fonctionne-t-il ?
Les Natural Language Autoencoders fonctionnent en deux étapes. D'abord, un encodeur compresse les activations du modèle en une représentation compacte. Ensuite, un décodeur déplie cette représentation en texte.
L'idée centrale est que des explications textuelles sont bien plus riches pour l'analyse que l'interprétation directe des vecteurs bruts. Au lieu de tas de nombres, on obtient des phrases comme « le modèle a remarqué qu'il s'agit d'une question de mathématiques » ou « ici, il faut vérifier le contexte du message précédent ».
Pourquoi est-ce important ?
L'interprétabilité des modèles est l'un des principaux problèmes de l'IA. Jusqu'ici, les réseaux de neurones sont restés pour l'essentiel des boîtes noires. Avec cet outil, Anthropic avance vers la transparence :
- Débogage : on peut voir à quelle étape le modèle a commencé à se tromper
- Sécurité : il est plus facile de repérer les comportements indésirables au niveau des activations
- Entraînement : les chercheurs comprennent mieux la logique interne du modèle
- Confiance : la transparence renforce la confiance des utilisateurs dans l'IA
Que cela signifie-t-il ?
Les Natural Language Autoencoders ne sont pas seulement un projet de recherche. C'est un premier pas pratique pour que les grands modèles de langage cessent d'être des boîtes noires. Mieux nous comprenons comment pensent les réseaux de neurones, mieux nous pouvons les contrôler et les améliorer. Pour les développeurs, cela ouvre de nouvelles possibilités de diagnostic et d'optimisation.
- 1 nov. 2026Les modèles locaux battus par Opus et Codex : 0,21 sur MacBook contre 1,00 pour Codex
- 1 nov. 2026Kimi obtient 96,2 % à un test d'analytique sur une base 1C et s'impose comme solution de repli en cas de blocage de Claude
- 1 nov. 2026OpenAI réécrit les règles de comportement de GPT : cinq valeurs et une chaîne de priorités
- 1 nov. 2026Google reconnaît que l'AI Mode réduit les revenus de la recherche, l'action chute de 15%
Questions clés sur cet article
Que sont les Natural Language Autoencoders ?
Lorsque vous envoyez un message à Claude, celui-ci traverse une chaîne de transformations cachées. Le texte est encodé en longs vecteurs de nombres appelés activations. C'est à ce niveau que le modèle analyse le sens, relie les informations et prend ses décisions. Le problème, c'est que pour un humain, ces vecteurs ne sont que des nombres. Anthropic a créé un outil qui prend ces représentations numériques et les reconvertit en langage naturel : des explications compréhensibles de ce qui s'est passé à chaque étape du traitement.
Comment cela fonctionne-t-il ?
Les Natural Language Autoencoders fonctionnent en deux étapes. D'abord, un encodeur compresse les activations du modèle en une représentation compacte. Ensuite, un décodeur déplie cette représentation en texte. L'idée centrale est que des explications textuelles sont bien plus riches pour l'analyse que l'interprétation directe des vecteurs bruts. Au lieu de tas de nombres, on obtient des phrases comme « le modèle a remarqué qu'il s'agit d'une question de mathématiques » ou « ici, il faut vérifier le contexte du message précédent ».
Pourquoi est-ce important ?
L'interprétabilité des modèles est l'un des principaux problèmes de l'IA. Jusqu'ici, les réseaux de neurones sont restés pour l'essentiel des boîtes noires. Avec cet outil, Anthropic avance vers la transparence : Débogage : on peut voir à quelle étape le modèle a commencé à se tromper Sécurité : il est plus facile de repérer les comportements indésirables au niveau des activations Entraînement : les chercheurs comprennent mieux la logique interne du modèle Confiance : la transparence renforce la confiance des utilisateurs dans l'IA
Que cela signifie-t-il ?
Les Natural Language Autoencoders ne sont pas seulement un projet de recherche. C'est un premier pas pratique pour que les grands modèles de langage cessent d'être des boîtes noires. Mieux nous comprenons comment pensent les réseaux de neurones, mieux nous pouvons les contrôler et les améliorer. Pour les développeurs, cela ouvre de nouvelles possibilités de diagnostic et d'optimisation.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.