Choisir une IA pour le travail : pourquoi les benchmarks ne suffisent pas
Les bons scores aux benchmarks d'IA garantissent de moins en moins une utilité réelle. Pour Angela Aristidou, chercheuse à l'UCL et à Stanford, il faut évaluer les modèles non pas en vase clos, mais dans des processus réels : leur effet sur le travail d'équipe, sur la vitesse des validations et sur la capacité des humains à repérer les erreurs. Plutôt que des tests ponctuels, elle défend l'approche HAIC : une évaluation dans la durée du binôme « humain + IA », dans un contexte précis.
Traité par IA depuis Habr AI ; édité par Hamidun News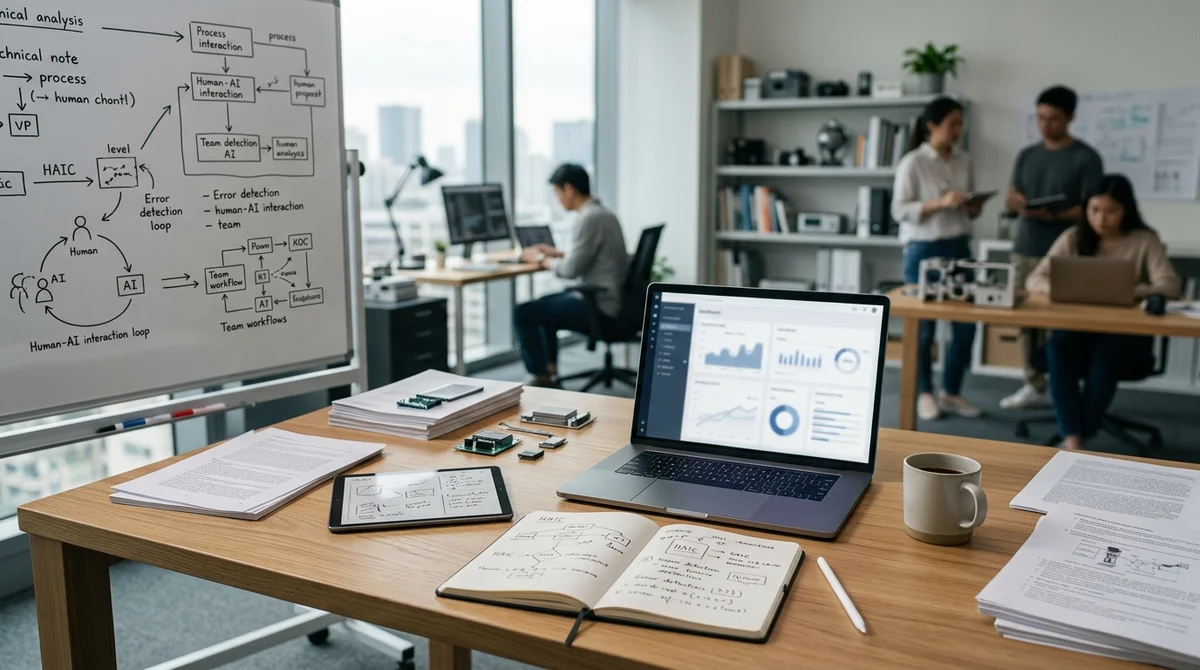
De bons scores aux benchmarks ne garantissent pas qu'un modèle d'IA sera utile une fois déployé dans des processus de travail réels.
Pourquoi l'IA réussit-elle les tests sans aider au travail ?
Les benchmarks actuels évaluent les modèles sur des tâches isolées, avec une réponse unique. Le travail réel, lui, exige que le système s'intègre aux équipes, aux processus et à des cycles de travail longs.
Comment évaluer correctement si l'IA aidera mon entreprise ?
Selon la chercheuse, il ne faut pas regarder les résultats obtenus en vase clos, mais le comportement des systèmes au sein d'équipes réelles, de processus métier et de cycles de travail complets.
Pourquoi les bons scores aux tests n'aident-ils pas à choisir une IA
pour l'entreprise ? Parce que les tests évaluent le modèle sur des tâches isolées, et non sur son fonctionnement au sein des équipes, des processus et des cycles de travail longs.
Questions clés sur cet article
Pourquoi l'IA réussit-elle les tests sans aider au travail ?
Les benchmarks actuels évaluent les modèles sur des tâches isolées, avec une réponse unique. Le travail réel, lui, exige que le système s'intègre aux équipes, aux processus et à des cycles de travail longs.
Comment évaluer correctement si l'IA aidera mon entreprise ?
Selon la chercheuse, il ne faut pas regarder les résultats obtenus en vase clos, mais le comportement des systèmes au sein d'équipes réelles, de processus métier et de cycles de travail complets.
Pourquoi les bons scores aux tests n'aident-ils pas à choisir une IA pour l'entreprise ?
Parce que les tests évaluent le modèle sur des tâches isolées, et non sur son fonctionnement au sein des équipes, des processus et des cycles de travail longs.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.