Hugging Face publie Ecom-RLVE, un terrain d'entraînement pour les agents IA des boutiques en ligne
Hugging Face a lancé Ecom-RLVE, un environnement d'entraînement pour les agents IA qui aident à acheter des produits dans les boutiques en ligne. Il comprend huit scénarios, de la recherche et de la constitution du panier aux retours et au suivi de commande, ainsi que des récompenses vérifiables pour la précision, l'efficacité et l'absence d'hallucinations. Les premiers tests montrent que cette approche révèle mieux les défaillances réelles que les benchmarks de chat habituels.
Traité par IA depuis Hugging Face Blog ; édité par Hamidun News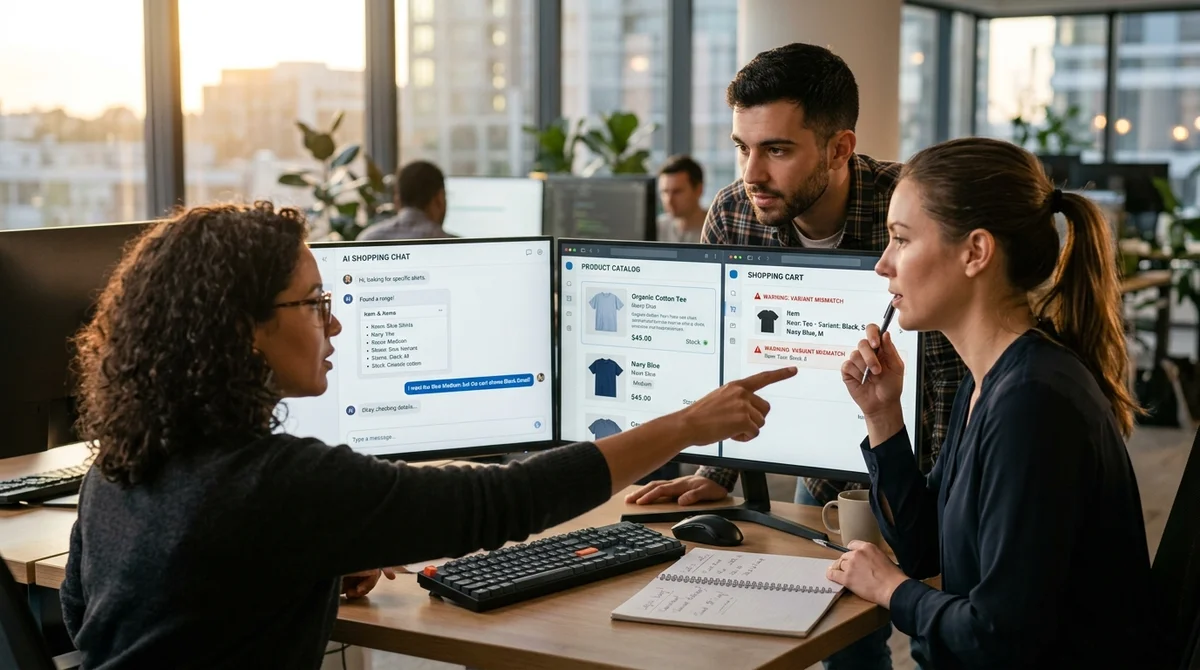
Hugging Face a publié Ecom-RLVE, un ensemble d'environnements vérifiables pour entraîner des agents IA conversationnels qui aident à acheter des produits dans les boutiques en ligne. Le projet fait passer l'apprentissage par renforcement des tâches abstraites à des scénarios réels en plusieurs étapes : recherche d'un produit, choix d'un substitut, constitution du panier, retours et suivi de commande.
Pourquoi les anciens benchmarks ne suffisent plus
Les grands modèles de langage savent depuis longtemps paraître convaincants, mais dans le e-commerce, cela ne suffit pas. Un utilisateur peut demander non pas simplement de « trouver un chargeur », mais de choisir un modèle à moins de 25 dollars, avec USB-C, livré en deux jours et compatible avec un appareil précis. Pour un agent, il ne s'agit plus d'une réponse de chat, mais d'une chaîne d'actions : trouver la fiche produit, vérifier les contraintes, choisir la bonne variante, ne pas se tromper de quantité et ne pas inventer ce qui n'existe pas dans le catalogue.
« Parler avec aisance ne revient pas à accomplir la tâche. »
Ecom-RLVE repose précisément sur cet écart.
Les auteurs prolongent l'idée de RLVE-Gym, où les modèles s'entraînaient sur des tâches vérifiables avec une récompense exacte, et la transposent au commerce conversationnel. Au lieu d'une évaluation subjective par un humain ou par un LLM-as-a-judge, l'environnement vérifie le résultat par du code : l'agent est-il tombé sur le bon produit, a-t-il choisi la bonne taille ou la bonne variante, a-t-il créé un retour pour le bon article, est-il resté dans la limite d'étapes.
Comment fonctionne l'environnement
Chaque épisode d'Ecom-RLVE se compose d'une tâche cachée, d'un utilisateur simulé et d'un ensemble d'outils avec lesquels travaille l'agent. Celui-ci ne se contente pas d'écrire du texte : il appelle des fonctions, cherche dans le catalogue, ajoute des articles au panier, pose des questions de clarification et ne termine le scénario que lorsque l'objectif est réellement atteint.
L'environnement couvre huit types de situations, de product discovery et product substitution à bundle planning, policy QA, order tracking et multi-intent journey. La récompense se compose de plusieurs éléments, afin que le modèle apprenne non seulement à « avoir l'air utile », mais à mener la tâche à son terme :
- une récompense pour l'exécution correcte de la tâche
- un bonus pour un nombre réduit d'étapes et d'appels d'outils
- une pénalité pour les hallucinations, par exemple des SKU ou des variantes inexistants
- un échec immédiat en cas d'actions invalides ou de non-respect du format d'appel
La difficulté adaptative mérite une mention à part. Au lieu de niveaux fixes easy/medium/hard, l'environnement introduit un nombre de difficulté d qui pilote simultanément 12 axes : nombre de contraintes, détails omis, produits similaires, fautes de frappe, ruptures de stock, changement d'intention en cours de dialogue et autres perturbations. Cela permet de construire un curriculum learning sans annotation manuelle et d'éviter de laisser le modèle trop longtemps sur des tâches devenues triviales.
Où le modèle décroche
L'article analyse en détail le scénario Cart Building, où l'agent doit constituer un panier de plusieurs produits avec des variantes et des quantités exactes. Pour empêcher la mémorisation de modèles, les développeurs synthétisent les variantes à la volée : type de connecteur pour l'électronique, taille pour les vêtements, matière ou couleur pour les articles de cuisine. Le modèle doit donc faire plus que « reconnaître le produit » : il lui faut réellement relier la demande de l'utilisateur à la bonne déclinaison du catalogue.
L'équipe a entraîné Qwen 3 8B sur cet environnement avec la méthode DAPO pendant 300 étapes sur la collection C1, et le benchmark prévoit aussi des modes C2, C4 et C8 pour s'entraîner sur deux, quatre et huit environnements. Le catalogue a été porté à deux millions de produits grâce à un index FAISS et aux embeddings gte-modernbert-base, et le simulateur d'utilisateur a été bâti sur Qwen3.5-9.
7B. D'après les résultats, l'agent a réussi à monter régulièrement vers des épisodes plus difficiles, et ses erreurs sont devenues bien visibles : le modèle peut choisir le bon produit mais se tromper de variante, oublier l'un des articles de la commande ou affirmer que la version voulue n'existe pas, alors qu'il l'avait vue quelques étapes plus tôt.
Ce que cela change
Pour le marché du shopping par IA, c'est un déplacement important : la compétition peut désormais porter non sur la fluidité du bot, mais sur sa fiabilité à mener un achat à son terme. Si ces environnements ouverts s'imposent, le secteur disposera d'un moyen plus honnête d'entraîner et de comparer les agents e-commerce : selon la qualité réelle de leurs actions, et non selon l'impression laissée par la conversation.
- 1 nov. 2026Les modèles locaux battus par Opus et Codex : 0,21 sur MacBook contre 1,00 pour Codex
- 1 nov. 2026Pika Labs publie H3 Flex, un modèle vidéo ouvert : 6 étapes au lieu de 50
- 1 nov. 2026Le tokenizer BERT de Hugging Face accéléré d'un facteur 50 en évitant le travail inutile sur l'ASCII
- 1 nov. 2026Illinois a rassemblé 12 151 problèmes ouverts pour tester si l'IA peut les résoudre
Questions clés sur cet article
Pourquoi les anciens benchmarks ne suffisent plus?
Les grands modèles de langage savent depuis longtemps paraître convaincants, mais dans le e-commerce, cela ne suffit pas. Un utilisateur peut demander non pas simplement de « trouver un chargeur », mais de choisir un modèle à moins de 25 dollars, avec USB-C, livré en deux jours et compatible avec un appareil précis. Pour un agent, il ne s'agit plus d'une réponse de chat, mais d'une chaîne d'actions : trouver la fiche produit, vérifier les contraintes, choisir la bonne variante, ne pas se tromper de quantité et ne pas inventer ce qui n'existe pas dans le catalogue. « Parler
Comment fonctionne l'environnement?
Chaque épisode d'Ecom-RLVE se compose d'une tâche cachée, d'un utilisateur simulé et d'un ensemble d'outils avec lesquels travaille l'agent. Celui-ci ne se contente pas d'écrire du texte : il appelle des fonctions, cherche dans le catalogue, ajoute des articles au panier, pose des questions de clarification et ne termine le scénario que lorsque l'objectif est réellement atteint. L'environnement couvre huit types de situations, de product discovery et product substitution à bundle planning, policy QA, order tracking et multi-intent journey. La récompense se compose de plusie
Que sait-on sur Où le modèle décroche ?
L'article analyse en détail le scénario Cart Building, où l'agent doit constituer un panier de plusieurs produits avec des variantes et des quantités exactes. Pour empêcher la mémorisation de modèles, les développeurs synthétisent les variantes à la volée : type de connecteur pour l'électronique, taille pour les vêtements, matière ou couleur pour les articles de cuisine. Le modèle doit donc faire plus que « reconnaître le produit » : il lui faut réellement relier la demande de l'utilisateur à la bonne déclinaison du catalogue. L'équipe a entraîné Qwen 3 8B sur cet environne
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.