AvatarBox, basé sur HeyGen, transforme une photo en vidéo parlante directement dans Telegram en 2 minutes
Telegram dispose désormais d'AvatarBox, un bot reposant sur l'API HeyGen qui génère une vidéo talking-head à partir d'une seule photo et d'un texte en 1 à 3 minutes. L'utilisateur envoie un portrait, choisit une voix et un format d'image, puis reçoit un clip avec sous-titres automatiques. L'outil convient aux vidéos de présentation personnelle, aux présentations et aux contenus sans tournage. Les vidéos longues, les chansons et les expressions faciales complexes restent pour l'instant ses points faibles.
Traité par IA depuis Habr AI ; édité par Hamidun News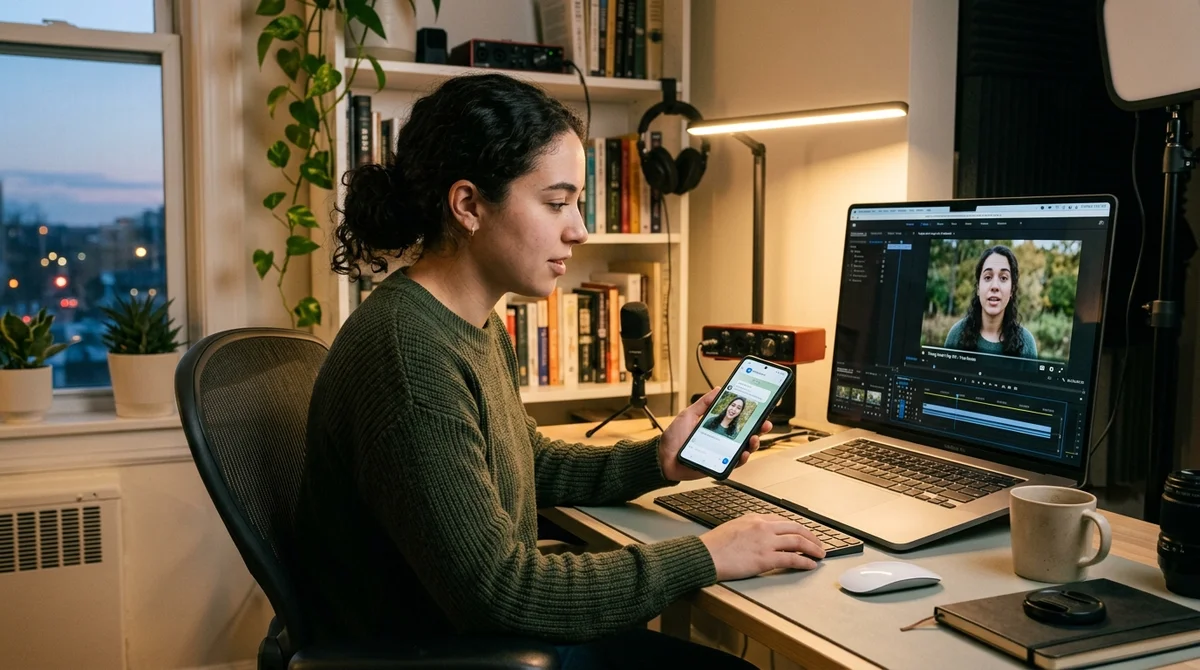
Telegram dispose désormais d'AvatarBox, un bot reposant sur l'API HeyGen qui transforme une seule photo et un court texte en vidéo avec un avatar parlant. L'utilisateur envoie un portrait, choisit une voix et un format d'image, et le clip fini arrive directement dans la conversation en 1 à 3 minutes environ.
Comment fonctionne AvatarBox
Le service est une simple surcouche de l'API HeyGen : l'utilisateur n'ouvre pas d'espace distinct, ne monte pas de scène dans un éditeur vidéo et ne règle pas le montage à la main. Toute la logique se résume au parcours habituel d'un bot Telegram. Il faut d'abord envoyer un portrait en gros plan, puis coller le texte que l'avatar doit prononcer, et enfin choisir une voix. Le bot renvoie une vidéo talking-head terminée, où le visage est synchronisé avec la parole et où les expressions paraissent assez naturelles pour des formats courts.
Le service propose plusieurs options pratiques qui en font un véritable outil de travail pour des clips rapides, et pas seulement une démo :
- Plus de 2000 voix en russe, en anglais et dans des centaines d'autres langues
- Trois formats d'image : 9:16, 1:1 et 16:9
- Réglage des émotions et de l'expressivité de la parole
- Sous-titres automatiques dans le clip final
- La première vidéo est gratuite et ne demande aucune carte bancaire
L'étape la plus importante est la préparation des sources. Les photos fonctionnent mieux de face, avec le regard droit vers la caméra, un fond neutre et un bon éclairage. Les photos de groupe, de profil, sombres, avec des lunettes de soleil ou des visages flous donnent de mauvais résultats. Pour le texte, l'auteur recommande de rester autour de 80 à 150 mots, ce qui suffit pour 30 à 60 secondes de parole. Il reste ensuite à choisir une voix, écouter l'aperçu et lancer la génération. Le bot traite la demande et renvoie la vidéo sans inscription sur des plateformes tierces.
Cas d'usage concrets
AvatarBox a été conçu comme un outil pour les blogueurs, mais les usages se sont révélés plus nombreux. Le format convient bien aux vidéos de présentation personnelle, quand il faut se présenter vite à un recruteur ou à un client sans se filmer. Il en va de même pour les présentations courtes, les pitchs et l'onboarding : au lieu d'un jeu de diapositives avec voix off, on peut monter un clip où l'avatar énonce les points clés et retient l'attention mieux qu'un simple texte à l'écran.
« Je pensais que le public principal, c'étaient les blogueurs.
Il s'est avéré que non ».
Une autre catégorie concerne les contenus sans présence personnelle à l'image. C'est utile à ceux qui ne veulent pas montrer leur visage mais souhaitent publier régulièrement des clips pour Telegram, Shorts ou des canaux internes d'entreprise. Autre scénario : les vidéos pédagogiques, où il faut produire vite des explications similaires sans studio ni micro.
Il existe aussi des usages plus légers : vœux, mèmes et clips personnalisés à partir de photos d'amis. Ces formats deviennent souvent les plus viraux, car ici la personnalisation compte plus que la production.
Où sont les limites
Le principal problème de ce type de service est qu'il ne fonctionne bien que sur un éventail étroit de tâches. Les vidéos longues trahissent vite leur origine artificielle : au-delà d'une minute, la parole et les expressions paraissent monotones. Les émotions complexes, comme une vive surprise, les larmes ou la colère, restent peu convaincantes. Les mains et les gestes ne prennent pas vie non plus, car l'animation est construite autour du visage et non du corps entier. Si la photo d'origine montre des paumes ou une pose active, cela risque plus de nuire que d'améliorer le résultat.
Il existe aussi des limites techniques de stabilité du personnage. Chaque génération peut différer légèrement de la précédente ; pour une série de clips, mieux vaut donc utiliser la même photo et ne pas attendre une cohérence parfaite. Le chant et les phrases musicales posent également problème : le lip sync est calibré pour la parole ordinaire, pas pour la voix chantée. Pour disposer de son propre présentateur virtuel, la voie logique consiste à générer d'abord un portrait réaliste dans n'importe quel générateur d'images, puis à utiliser ce cliché comme base permanente des clips.
Ce que cela change
Le seuil d'entrée de la vidéo talking-head continue de baisser. Ce format exigeait auparavant une caméra, de la lumière, un micro et du temps d'enregistrement ; il suffit désormais d'une photo, d'un texte et de quelques minutes d'attente dans Telegram. Pour les créateurs de contenu, le recrutement, la formation interne et les présentations rapides, c'est déjà un outil opérationnel. Mais il ne remplace pas encore la vidéo en direct : dès que le scénario exige une longue prise de parole, des expressions complexes ou de la gestuelle corporelle, les limites deviennent trop visibles.
Questions clés sur cet article
Comment fonctionne AvatarBox?
Le service est une simple surcouche de l'API HeyGen : l'utilisateur n'ouvre pas d'espace distinct, ne monte pas de scène dans un éditeur vidéo et ne règle pas le montage à la main. Toute la logique se résume au parcours habituel d'un bot Telegram. Il faut d'abord envoyer un portrait en gros plan, puis coller le texte que l'avatar doit prononcer, et enfin choisir une voix. Le bot renvoie une vidéo talking-head terminée, où le visage est synchronisé avec la parole et où les expressions paraissent assez naturelles pour des formats courts. Le service propose plusieurs options p
Que sait-on sur Cas d'usage concrets ?
AvatarBox a été conçu comme un outil pour les blogueurs, mais les usages se sont révélés plus nombreux. Le format convient bien aux vidéos de présentation personnelle, quand il faut se présenter vite à un recruteur ou à un client sans se filmer. Il en va de même pour les présentations courtes, les pitchs et l'onboarding : au lieu d'un jeu de diapositives avec voix off, on peut monter un clip où l'avatar énonce les points clés et retient l'attention mieux qu'un simple texte à l'écran. « Je pensais que le public principal, c'étaient les blogueurs. Il s'est avéré que non ». Un
Que sait-on sur Où sont les limites ?
Le principal problème de ce type de service est qu'il ne fonctionne bien que sur un éventail étroit de tâches. Les vidéos longues trahissent vite leur origine artificielle : au-delà d'une minute, la parole et les expressions paraissent monotones. Les émotions complexes, comme une vive surprise, les larmes ou la colère, restent peu convaincantes. Les mains et les gestes ne prennent pas vie non plus, car l'animation est construite autour du visage et non du corps entier. Si la photo d'origine montre des paumes ou une pose active, cela risque plus de nuire que d'améliorer le r
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.