NeuralSet et deep learning : décoder des caractéristiques du langage à partir des signaux MEG du cerveau
Une analyse de NeuralSet détaille un pipeline de bout en bout qui transforme des signaux MEG en prédictions de caractéristiques du langage. Dans l'exemple, le modèle estime la longueur d'un mot à partir de la réponse du cerveau, du chargement et du nettoyage des données jusqu'à l'entraînement d'un réseau de deep learning en pratique. Ce n'est pas un produit grand public tape-à-l'œil, mais un tutoriel pratique pour les neuroingénieurs, les laboratoires de recherche et les équipes qui développent des systèmes de neuroAI à partir de biosignaux réels.
Traité par IA depuis MarkTechPost ; édité par Hamidun News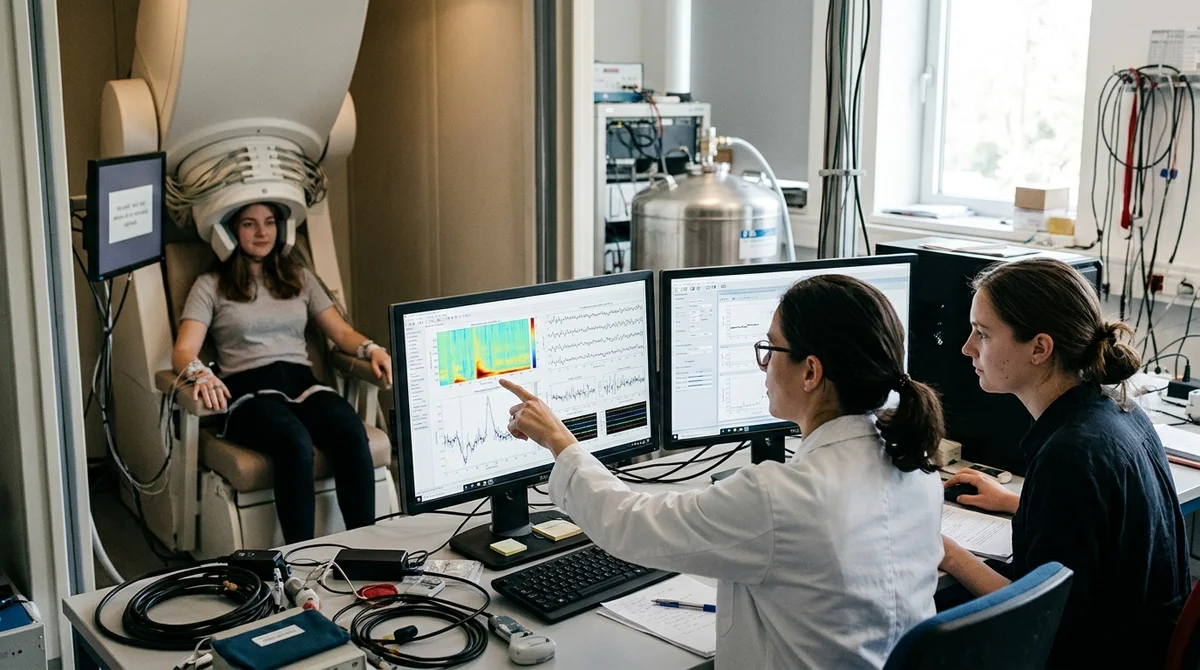
Une nouvelle analyse technique présente un pipeline de neuroAI qui extrait des caractéristiques du langage directement à partir de signaux MEG. En guise de démonstration, un système fondé sur NeuralSet et le deep learning tente de prédire la longueur d'un mot à partir de la réponse du cerveau à un stimulus linguistique.
Comment fonctionne le pipeline
L'intérêt du document tient à ce qu'il ne montre pas un fragment isolé de recherche, mais une chaîne d'ingénierie presque complète, de la préparation de l'environnement à l'entraînement du modèle sur des signaux neuronaux. Au centre : la MEG, une méthode qui enregistre les champs magnétiques produits par l'activité des neurones. Les données suivent ensuite le parcours classique en neuroAI : chargement, nettoyage, synchronisation avec les stimuli, constitution des exemples d'entraînement, puis envoi dans un réseau censé relier des motifs d'activité cérébrale à une propriété linguistique précise.
La tâche visée est assez terre à terre, mais révélatrice : le système estime la longueur du mot perçu par une personne en s'appuyant uniquement sur la réponse cérébrale. C'est une réserve importante. Il ne s'agit pas de « lire dans les pensées » librement, mais de prédire une caractéristique strictement définie dans une expérience contrôlée.
Ce format est utile aux développeurs et aux chercheurs : il permet de vérifier si une approche de bout en bout parvient à extraire du sens de biosignaux bruts ou à peine traités, sans découper le processus en des dizaines d'étapes manuelles.
Pourquoi la MEG compte
Pour les tâches linguistiques, la MEG est particulièrement pratique grâce à sa grande précision temporelle. Là où l'IRMf montre bien où l'activité se produit, la MEG convient mieux pour déterminer quand exactement le cerveau réagit à un mot, à un son ou à une caractéristique isolée du stimulus. Pour les tâches liées à la longueur des mots, à l'ordre des caractères ou au traitement sémantique précoce, cette dynamique à l'échelle de la milliseconde importe souvent davantage qu'une carte spatiale grossière. C'est pourquoi l'intérêt pour ces pipelines grandit non seulement chez les neuroscientifiques, mais aussi chez les équipes qui travaillent à la croisée de l'IA et des interfaces cerveau-machine.
Il faut aussi noter que l'analyse utilise NeuralSet comme socle pour organiser les données et le modèle. En pratique, c'est plus utile qu'une description aride d'une architecture sur le papier : le lecteur voit comment construire un processus reproductible, et pas seulement l'idée finale. Sur ces sujets, c'est généralement la reproductibilité qui freine les progrès. Même un bon modèle apporte peu si l'équipe ne peut pas monter rapidement l'environnement, mettre les enregistrements MEG dans un format unique et refaire l'expérience sur son propre échantillon sans assembler chaque étape à la main.
Ce que contient l'implémentation
D'après la description, le tutoriel couvre les étapes clés nécessaires à un premier prototype fonctionnel. Ce n'est pas un panorama abstrait des « réseaux de neurones pour le cerveau », mais une implémentation en code qui montre comment des données neuronales deviennent une tâche supervisée. Pour les ingénieurs, la valeur tient justement à ce pragmatisme : on peut prendre la base, changer la caractéristique cible, brancher un autre jeu de données et vérifier rapidement si la même approche fonctionne sur un nouveau problème.
- configuration de l'environnement Python et des dépendances du pipeline de neuroAI
- chargement des données MEG et prétraitement de base des signaux
- mise en relation des réponses cérébrales avec les stimuli linguistiques
- entraînement d'un modèle de deep learning pour prédire la longueur du mot
- évaluation des résultats et vérification de la quantité d'information linguistique utile que porte le signal
Ce format est particulièrement utile maintenant que le marché des outils d'IA s'éloigne rapidement des modèles purement textuels pour aller vers des interfaces multimodales et à base de biosignaux. Même si la tâche de la longueur du mot paraît étroite, elle répond à une question plus générale : peut-on extraire de façon stable des caractéristiques structurées d'un signal cérébral complexe sans lourde ingénierie manuelle ? Si la réponse est au moins en partie positive, la même approche pourra s'étendre à la phonétique, à la catégorie du mot, aux classes sémantiques et à d'autres niveaux de l'analyse linguistique.
Ce que cela signifie
La valeur pratique de cette publication ne réside pas dans de grandes promesses, mais dans l'abaissement du seuil d'entrée en neuroAI. Quand les développeurs disposent d'un code reproductible pour travailler avec la MEG et les caractéristiques du langage, le domaine passe plus vite des belles diapositives de recherche à des systèmes vérifiables. Pour l'industrie, ce n'est pas encore un produit fini, mais c'est déjà une voie claire vers les futures interfaces cerveau-machine et de nouveaux outils d'étude de la parole.
Questions clés sur cet article
Comment fonctionne le pipeline?
L'intérêt du document tient à ce qu'il ne montre pas un fragment isolé de recherche, mais une chaîne d'ingénierie presque complète, de la préparation de l'environnement à l'entraînement du modèle sur des signaux neuronaux. Au centre : la MEG, une méthode qui enregistre les champs magnétiques produits par l'activité des neurones. Les données suivent ensuite le parcours classique en neuroAI : chargement, nettoyage, synchronisation avec les stimuli, constitution des exemples d'entraînement, puis envoi dans un réseau censé relier des motifs d'activité cérébrale à une propriété
Pourquoi la MEG compte?
Pour les tâches linguistiques, la MEG est particulièrement pratique grâce à sa grande précision temporelle. Là où l'IRMf montre bien où l'activité se produit, la MEG convient mieux pour déterminer quand exactement le cerveau réagit à un mot, à un son ou à une caractéristique isolée du stimulus. Pour les tâches liées à la longueur des mots, à l'ordre des caractères ou au traitement sémantique précoce, cette dynamique à l'échelle de la milliseconde importe souvent davantage qu'une carte spatiale grossière. C'est pourquoi l'intérêt pour ces pipelines grandit non seulement chez
Que sait-on sur Ce que contient l'implémentation ?
D'après la description, le tutoriel couvre les étapes clés nécessaires à un premier prototype fonctionnel. Ce n'est pas un panorama abstrait des « réseaux de neurones pour le cerveau », mais une implémentation en code qui montre comment des données neuronales deviennent une tâche supervisée. Pour les ingénieurs, la valeur tient justement à ce pragmatisme : on peut prendre la base, changer la caractéristique cible, brancher un autre jeu de données et vérifier rapidement si la même approche fonctionne sur un nouveau problème. configuration de l'environnement Python et des dép
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.