Google publie WAXAL, un jeu de données vocales ouvert pour les langues africaines
Google a ouvert WAXAL, un jeu de données vocales pour les langues africaines, censé accélérer la reconnaissance et la synthèse vocales dans les langues peu dotées. Pour la reconnaissance, la parole naturelle a été recueillie via la description d'images ; pour la synthèse, des enregistrements plus propres à partir de textes équilibrés. Google montre aussi que le projet s'étend déjà, couvre des dizaines de langues et continuera d'être enrichi.
Traité par IA depuis MarkTechPost ; édité par Hamidun News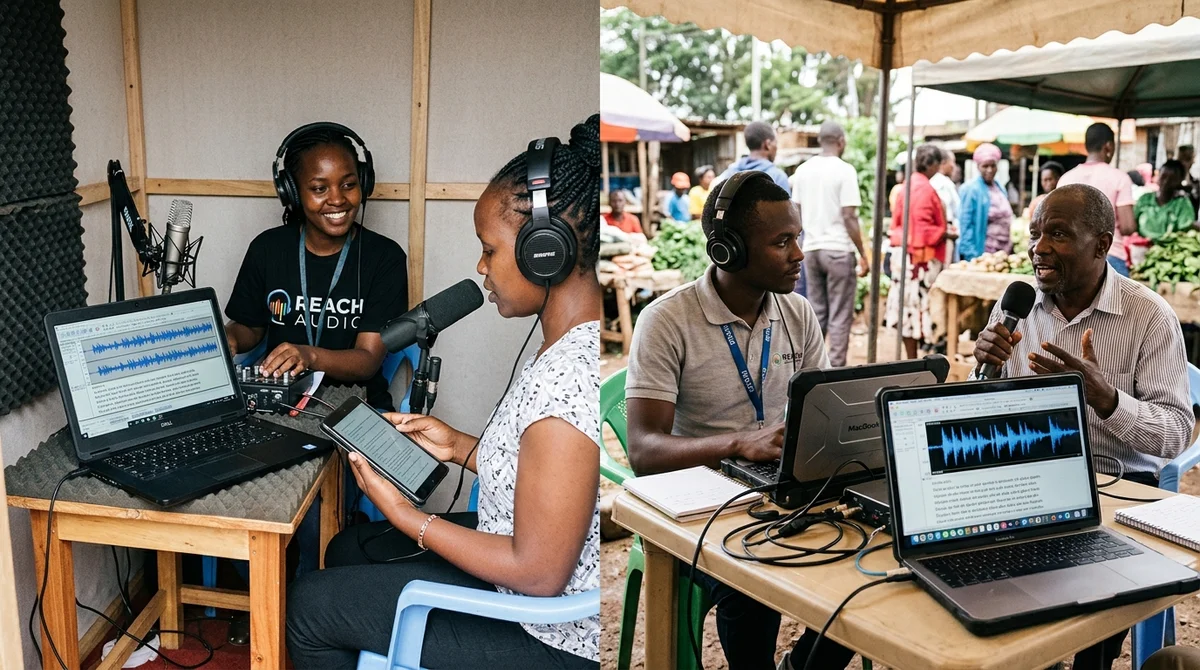
Google a ouvert WAXAL, un vaste corpus vocal pour les langues africaines, conçu comme socle pour les systèmes de reconnaissance et de synthèse vocales. Le projet vise un marché où les technologies vocales progressent nettement plus lentement, faute chronique de données ouvertes de qualité.
Pourquoi c'est important
Depuis longtemps, le principal problème de l'IA vocale n'est pas les modèles eux-mêmes, mais la répartition des données. Pour l'anglais, l'espagnol ou le chinois, il existe d'immenses corpus ouverts et commerciaux, si bien que la reconnaissance et la synthèse vocales y progressent vite. Pour de nombreuses langues africaines, c'est l'inverse : peu de parole annotée, peu d'enregistrements de qualité, peu de licences ouvertes. Résultat, des locuteurs de langues parlées par des millions de personnes subissent encore une moins bonne qualité de dictée, de sous-titrage automatique, d'assistants vocaux et de voix d'interface.
WAXAL tente de combler précisément ce déficit d'infrastructure.
Fait notable, le projet paraît déjà vivant, et non une archive figée. Dans la description technique, l'équipe évoque 24 langues et un jeu de départ pour les tâches de reconnaissance et de synthèse vocales. Le billet de lancement de Google du 6 mars 2026 fait état d'une livraison initiale élargie : 27 langues, plus de 1 846 heures de données pour la reconnaissance vocale et plus de 565 heures pour la synthèse. Autrement dit, Google n'a pas simplement publié un jeu de données ; elle semble bâtir une base ouverte à long terme pour des langues généralement laissées de côté par les grandes plateformes d'IA.
Comment WAXAL est conçu
WAXAL est scindé en deux parties indépendantes, car la reconnaissance et la synthèse vocales n'ont pas les mêmes exigences en matière de données. La première demande des locuteurs variés, un environnement naturel et de la parole spontanée pour que le modèle fonctionne mieux en conditions réelles. La seconde exige un son plus propre, des textes phonétiquement équilibrés et un enregistrement contrôlé ; sinon, il est difficile d'obtenir une voix naturelle et stable. En ce sens, WAXAL ne ressemble pas à un « dossier d'audio » générique, mais à un jeu de données pensé pour deux classes de tâches.
- Pour la reconnaissance vocale, les participants devaient décrire des images dans leur langue maternelle plutôt que lire des scripts préparés.
- Google indique que ces consignes couvraient plus de 50 thèmes et faisaient mieux ressortir une parole vivante, y compris les nuances tonales et le passage d'une langue à l'autre.
- Pour la synthèse, des textes phonétiquement équilibrés et des conditions d'enregistrement plus contrôlées ont été utilisés.
- Le jeu de données est publié sous licence ouverte CC-BY-4.0, afin de pouvoir servir à la recherche comme aux produits appliqués.
Qui a collecté les données
L'élément clé du projet n'est pas seulement le volume, mais la méthode de collecte. Google n'a pas travaillé seule, mais avec des universités et des organisations locales africaines, parmi lesquelles Makerere University, University of Ghana, Digital Umuganda, African Institute for Mathematical Sciences Senegal, Media Trust et Loud and Clear Communications. Ce format compte, car les équipes locales comprennent mieux les habitudes de parole, le mélange des langues, les variantes régionales de prononciation et les contextes où les gens parlent réellement, au lieu de lire un texte dans le silence d'un laboratoire.
«
Le corpus a été créé par la communauté et pour la communauté qui en a besoin. »
Les détails de fabrication sont aussi intéressants. Pour la partie TTS, les participants ont préparé des textes de 10 à 20 000 mots et travaillé en binômes : l'un lisait, l'autre enregistrait et vérifiait la qualité. Pour obtenir un son plus propre, certaines équipes ont même construit leurs propres cabines d'enregistrement.
Google souligne à part que WAXAL doit aider non seulement les benchmarks académiques, mais aussi des usages concrets : interfaces vocales locales, dictée automatique, transcription automatique, voix de services et systèmes conversationnels qui doivent comprendre la parole vivante, et pas seulement un texte parfaitement lu.
Un écosystème appliqué et de recherche commence déjà à se former autour du corpus. Google mentionne des travaux de collecte de données pour des personnes ayant des troubles de la parole, un autre grand corpus pour cinq langues du Ghana et des benchmarks pour des modèles comme Whisper, XLS-R, MMS et W2v-BERT sur des langues africaines. C'est un bon signe : WAXAL sert non seulement d'archive, mais aussi de point d'appui commun pour comparer les modèles, repérer les faiblesses et amener plus vite les produits vocaux à une qualité exploitable.
Ce que cela signifie
WAXAL abaisse la barrière d'entrée pour les startups, les chercheurs et les équipes locales qui veulent développer de l'IA vocale ailleurs que pour les langues mondiales. Si de tels corpus ouverts grandissent et sont régulièrement mis à jour, les langues africaines auront une chance de rattraper plus vite le reste du marché en qualité de reconnaissance, de synthèse et d'accessibilité des services numériques.
- 1 nov. 2026Test de 16 modèles sur 7 moteurs de recherche : Exa obtient en moyenne 10,5 points sur 14, SearXNG environ 3
- 1 nov. 2026L'agent vidéo StreamVibe de Google devance les autres modèles de 10,7 % sur le timing et la qualité des réponses
- 1 nov. 2026OpenAI réécrit les règles de comportement de GPT : cinq valeurs et une chaîne de priorités
- 1 nov. 2026Les bots vocaux à base de LLM s'appuient sur le classifieur rapide Jev : une décision en 200–500 ms
Questions clés sur cet article
Pourquoi c'est important?
Depuis longtemps, le principal problème de l'IA vocale n'est pas les modèles eux-mêmes, mais la répartition des données. Pour l'anglais, l'espagnol ou le chinois, il existe d'immenses corpus ouverts et commerciaux, si bien que la reconnaissance et la synthèse vocales y progressent vite. Pour de nombreuses langues africaines, c'est l'inverse : peu de parole annotée, peu d'enregistrements de qualité, peu de licences ouvertes. Résultat, des locuteurs de langues parlées par des millions de personnes subissent encore une moins bonne qualité de dictée, de sous-titrage automatique
Comment WAXAL est conçu?
WAXAL est scindé en deux parties indépendantes, car la reconnaissance et la synthèse vocales n'ont pas les mêmes exigences en matière de données. La première demande des locuteurs variés, un environnement naturel et de la parole spontanée pour que le modèle fonctionne mieux en conditions réelles. La seconde exige un son plus propre, des textes phonétiquement équilibrés et un enregistrement contrôlé ; sinon, il est difficile d'obtenir une voix naturelle et stable. En ce sens, WAXAL ne ressemble pas à un « dossier d'audio » générique, mais à un jeu de données pensé pour deux
Que sait-on sur Qui a collecté les données ?
L'élément clé du projet n'est pas seulement le volume, mais la méthode de collecte. Google n'a pas travaillé seule, mais avec des universités et des organisations locales africaines, parmi lesquelles Makerere University, University of Ghana, Digital Umuganda, African Institute for Mathematical Sciences Senegal, Media Trust et Loud and Clear Communications. Ce format compte, car les équipes locales comprennent mieux les habitudes de parole, le mélange des langues, les variantes régionales de prononciation et les contextes où les gens parlent réellement, au lieu de lire un te
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.