Baidu lance Qianfan-OCR, un modèle de 4B pour reconnaître et comprendre les documents
Baidu a présenté Qianfan-OCR, un modèle de 4B qui réunit OCR, analyse de mise en page et compréhension de documents dans une seule architecture. Au lieu d'un pipeline en plusieurs étapes, le système convertit directement l'image en Markdown et prend en charge des tâches pilotées par prompt, comme l'extraction de tableaux, les réponses aux questions sur le document et l'automatisation de processus internes. C'est un pas de plus vers des services d'IA documentaire intelligents pour les entreprises.
Traité par IA depuis MarkTechPost ; édité par Hamidun News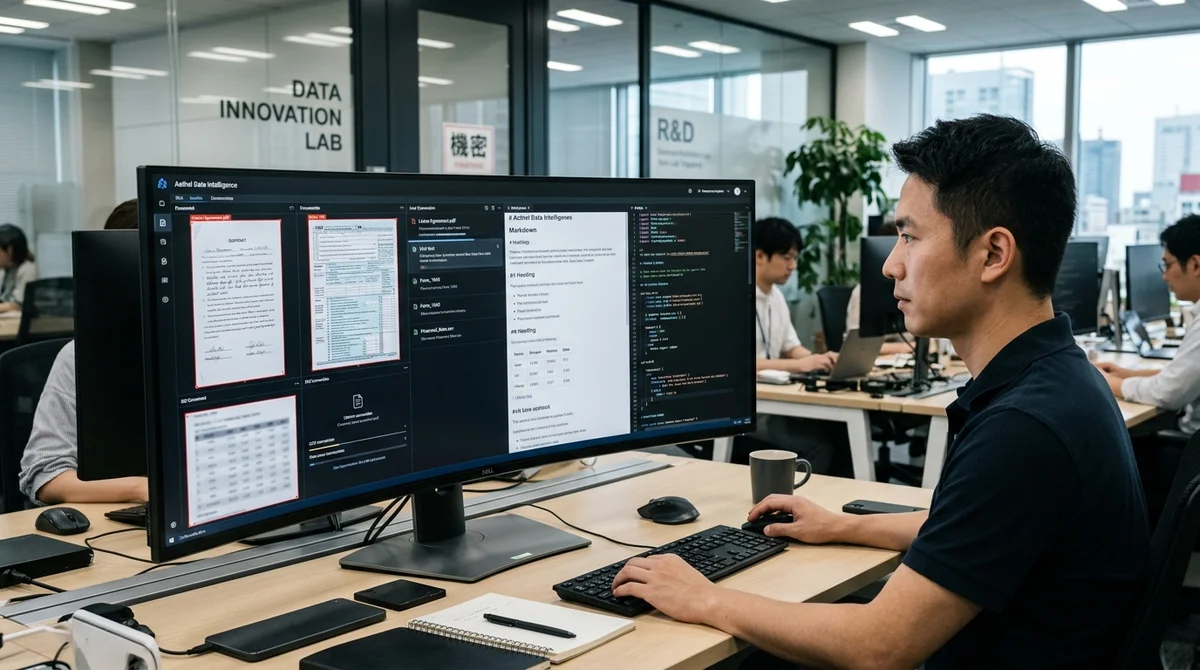
Baidu a dévoilé Qianfan-OCR, un modèle unifié de 4B pour le travail sur les documents, qui réunit reconnaissance de texte, analyse de la structure et compréhension du contenu. Au lieu du pipeline OCR classique en plusieurs étapes, le système transforme directement l'image du document en Markdown structuré et sait exécuter des tâches à la demande de l'utilisateur.
Pourquoi le marché s'éloigne des pipelines OCR
Les systèmes OCR classiques sont généralement assemblés à partir de plusieurs blocs indépendants : l'un repère les zones de la page, un autre reconnaît le texte, un troisième tente de comprendre les tableaux, les titres et l'ordre de lecture. Cette approche fonctionne tant que le document est simple, mais elle se met à dérailler face aux mises en page complexes, aux scans, aux formulaires, aux contenus mixtes, aux gabarits atypiques et aux fichiers de plusieurs pages. Plus la chaîne compte d'étapes, plus le risque est grand qu'une erreur précoce gâche tout le résultat.
Dans ce contexte, Baidu Qianfan mise sur une approche vision-langage unique. Qianfan-OCR doit non seulement lire des caractères, mais aussi percevoir le document comme un objet complet : avec des blocs, une structure, une logique et un sens. Pour les entreprises, c'est un changement important, car elles n'ont généralement pas besoin du texte en lui-même, mais de données prêtes à servir dans la recherche, l'analytique, l'automatisation et les scénarios d'IA internes, y compris les processus en production.
Ce que sait faire Qianfan-OCR
D'après la description de l'équipe, il s'agit d'un modèle de bout en bout de 4 milliards de paramètres, qui réunit l'analyse de documents, le layout analysis et le document understanding dans une seule architecture. La principale différence avec l'OCR habituel tient à ce que le modèle ne s'appuie pas sur une longue série de modules connectés les uns après les autres. Il reçoit une image en entrée et produit immédiatement un résultat structuré, y compris la conversion d'image en Markdown. Cela réduit sensiblement le nombre de transformations intermédiaires.
La logique pilotée par prompt mérite une mention à part. Le modèle peut servir non seulement à la reconnaissance de base, mais aussi à des tâches appliquées, où l'utilisateur formule précisément ce qu'il faut extraire du document. L'article cite expressément des scénarios comme l'extraction de tableaux et les réponses à des questions sur le document. Cela rapproche l'OCR d'une interface de travail sur les fichiers d'entreprise dans les flux de travail des sociétés, plutôt que d'un outil d'archivage de scans.
Le format Markdown compte lui aussi. Pour les équipes qui construisent des bases de connaissances, de la recherche par IA ou des pipelines pour LLM, il ne suffit pas d'obtenir du texte sans structure. Il faut des titres, des listes, des tableaux et un ordre logique des blocs. Si le modèle livre d'emblée le document sous une forme adaptée au traitement automatique, cela réduit le post-traitement et rend le résultat plus adapté à l'indexation automatique, au résumé et à une couche ultérieure de questions-réponses. Pour l'intégration, c'est un avantage net.
- Conversion directe de l'image du document en Markdown
- Analyse de la structure de la page sans pipeline distinct de plusieurs modules
- Extraction de tableaux à la demande de l'utilisateur
- Réponses aux questions sur le contenu du document
- Un modèle unique à la place d'un ensemble de composants disparates
Où cela peut servir
L'intérêt pratique de ces modèles est de réduire le nombre d'opérations intermédiaires entre le document et l'action utile. Si le système comprend vraiment de façon stable la mise en page, le texte et le sens en une seule passe, le traitement des contrats, notices, rapports, formulaires, présentations et bases de connaissances internes s'en trouve simplifié. C'est particulièrement pertinent pour les équipes qui veulent convertir automatiquement des PDF et des scans dans un format adapté au RAG, à la recherche de connaissances ou à une analyse ultérieure par LLM.
Pour les développeurs et les équipes produit, un autre point compte : l'unification réduit la complexité d'ingénierie. Au lieu de maintenir plusieurs services d'OCR et de post-traitement, on peut bâtir une pile plus courte. Cela ne garantit pas une qualité parfaite sur chaque type de document, mais la direction est claire : le marché passe d'un ensemble de détecteurs spécialisés à de grands modèles qui traitent le document comme un objet multimodal, le préparent immédiatement pour les tâches downstream et lancent plus vite de nouveaux scénarios.
Ce que cela signifie
Qianfan-OCR montre que l'OCR cesse rapidement d'être une technologie étroite de reconnaissance de caractères pour devenir une couche d'intelligence documentaire. Si ces modèles confirment leur qualité en situation réelle, les entreprises auront plus de facilité à automatiser le travail sur les documents, sans pipelines complexes en plusieurs étapes ni assemblage manuel de composants séparés. Les grands gagnants seront les équipes qui ont besoin de passer vite des PDF et des scans à des données prêtes pour la recherche, l'analytique et les assistants d'IA.
Questions clés sur cet article
Pourquoi le marché s'éloigne des pipelines OCR?
Les systèmes OCR classiques sont généralement assemblés à partir de plusieurs blocs indépendants : l'un repère les zones de la page, un autre reconnaît le texte, un troisième tente de comprendre les tableaux, les titres et l'ordre de lecture. Cette approche fonctionne tant que le document est simple, mais elle se met à dérailler face aux mises en page complexes, aux scans, aux formulaires, aux contenus mixtes, aux gabarits atypiques et aux fichiers de plusieurs pages. Plus la chaîne compte d'étapes, plus le risque est grand qu'une erreur précoce gâche tout le résultat. Dans
Que sait-on sur Ce que sait faire Qianfan-OCR ?
D'après la description de l'équipe, il s'agit d'un modèle de bout en bout de 4 milliards de paramètres, qui réunit l'analyse de documents, le layout analysis et le document understanding dans une seule architecture. La principale différence avec l'OCR habituel tient à ce que le modèle ne s'appuie pas sur une longue série de modules connectés les uns après les autres. Il reçoit une image en entrée et produit immédiatement un résultat structuré, y compris la conversion d'image en Markdown. Cela réduit sensiblement le nombre de transformations intermédiaires. La logique piloté
Que sait-on sur Où cela peut servir ?
L'intérêt pratique de ces modèles est de réduire le nombre d'opérations intermédiaires entre le document et l'action utile. Si le système comprend vraiment de façon stable la mise en page, le texte et le sens en une seule passe, le traitement des contrats, notices, rapports, formulaires, présentations et bases de connaissances internes s'en trouve simplifié. C'est particulièrement pertinent pour les équipes qui veulent convertir automatiquement des PDF et des scans dans un format adapté au RAG, à la recherche de connaissances ou à une analyse ultérieure par LLM. Pour les dé
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.