Machine Learning Mastery identifie cinq obstacles majeurs au passage à l'échelle de l'IA agentique en 2026
Machine Learning Mastery a publié une analyse expliquant pourquoi l'IA agentique reste difficile à déployer à l'échelle en production en 2026. Les principaux goulots d'étranglement : une complexité d'orchestration qui explose, une observabilité faible, des coûts imprévisibles, des méthodes de test immatures et des garde-fous en retard. Sans ces couches, l'autonomie devient vite source de pannes, de risques et de dépassements de budget, surtout pour les entreprises qui ont de vrais utilisateurs et des SLA.
Traité par IA depuis Machine Learning Mastery ; édité par Hamidun News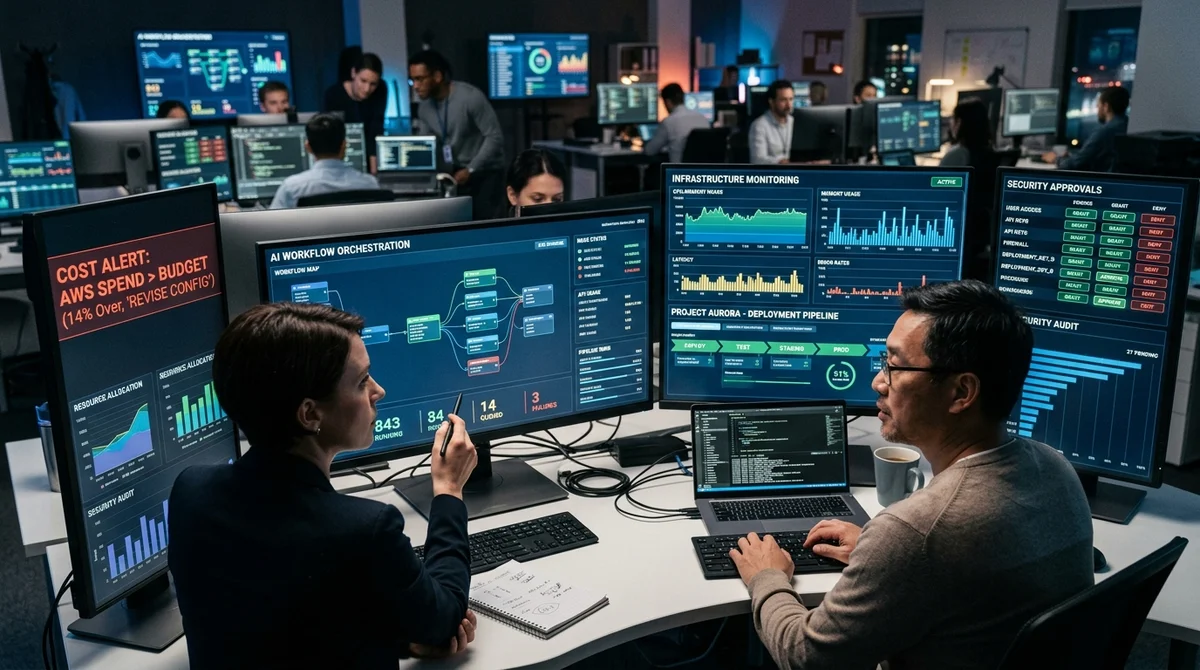
Machine Learning Mastery a publié un article sur cinq problèmes qui freinent l'adoption massive de l'IA agentique en production. L'idée centrale est simple : entre une démo impressionnante et un système qui tient la charge de façon stable, il existe une couche d'ingénierie à part, et c'est elle qui casse le plus souvent aujourd'hui.
Où l'orchestration casse
Tant qu'il n'y a qu'un seul agent chargé d'une tâche étroite, le pipeline semble maîtrisé. Mais dès que le système se met à confier des tâches à d'autres agents, à choisir des outils à la volée et à relancer les étapes en échec, la complexité croît non pas de façon linéaire, mais quasiment de façon explosive. Les équipes butent moins sur les limites des modèles que sur la coordination : les agents s'attendent mutuellement, les scénarios asynchrones tombent sur des race conditions et une erreur à une étape déclenche une panne en cascade à une autre.
«
Les démos paraissent impressionnantes et les prototypes semblent magiques. »
C'est pourquoi un montage qui tient sans broncher à une centaine de requêtes par minute peut s'effondrer à plusieurs dizaines de milliers. Résultat : les entreprises construisent leurs propres orchestrateurs, puis découvrent que cette couche est la plus coûteuse et la plus fragile de toute la stack. Pour les équipes ML, c'est un changement d'état d'esprit : il ne suffit plus de choisir un bon modèle, il faut aussi savoir concevoir un système distribué au comportement prévisible sous charge.
Observabilité et argent
Le deuxième problème est la faible observabilité. Les métriques habituelles, comme la latence et le débit, ne suffisent plus : pour l'IA agentique, il faut voir tout le parcours d'exécution. Pourquoi l'agent a-t-il choisi un outil plutôt qu'un autre ? Pourquoi a-t-il répété une étape trois fois ? Pourquoi le résultat final a-t-il échoué si chaque étape intermédiaire semblait normale ?
L'infrastructure de traçage approfondi pour ces scénarios reste immature, et le comportement des systèmes eux-mêmes est non déterministe. Une même requête peut emprunter des branches différentes, ce qui rend la reproduction et la correction des incidents nettement plus difficiles.
Dans ce contexte, un troisième sujet remonte vite : le coût. Une seule requête agentique se compose souvent de dizaines d'appels à des LLM, et en production cela se traduit aussitôt par une facture salée. Même un prix d'environ 15 cents par scénario ne paraît supportable que jusqu'à ce que le volume atteigne des centaines de milliers d'exécutions par jour.
Les équipes d'ingénierie misent donc déjà sur quelques techniques de base :
- router les sous-tâches simples vers des modèles moins chers
- mettre en cache de façon agressive les résultats intermédiaires
- un kill switch pour les boucles incontrôlées et les relances infinies
- des limites strictes sur le nombre d'étapes, d'appels et de tentatives
Le problème, c'est que l'économie entre presque toujours en conflit avec la qualité. Réduire le nombre d'étapes accroît le risque d'erreur. Basculer une partie des tâches vers un modèle moins cher donne un résultat moins stable. Surtout, les budgets sont difficiles à prévoir à l'avance : un cas atypique peut déclencher une longue chaîne de relances et rendre une seule requête des dizaines de fois plus chère que d'habitude.
Tests et contrôle
Le quatrième obstacle est l'absence d'une approche mature des tests. Le logiciel classique repose sur un comportement déterministe, et le ML classique sur un lien fixe entre entrée et sortie. L'IA agentique met en défaut les deux modèles à la fois. Aujourd'hui, les équipes vérifient ces systèmes avec du LLM-as-a-judge, des jeux de tests par scénarios et des simulations dans des environnements synthétiques, mais il n'existe pas encore de standard commun. Les benchmarks sont fragmentés, l'outillage est éparpillé et la vérification humaine reste le principal garde-fou, même si elle passe mal à l'échelle.
Le cinquième problème est la gouvernance et la sécurité. Un agent ne se contente plus d'écrire du texte : il envoie des e-mails, modifie des données, appelle des services externes et peut potentiellement lancer des transactions. Il faut donc des droits d'accès, une confirmation des actions, des limites de périmètre et un audit détaillé. Mais plus les garde-fous sont stricts, plus le sentiment d'autonomie s'amenuise et plus l'effet « wow » du produit s'estompe.
Le facteur réglementaire pèse aussi : dès que ces systèmes touchent directement les clients, les questions de responsabilité, de conformité et de vérifiabilité des décisions cessent d'être théoriques.
Ce que cela signifie
Le marché de l'IA agentique s'est heurté non pas à la qualité des démos, mais à l'infrastructure qui les entoure. Les gagnants ne seront pas ceux qui assembleront le plus vite le prochain agent, mais ceux qui mettront en place avant les autres l'orchestration, le traçage, les tests, la maîtrise des budgets et les mécanismes de protection.
- 1 nov. 2026Les modèles locaux battus par Opus et Codex : 0,21 sur MacBook contre 1,00 pour Codex
- 1 nov. 2026Le juge d'EditAgent (Adobe) retient une retouche valable dans 81,3% des cas, contre 74,8% pour EditScore
- 1 nov. 2026Test de 16 modèles sur 7 moteurs de recherche : Exa obtient en moyenne 10,5 points sur 14, SearXNG environ 3
- 1 nov. 2026L'agent vidéo StreamVibe de Google devance les autres modèles de 10,7 % sur le timing et la qualité des réponses
Questions clés sur cet article
Que sait-on sur Où l'orchestration casse ?
Tant qu'il n'y a qu'un seul agent chargé d'une tâche étroite, le pipeline semble maîtrisé. Mais dès que le système se met à confier des tâches à d'autres agents, à choisir des outils à la volée et à relancer les étapes en échec, la complexité croît non pas de façon linéaire, mais quasiment de façon explosive. Les équipes butent moins sur les limites des modèles que sur la coordination : les agents s'attendent mutuellement, les scénarios asynchrones tombent sur des race conditions et une erreur à une étape déclenche une panne en cascade à une autre. « Les démos paraissent im
Que sait-on sur Observabilité et argent ?
Le deuxième problème est la faible observabilité. Les métriques habituelles, comme la latence et le débit, ne suffisent plus : pour l'IA agentique, il faut voir tout le parcours d'exécution. Pourquoi l'agent a-t-il choisi un outil plutôt qu'un autre ? Pourquoi a-t-il répété une étape trois fois ? Pourquoi le résultat final a-t-il échoué si chaque étape intermédiaire semblait normale ? L'infrastructure de traçage approfondi pour ces scénarios reste immature, et le comportement des systèmes eux-mêmes est non déterministe. Une même requête peut emprunter des branches différent
Que sait-on sur Tests et contrôle ?
Le quatrième obstacle est l'absence d'une approche mature des tests. Le logiciel classique repose sur un comportement déterministe, et le ML classique sur un lien fixe entre entrée et sortie. L'IA agentique met en défaut les deux modèles à la fois. Aujourd'hui, les équipes vérifient ces systèmes avec du LLM-as-a-judge, des jeux de tests par scénarios et des simulations dans des environnements synthétiques, mais il n'existe pas encore de standard commun. Les benchmarks sont fragmentés, l'outillage est éparpillé et la vérification humaine reste le principal garde-fou, même si
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.