agent-pool pour Google AI et Gemini CLI ajoute pipelines, cron et bounce-back
agent-pool, un serveur MCP pour Google AI et Gemini CLI, transforme les flux multi-agents en véritables pipelines. Il peut lancer des étapes sur déclencheurs, renvoyer des tâches à l'étape précédente via bounce-back, planifier des scénarios avec cron et envoyer des workers vers un serveur distant par SSH. Ce n'est plus un simple ensemble de tâches déléguées, mais l'embryon d'un véritable AgentOps sur un seul abonnement.
Traité par IA depuis Habr AI ; édité par Hamidun News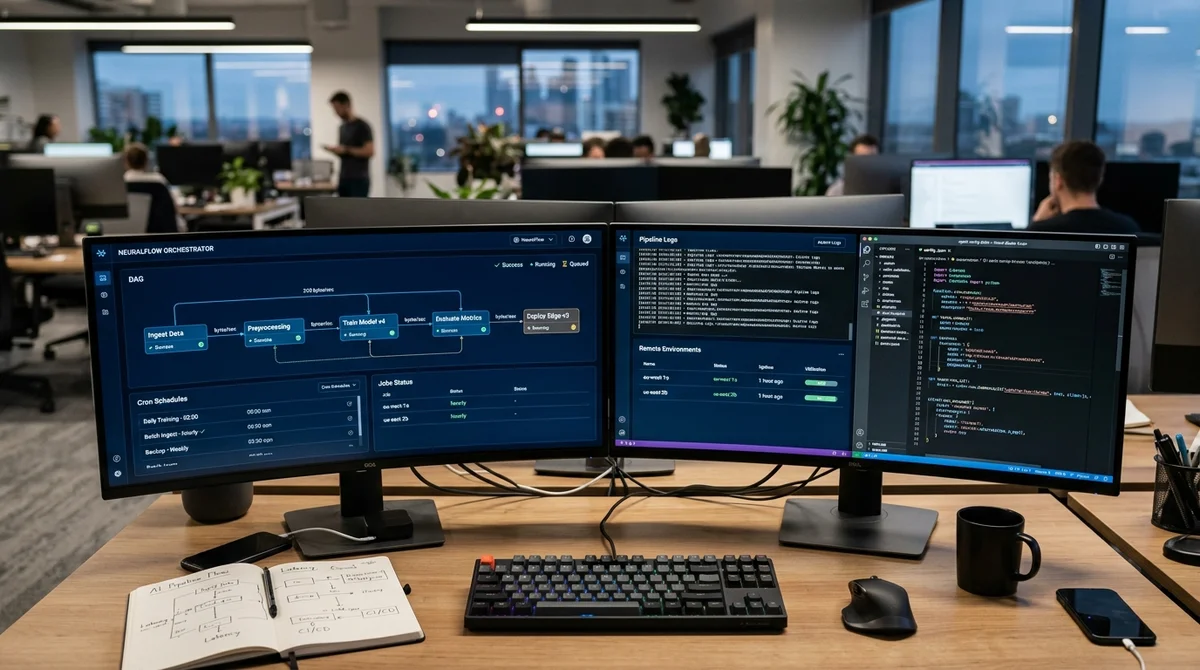
Une nouvelle couche open source d'orchestration d'agents est apparue pour Google AI et Gemini CLI. Le serveur MCP agent-pool rassemble des délégations éparses en pipelines, peut renvoyer des tâches pour reprise, les exécuter selon un calendrier et déporter l'exécution sur des machines distantes.
Orchestration automatique
Le problème que rencontrent presque tous les scénarios multi-agents est simple : l'agent principal passe trop de temps non pas à travailler, mais à répartir les tâches. Si les étapes dépendent les unes des autres (analyse, refactorisation, tests, déploiement), l'orchestrateur doit interroger les statuts, analyser les réponses et lancer à la main l'exécutant suivant. agent-pool déplace cette logique vers un démon en arrière-plan. Avec create_pipeline, les étapes et leurs dépendances sont décrites à l'avance, et le processus continue de tourner même après un redémarrage de l'IDE.
L'idée clé n'est pas seulement de lancer un worker, mais de donner aux agents un langage de coordination. À la fin d'une étape, l'exécutant envoie un signal d'achèvement, et si des données manquent, la tâche peut repartir en reprise avec une explication du motif. Ce bounce-back ressemble à Request Changes dans une revue de code : l'étape précédente complète l'artefact et le remet dans la chaîne. Le pipeline n'est plus un script linéaire, mais une boucle pilotée, avec un nombre de retours plafonné.
«
Un worker peut lui-même déléguer des tâches plus loin : toute l'orchestration fractale repose là-dessus ».
L'article décrit les principaux mécanismes de ce schéma :
- on_complete — lance l'étape suivante après la fin d'un worker précis
- on_complete_all — attend tout le groupe et fait un fan-in avant l'étape suivante
- on_file — réagit à l'apparition d'un fichier sur le disque
- signal_step_complete — indique au démon que l'étape est réellement terminée
- bounce_back — renvoie la tâche en arrière, et maxBounces limite le nombre de cycles
Cron et SSH
La planification est une fonction à part. L'outil schedule_task utilise le format cron classique : on peut donc programmer un agent au quotidien ou à l'heure sans planificateur distinct. Point important, le démon pose des verrous de fichiers atomiques : même si l'on ouvre plusieurs fenêtres d'IDE en même temps, une même tâche ne s'exécute qu'une seule fois. Les résultats sont déposés dans le dossier scheduled-results, ce qui permet d'utiliser le scénario aussi bien pour des vérifications routinières de serveurs que pour la compilation périodique de rapports hebdomadaires.
Si la machine locale ne suffit pas, les workers peuvent être envoyés sur un serveur distant par SSH. Le runner se décrit dans la configuration d'agent-pool, puis des tâches précises s'exécutent sur une machine dédiée où Gemini CLI est installé. L'intérêt pratique est évident : tests, refactorisation ou analyse massive de code se poursuivent même une fois l'ordinateur portable fermé. L'auteur décrit ainsi un flux de travail type : les agents travaillent sur une branche séparée, font des commits et poussent le résultat, et le matin le développeur ouvre simplement une pull request et relit le résultat.
Contexte et contrôle
Autre détail utile : la transmission du contexte entre agents via les sessions intégrées de Gemini CLI. Un worker peut terminer une recherche et enregistrer un session_id, puis le suivant reprend la même conversation et poursuit sans qu'on lui résume à nouveau ce qui a été trouvé. Sur de longues chaînes, cela économise des tokens et réduit les erreurs aux jonctions entre étapes : le second agent voit non pas un résumé sec, mais l'historique complet de l'analyse. Les sessions actives peuvent par ailleurs être consultées séparément et, si besoin, rejointes manuellement.
Il existe aussi une couche de restrictions, nécessaire pour un vrai travail d'équipe. Via policy, on peut donner à l'agent un mode lecture seule ou une édition sécurisée sans droit d'exécuter des commandes. Si cela ne suffit pas, les règles se définissent plus finement dans un fichier YAML distinct. Le paramètre include_dirs complète ce modèle : par défaut, le worker ne voit que le répertoire de travail, et l'accès à des configurations externes ou à des dossiers supplémentaires doit être activé explicitement. Cette approche rend l'automatisation nettement plus sûre qu'un accès total et inconditionnel à tout le projet.
Enfin, agent-pool introduit des groupes, en somme des modèles d'équipes fractales. Dans un groupe, on peut enregistrer une fois pour toutes le runner, la skill, la politique et la limite max_agents, puis y envoyer plusieurs exécutants à la fois sans dupliquer les réglages. Ces groupes persistent d'un redémarrage de l'IDE à l'autre et se branchent directement aux pipelines. Si une étape doit s'exécuter en parallèle, le démon lance plusieurs agents, leur attribue des indices et attend le résultat commun. Le fail-fast s'applique : si un worker plante avec une erreur ou envoie un bounce-back, les autres processus sont aussitôt annulés pour ne pas gaspiller temps et ressources.
Ce que cela signifie
Pour les développeurs, c'est le signe que l'AgentOps commence à passer du stade des expériences à celui des outils du quotidien. Quand pipelines, planificateur, runners distants et contrôle des droits s'articulent autour d'un seul abonnement Google AI, les scénarios multi-agents cessent d'être une démonstration et deviennent une infrastructure de travail pour le code, les tests et l'automatisation courante.
- 1 nov. 2026Test de 16 modèles sur 7 moteurs de recherche : Exa obtient en moyenne 10,5 points sur 14, SearXNG environ 3
- 1 nov. 2026L'agent vidéo StreamVibe de Google devance les autres modèles de 10,7 % sur le timing et la qualité des réponses
- 1 nov. 2026OpenAI réécrit les règles de comportement de GPT : cinq valeurs et une chaîne de priorités
- 1 nov. 2026Les bots vocaux à base de LLM s'appuient sur le classifieur rapide Jev : une décision en 200–500 ms
Questions clés sur cet article
Que sait-on sur Orchestration automatique ?
Le problème que rencontrent presque tous les scénarios multi-agents est simple : l'agent principal passe trop de temps non pas à travailler, mais à répartir les tâches. Si les étapes dépendent les unes des autres (analyse, refactorisation, tests, déploiement), l'orchestrateur doit interroger les statuts, analyser les réponses et lancer à la main l'exécutant suivant. agent-pool déplace cette logique vers un démon en arrière-plan. Avec create_pipeline, les étapes et leurs dépendances sont décrites à l'avance, et le processus continue de tourner même après un redémarrage de l'
Que sait-on sur Cron et SSH ?
La planification est une fonction à part. L'outil schedule_task utilise le format cron classique : on peut donc programmer un agent au quotidien ou à l'heure sans planificateur distinct. Point important, le démon pose des verrous de fichiers atomiques : même si l'on ouvre plusieurs fenêtres d'IDE en même temps, une même tâche ne s'exécute qu'une seule fois. Les résultats sont déposés dans le dossier scheduled-results, ce qui permet d'utiliser le scénario aussi bien pour des vérifications routinières de serveurs que pour la compilation périodique de rapports hebdomadaires. S
Que sait-on sur Contexte et contrôle ?
Autre détail utile : la transmission du contexte entre agents via les sessions intégrées de Gemini CLI. Un worker peut terminer une recherche et enregistrer un session_id, puis le suivant reprend la même conversation et poursuit sans qu'on lui résume à nouveau ce qui a été trouvé. Sur de longues chaînes, cela économise des tokens et réduit les erreurs aux jonctions entre étapes : le second agent voit non pas un résumé sec, mais l'historique complet de l'analyse. Les sessions actives peuvent par ailleurs être consultées séparément et, si besoin, rejointes manuellement. Il ex
Build & Ship Production AI Agents Without Boilerplate Code
Start your free 72-hour trial at Hamidun Academy (academy.hamidun.com) — interactive lessons on Claude Code & Cursor, live Tech Radar, and production agent templates.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.