Sergey Smirnov explique comment préparer un agent IA à fonctionner de façon fiable en production
Sergey Smirnov, ingénieur IA en exercice, affirme qu'entre la version démo d'un agent et la production réelle, il y a un travail d'ingénierie à part entière. Selon lui, il ne suffit pas de lancer le système : il faut atteindre la fiabilité, la prévisibilité et un niveau de qualité qui permette de confier l'agent aux utilisateurs sans crainte. Le document est conçu comme une feuille de route pour préparer les systèmes d'agents à l'exploitation.
Traité par IA depuis Habr AI ; édité par Hamidun News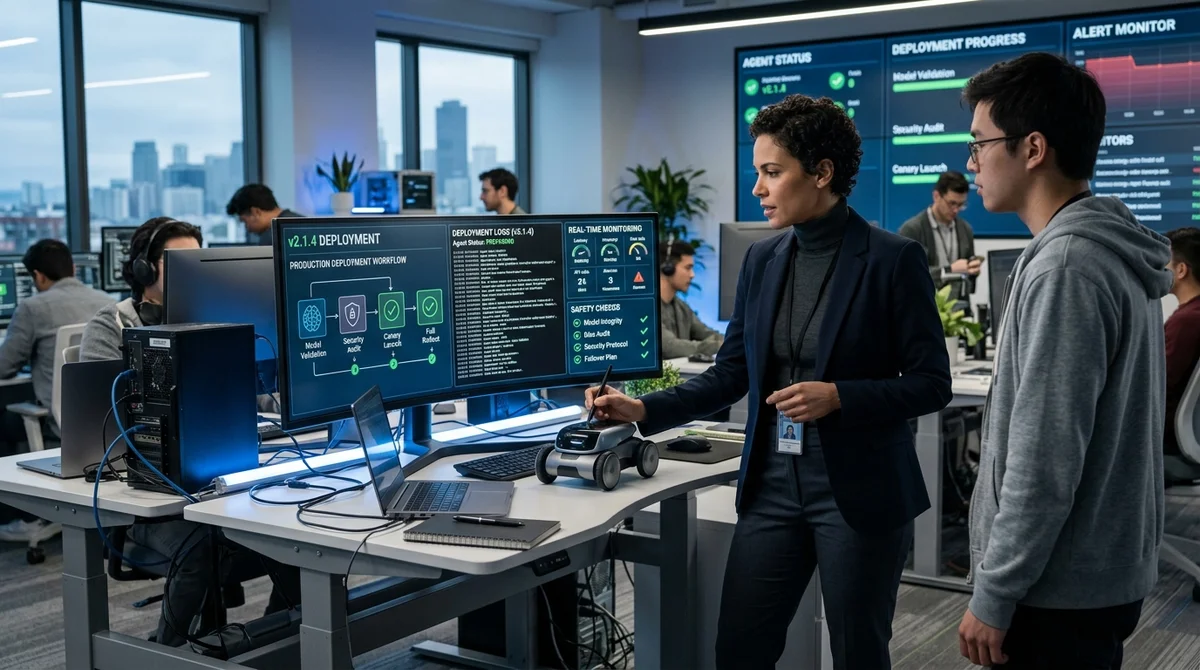
L'ingénieur IA en exercice Sergey Smirnov a publié un texte expliquant pourquoi le lancement d'un agent IA en production est une tâche d'ingénierie à part entière, et non l'étape finale après une démo réussie. Son article propose une feuille de route pour les équipes qui n'ont pas besoin d'un prototype spectaculaire, mais d'un service prêt pour de vrais utilisateurs.
De la démo au service
L'idée centrale est simple : un agent qui impressionne sur un banc d'essai n'est pas encore prêt à être exploité. Au sein de l'équipe, on peut pardonner des réponses instables, des pannes aléatoires et des contournements manuels, mais dans un produit, ces compromis se transforment vite en pertes de temps, d'argent et de confiance. L'accent se déplace donc du modèle lui-même vers l'outillage d'ingénierie qui l'entoure : scénarios de défaillance, contrôle du comportement, journalisation, limites sur les actions et règles claires selon lesquelles le système soit accomplit la tâche, soit s'arrête honnêtement.
Smirnov décrit l'objectif de la préparation d'un agent en termes très concrets : il faut que le produit puisse être confié aux utilisateurs sans crainte. C'est là toute la différence entre une expérience et la production. L'équipe doit savoir où l'agent se débrouille seul, où il a besoin d'un parcours rigide et où il vaut mieux passer immédiatement la tâche à un humain. Sinon, même un modèle performant sèmera le chaos dans les interfaces, les processus métier et les attentes des utilisateurs.
« pour qu'il fonctionne de façon fiable, prévisible et sans crainte de
le confier à de vrais utilisateurs ».
Où naissent les risques
Le passage en production brise généralement l'illusion qu'un agent n'est qu'un prompt bien choisi. En pratique, les problèmes surgissent simultanément à plusieurs niveaux : les données d'entrée changent, le nombre d'exceptions augmente, les utilisateurs formulent les tâches autrement que les développeurs, et le coût des erreurs devient mesurable. Si l'agent appelle des outils externes, travaille avec des API ou exécute des actions en plusieurs étapes, la moindre branche peu évidente du scénario se met à multiplier les pannes.
C'est pourquoi la feuille de route de préparation comprend généralement plusieurs volets obligatoires :
- la validation des données d'entrée et des limites explicites sur les actions de l'agent
- l'observabilité : journaux, traçage des étapes et analyse des sessions échouées
- des tests sur les cas limites, et pas seulement sur de beaux cas de démo
- des mécanismes de retour arrière, de confirmation et de transfert de la tâche à un humain
Cet ensemble paraît plus austère qu'une énième comparaison de modèles, mais c'est lui qui détermine si le système tiendra face à une charge réelle. Plus l'agent est autonome, plus il importe de restreindre d'avance son champ de décision et de prévoir une sortie sûre en cas d'erreur. Sinon, le produit semblera intelligent jusqu'au premier cas massif, après lequel l'équipe ira éteindre des incendies au lieu de faire évoluer la fonctionnalité.
Feuille de route du lancement
D'après l'annonce de l'article, l'auteur propose de voir le lancement d'un agent comme un processus par étapes. D'abord, l'équipe formule une tâche appliquée où l'agent apporte une valeur claire et un résultat mesurable. Ensuite, elle vérifie le scénario de base sur un petit ensemble de cas, et ajoute seulement après tout ce qui sépare un prototype d'un service : supervision, contrôle des coûts, évaluation de la qualité, protection contre les actions indésirables et un schéma clair de responsabilité entre le modèle, les outils et l'humain.
Cette approche compte particulièrement dans le marché actuel, où les interfaces d'agents se montent vite et où les exigences de qualité augmentent plus vite encore. L'utilisateur ne cherchera pas à savoir si le modèle s'est trompé, si l'API a flanché ou si le prompt s'est révélé fragile : pour lui, tout le produit est en panne. La maturité d'un système d'agents se mesure donc non au nombre d'outils connectés, mais à la prévisibilité du résultat, à la rapidité d'analyse des erreurs et à la capacité de l'équipe à améliorer le comportement de façon reproductible après chaque défaillance.
Ce que cela signifie
Le texte de Smirnov répond bien à la demande actuelle du marché : les entreprises ne se contentent plus de démonstrations, elles veulent des agents qu'on peut intégrer à de vrais processus. Pour les équipes, c'est un signal pour déplacer le focus de l'effet waouh vers la discipline d'exploitation, c'est elle qui transforme un prototype LLM en produit.
- 2 nov. 2026DeepSeek ouvre le code d'un prototype de Super-agent : p95 du temps d'exécution de 15,7 min contre 29,5
- 2 nov. 2026Le créateur de Bun migre 750 000 lignes de Zig vers Rust en 11 jours avec Claude Code
- 2 nov. 2026Microsoft publie Mage-VL-Cowork, un modèle de 4B qui résout 66,0% des tâches d'OSWorld-Verified
- 2 nov. 2026L'assistant Muse de Meta tient un dossier sur vos proches et obtient root par défaut sous Ubuntu
Questions clés sur cet article
Que sait-on sur De la démo au service ?
L'idée centrale est simple : un agent qui impressionne sur un banc d'essai n'est pas encore prêt à être exploité. Au sein de l'équipe, on peut pardonner des réponses instables, des pannes aléatoires et des contournements manuels, mais dans un produit, ces compromis se transforment vite en pertes de temps, d'argent et de confiance. L'accent se déplace donc du modèle lui-même vers l'outillage d'ingénierie qui l'entoure : scénarios de défaillance, contrôle du comportement, journalisation, limites sur les actions et règles claires selon lesquelles le système soit accomplit la t
Que sait-on sur Où naissent les risques ?
Le passage en production brise généralement l'illusion qu'un agent n'est qu'un prompt bien choisi. En pratique, les problèmes surgissent simultanément à plusieurs niveaux : les données d'entrée changent, le nombre d'exceptions augmente, les utilisateurs formulent les tâches autrement que les développeurs, et le coût des erreurs devient mesurable. Si l'agent appelle des outils externes, travaille avec des API ou exécute des actions en plusieurs étapes, la moindre branche peu évidente du scénario se met à multiplier les pannes. C'est pourquoi la feuille de route de préparatio
Que sait-on sur Feuille de route du lancement ?
D'après l'annonce de l'article, l'auteur propose de voir le lancement d'un agent comme un processus par étapes. D'abord, l'équipe formule une tâche appliquée où l'agent apporte une valeur claire et un résultat mesurable. Ensuite, elle vérifie le scénario de base sur un petit ensemble de cas, et ajoute seulement après tout ce qui sépare un prototype d'un service : supervision, contrôle des coûts, évaluation de la qualité, protection contre les actions indésirables et un schéma clair de responsabilité entre le modèle, les outils et l'humain. Cette approche compte particulière
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.