SENAR introduit des portes de qualité pour le développement assisté par IA : comment spécifications et métriques réduisent les erreurs
Habr publie le quatrième volet de la série consacrée à SENAR, une méthodologie de développement avec des agents IA. Andreï Ioumachev y explique pourquoi il ne faut jamais confier une tâche à un agent sans spécification formelle. Selon lui, la clôture doit rester bloquée tant que les critères n'ont pas été vérifiés, que les corrections manuelles n'ont pas été consignées et que la mémoire du projet n'a pas été mise à jour. L'article détaille aussi les métriques FPSR, MIR, DER et ERR, ainsi que leur lien avec la qualité de la formulation des tâches.
Traité par IA depuis Habr AI ; édité par Hamidun News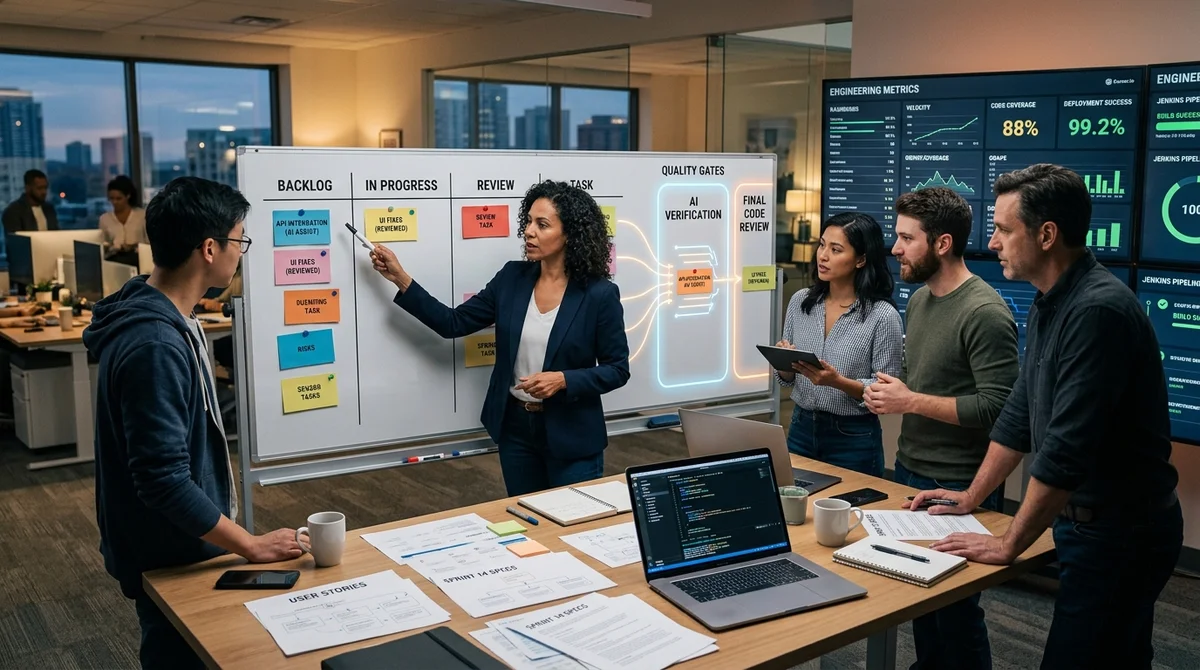
Habr publie le quatrième article de la série consacrée à SENAR, une méthodologie ouverte pour le développement avec des agents IA. Andreï Ioumachev y décrit comment des « portes » formelles, en entrée comme en sortie, doivent remplacer la discipline personnelle de celui qui formule la tâche et réduire le nombre d'erreurs qui n'apparaissent qu'une fois la tâche clôturée.
Comment fonctionne SENAR L'auteur présente SENAR comme une
méthodologie d'ingénierie pour travailler avec des agents IA en développement. Elle n'est pas née de la théorie, mais de la pratique : selon Ioumachev, plus d'une trentaine de projets sont passés par ce mode de fonctionnement en un an et demi. Dans ces projets, l'agent écrivait de plus en plus souvent le code, tandis que l'humain se chargeait de formuler les tâches, de valider les livrables et d'analyser les défaillances.
L'idée centrale de l'article est simple : l'agent ne conserve pas le contexte d'une exécution à l'autre, suit la formulation au pied de la lettre et tombe facilement dans l'optimisation locale si la tâche est décrite avec négligence. Pour chaque tâche, SENAR s'appuie sur plusieurs éléments obligatoires : un objectif formel exprimé dans une logique produit des critères d'acceptation vérifiables un bloc distinct de scénarios négatifs le périmètre des modifications et le contexte architectural * des métriques signal sur la qualité du processus L'auteur insiste : il ne s'agit pas de remplacer les tests, les linters ou la revue de code. La logique est différente : les vérifications classiques portent sur le code, tandis que les portes examinent la tâche elle-même avant son lancement, puis la qualité de sa validation une fois terminée.
Dans TAUSIK, l'implémentation pratique, ces étapes sont intégrées directement à l'outil : impossible de les sauter sans contourner le système lui-même. C'est précisément ce qui, selon l'auteur, protège l'équipe de la fatigue « du vendredi », quand ce sont justement les plus petites tâches qui se glissent le plus souvent en production avec un défaut.
Ce que vérifient les portes En entrée, SENAR utilise la porte QG-0.
Elle bloque le démarrage d'une tâche tant que celle-ci ne contient pas une spécification minimale : objectif, critères d'acceptation, scénarios négatifs, périmètre des modifications et lien vers le contexte architectural. Ioumachev conteste en particulier une idée répandue selon laquelle on pourrait confier les petites tâches à un agent « en une ligne ». D'après ses observations, ce sont justement ces tâches qui cassent le plus souvent en production, car celui qui les formule garde les détails importants en tête sans les consigner dans la fiche.
« Ce n'est pas l'agent qui a sauté l'étape, c'est moi. »
En sortie intervient QG-2, une porte qui bloque la clôture de la tâche tant que le résultat n'a pas été confronté aux engagements pris en entrée. L'auteur distingue trois vérifications obligatoires : la validation de chaque critère d'acceptation par un test, une vérification manuelle ou un artefact ; la consignation de toutes les corrections manuelles apportées après le passage de l'agent ; la mise à jour de la mémoire du projet si la tâche a révélé un nouveau cas limite ou une particularité d'infrastructure. Ce fonctionnement ne relève pas de la bureaucratie : il vise à éviter que l'agent ne répète les mêmes erreurs à la tâche suivante à cause de corrections apportées en silence par un humain.
Métriques et limites
Une partie de l'article est consacrée aux métriques que SENAR utilise comme signaux de l'état du processus. FPSR mesure la part des tâches résolues du premier coup ; MIR, la fréquence à laquelle une correction manuelle a été nécessaire après l'agent ; DER mesure les impasses et le temps perdu ; ERR reflète les tâches qu'il a fallu réparer après leur clôture. D'après le journal de travail de l'auteur, sur des tâches backend dans un domaine familier, le FPSR est passé d'environ 40% à 75–80%, le MIR du projet Sortule est tombé de 20% à 5–7%, et l'ERR a reculé d'environ 15% à 6%.
Ioumachev décrit toutefois honnêtement les limites de la méthodologie. Les portes aident peu lorsque le résultat est difficile à formaliser : le « ressenti » d'une interface, le ton d'un texte ou l'intuition produit. Elles ne sont pas non plus d'un grand secours avec des services externes, lorsque la documentation tierce contredit le comportement réel de l'API.
Dans ces cas, un processus formel peut préserver la structure de la tâche, mais ne remplace ni la connaissance du domaine, ni la vérification manuelle des hypothèses, ni l'étude préalable de l'intégration.
Ce que cela signifie SENAR ne se présente pas comme un recueil de
conseils, mais comme un cadre opérationnel strict pour le développement assisté par IA : sans spécification correcte, l'agent ne démarre pas ; sans validation confirmée, la tâche n'est pas clôturée. Pour les équipes qui confient déjà une partie du code à des agents, le signal est fort : le principal risque ne tient plus seulement au modèle, mais aussi à la qualité de la formulation des tâches, à la mémoire du projet et à la discipline du processus.
- 2 nov. 2026DeepSeek ouvre le code d'un prototype de Super-agent : p95 du temps d'exécution de 15,7 min contre 29,5
- 2 nov. 2026Le créateur de Bun migre 750 000 lignes de Zig vers Rust en 11 jours avec Claude Code
- 2 nov. 2026Microsoft publie Mage-VL-Cowork, un modèle de 4B qui résout 66,0% des tâches d'OSWorld-Verified
- 2 nov. 2026L'assistant Muse de Meta tient un dossier sur vos proches et obtient root par défaut sous Ubuntu
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.