DeepSeek et Gemma : comment une expérience de LLM hybride sur Kaggle a cassé la bibliothèque Transformers
Sur Kaggle, des passionnés ont tenté le quasi impossible : prendre les poids de 31B de Gemma, les transplanter dans l'ossature MoE de DeepSeek et lancer l'hybride sans réentraînement. Il a fallu patcher Transformers, contourner un plantage d'initialisation des poids 4 bits et chercher à la main des experts cachés. Le modèle obtenu s'exprime de façon incohérente, mais l'expérience montre jusqu'où l'on peut aller avec PyTorch, Hugging Face et une série de bidouilles.
Traité par IA depuis Habr AI ; édité par Hamidun News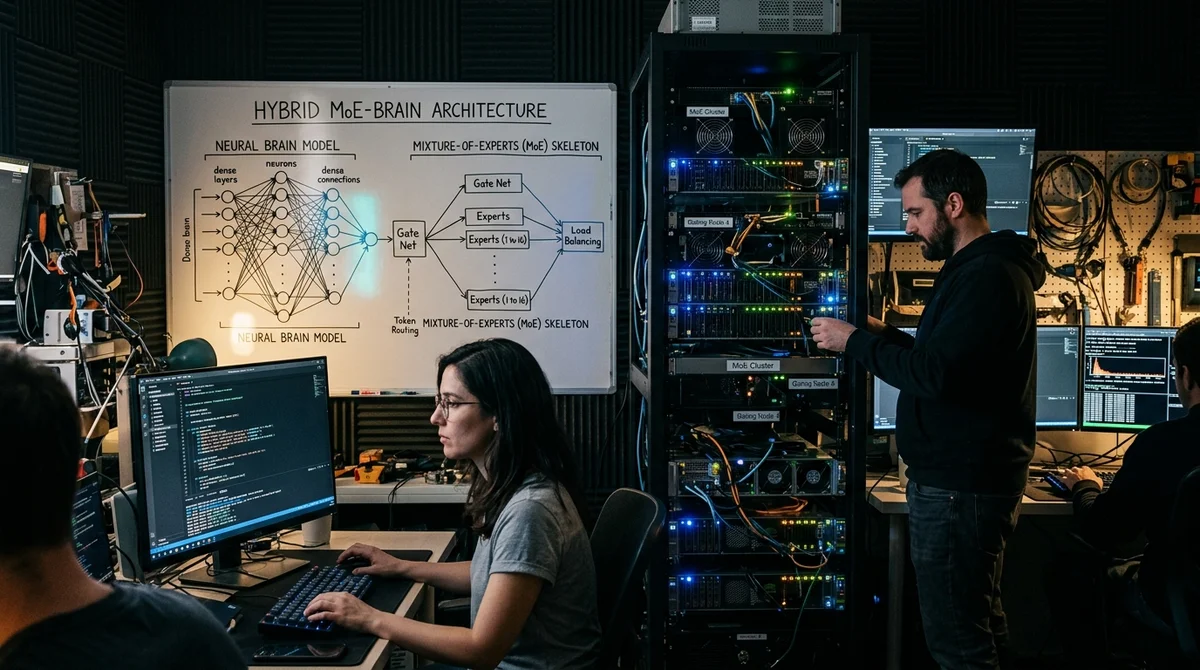
Des passionnés ont assemblé un LLM hybride presque contre les règles : ils ont pris quatre couches du modèle Gemma de 31B et les ont intégrées dans une architecture MoE vide de DeepSeek-V4, sans réentraînement. Il n'en est pas sorti un concurrent fonctionnel de ChatGPT, mais le processus a montré à quel point on peut malmener PyTorch et Transformers pour tester une idée extrême.
Pourquoi un hybride
L'idée est née de contraintes très dures : deux GPU T4 gratuits sur Kaggle, environ 30 Go de RAM et aucun budget pour un fine-tuning complet. Plutôt que d'entraîner, les auteurs ont choisi de tester un scénario plus brut : l'épissage structurel de modèles. Le donneur était Gemma-4-31B, compressé au format NF4 en 4 bits, et le « squelette » un DeepSeek-V4 vide doté d'un routeur Mixture-of-Experts. La tâche sonnait presque comme un mème : greffer une partie des poids d'une architecture dans une autre et voir si la chimère pouvait seulement être ranimée.
Sur le plan de l'ingénierie, le projet intéressait non par la qualité des réponses, mais par le fait même de la compatibilité. Gemma et DeepSeek ont des dimensions différentes, leur propre logique de normalisation, des blocs d'attention distincts et leurs propres règles de routage des tokens entre experts. Dans les manuels, un tel transfert est généralement jugé impossible sans projections intermédiaires ni réentraînement. Les auteurs ont délibérément enfreint cette règle et monté une expérience de survie pour les bibliothèques : qu'est-ce qui lâcherait en premier, le modèle, la mémoire de Kaggle ou la pile Hugging Face elle-même.
Là où tout s'est effondré
Le premier échec est survenu dès le chargement. Transformers a refusé de reconnaître correctement le type personnalisé `gemma4`, puis a planté avec l'erreur `dict.to_dict()`, car un module interne sérialisait la configuration en simple dictionnaire avant de tenter aussitôt de la traiter comme un objet. Pour aller plus loin, les auteurs ont enregistré le type à la main dans `CONFIG_MAPPING` et ajouté un monkey patch pour `GenerationConfig`, qui enveloppe le dictionnaire dans un objet proxy à la volée. Sans cela, toute l'opération s'arrêtait avant même la création de l'hybride.
Ensuite, la bibliothèque a tenté d'initialiser les zones vides de DeepSeek avec du bruit aléatoire en appelant `normal_`. PyTorch a alors levé une `NotImplementedError` : les poids du donneur avaient été chargés via bitsandbytes en 4 bits et stockés en `uint8`, alors que le générateur de loi normale travaille sur des tenseurs flottants. Le problème a été réglé de la façon la plus directe : ils ont intercepté `TORCH_INIT_FUNCTIONS["normal_"]` et interdit à la fonction de toucher aux tenseurs d'octets. Ce n'est pas un correctif élégant, mais un contournement chirurgical, sans lequel la greffe ne démarrait même pas.
La partie la plus pénible a été les experts de DeepSeek et la mémoire. Les blocs MoE n'étaient pas dans un `ModuleList` ordinaire, mais à l'intérieur d'une classe personnalisée qu'on ne peut pas simplement parcourir avec une boucle. De plus, déballer une couche de 31B de Gemma dans la RAM de Kaggle provoquait un OOM presque instantané. Pour y remédier, les auteurs ont écrit un « sonar » récursif qui cherche les sous-couches voulues d'après les attributs `gate_proj`, `up_proj` et `down_proj`, et ont transféré les poids par micro-lots via le CPU, en répartissant les modèles sur deux GPU et en appelant sans cesse le ramasse-miettes.
«
En apprentissage automatique, il n'y a pas de murs d'architecture infranchissables. »
Comment le modèle a été cousu
Le script final a ramené toute l'opération à une suite de patchs brutaux et de copies de poids. Pour chacune des quatre couches, il ajustait les matrices à la taille de la couche cible, en les complétant de zéros si nécessaire, greffait séparément les projections d'attention, puis séparément les composants MLP de chaque expert trouvé. Après chaque grosse copie, la mémoire était aussitôt nettoyée. Une fois la greffe faite, les auteurs ont dû en plus réécrire le routeur MoE pour que le modèle ne plante pas sur un conflit de dimensions pendant l'inférence et puisse produire au moins un peu de texte.
Les principales étapes techniques étaient les suivantes :
- Enregistrement de la configuration personnalisée de Gemma dans le registre global de Transformers
- Monkey patch pour `GenerationConfig` qui survit à l'erreur `dict.to_dict()`
- Blocage de `normal_` pour les poids `uint8` en 4 bits
- Recherche récursive des experts et transfert des matrices par micro-lots via le CPU
Le test de la chimère a donné le résultat attendu : le modèle a bien démarré, mais il a généré un texte incohérent, un mélange de tokens aléatoires et de bribes de phrases. Pour les auteurs, cela restait un succès, car l'objectif n'était pas la qualité des réponses mais la démonstration du principe. Ils n'ont pas harmonisé les vocabulaires, entraîné de projections de transition ni fait de fine-tuning après la greffe ; un flux chaotique de tokens en sortie était donc presque inévitable. L'expérience a pourtant prouvé que les limites architecturales ne sont souvent pas un mur, mais une longue liste de problèmes de bas niveau que le code permet de contourner.
Ce que cela signifie
Ces expériences ne produisent pas un produit fini, mais elles montrent bien les limites des LLM open source actuels. Si les poids, la quantification, le routage et les hidden states peuvent être au moins en partie raccordés sans réentraînement, la voie s'ouvre à des hybrides plus pratiques, avec de vraies projections, une adaptation du vocabulaire et un réglage ultérieur. Pour les développeurs, c'est un signal : la pile autour des modèles reste fragile, et l'espace pour les assemblages hors normes ne fait donc que s'élargir.
- 2 nov. 2026DeepSeek ouvre le code d'un prototype de Super-agent : p95 du temps d'exécution de 15,7 min contre 29,5
- 1 nov. 2026Test de 16 modèles sur 7 moteurs de recherche : Exa obtient en moyenne 10,5 points sur 14, SearXNG environ 3
- 1 nov. 2026La couche de protection MoneyGate n'a laissé passer aucune des 42 demandes frauduleuses adressées à des IA locales
- 31 oct. 2026DeepSeek-V4.1-Flash ramène le cache KV en HBM à 890 octets par token, contre 3514
Questions clés sur cet article
Pourquoi un hybride?
L'idée est née de contraintes très dures : deux GPU T4 gratuits sur Kaggle, environ 30 Go de RAM et aucun budget pour un fine-tuning complet. Plutôt que d'entraîner, les auteurs ont choisi de tester un scénario plus brut : l'épissage structurel de modèles. Le donneur était Gemma-4-31B, compressé au format NF4 en 4 bits, et le « squelette » un DeepSeek-V4 vide doté d'un routeur Mixture-of-Experts. La tâche sonnait presque comme un mème : greffer une partie des poids d'une architecture dans une autre et voir si la chimère pouvait seulement être ranimée. Sur le plan de l'ingén
Que sait-on sur Là où tout s'est effondré ?
Le premier échec est survenu dès le chargement. Transformers a refusé de reconnaître correctement le type personnalisé `gemma4`, puis a planté avec l'erreur `dict.to_dict()`, car un module interne sérialisait la configuration en simple dictionnaire avant de tenter aussitôt de la traiter comme un objet. Pour aller plus loin, les auteurs ont enregistré le type à la main dans `CONFIG_MAPPING` et ajouté un monkey patch pour `GenerationConfig`, qui enveloppe le dictionnaire dans un objet proxy à la volée. Sans cela, toute l'opération s'arrêtait avant même la création de l'hybrid
Comment le modèle a été cousu?
Le script final a ramené toute l'opération à une suite de patchs brutaux et de copies de poids. Pour chacune des quatre couches, il ajustait les matrices à la taille de la couche cible, en les complétant de zéros si nécessaire, greffait séparément les projections d'attention, puis séparément les composants MLP de chaque expert trouvé. Après chaque grosse copie, la mémoire était aussitôt nettoyée. Une fois la greffe faite, les auteurs ont dû en plus réécrire le routeur MoE pour que le modèle ne plante pas sur un conflit de dimensions pendant l'inférence et puisse produire au
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.