Whisper et Faster-Whisper : transcrire de l'audio en local sans envoyer ses fichiers dans le cloud
La transcription audio en local revient sur le devant de la scène. Faster-Whisper permet de transcrire des enregistrements avec Python sans téléverser les fichiers dans le cloud. L'approche mise sur la confidentialité et la maîtrise des données. Elle peut tourner sur GPU pour gagner en vitesse, mais aussi sur un CPU classique. C'est une option pragmatique pour les interviews, les visioconférences, les podcasts et les enregistrements de travail internes.
Traité par IA depuis KDnuggets ; édité par Hamidun News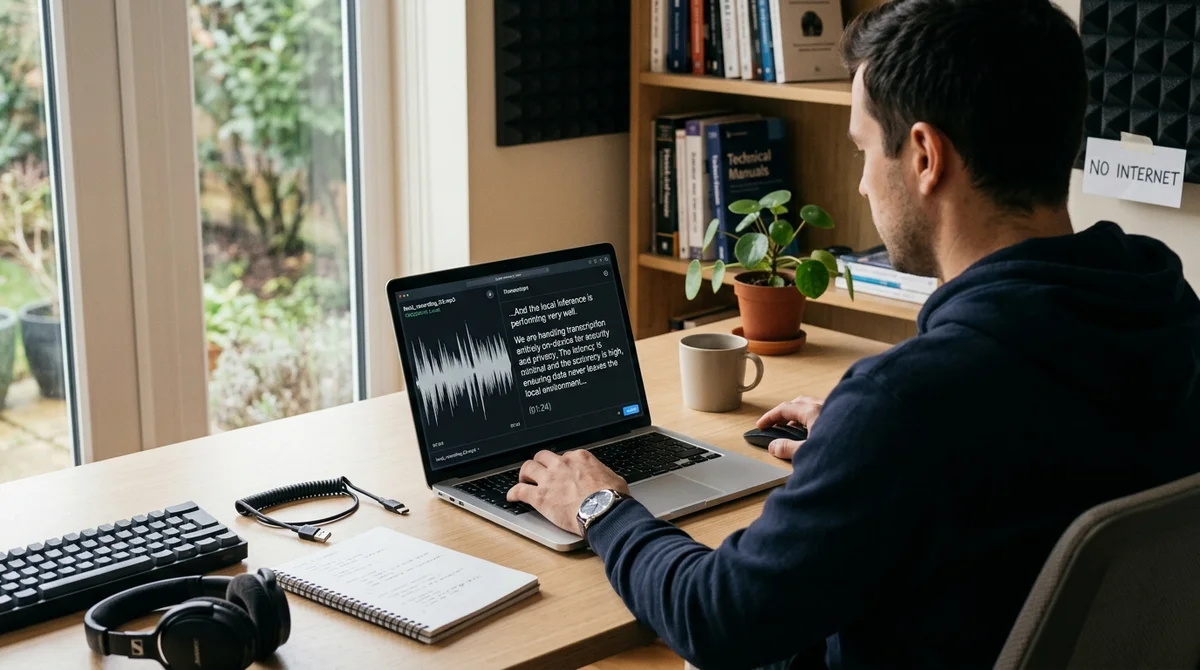
La transcription audio en local revient sur le devant de la scène. Un article consacré à Faster-Whisper montre comment lancer une transcription sur son propre ordinateur avec Python, sans téléverser les fichiers vers des services cloud. L'accent porte sur la confidentialité, la maîtrise des données et la possibilité de travailler aussi bien sur CPU que sur GPU.
Pourquoi en local L'argument principal en faveur de cette approche est la confidentialité.
Un enregistrement d'interview, de visioconférence ou d'appel client peut contenir des données sensibles. Le traitement local élimine alors une partie des risques : le fichier ne part pas sur un serveur externe, ne dépend pas de la politique de conservation d'un fournisseur tiers et reste à l'intérieur de votre périmètre. Pour les entreprises, c'est particulièrement important lorsqu'elles sont soumises à des exigences de sécurité, à des NDA ou à des restrictions internes sur le transfert d'audio vers des services externes.
Deuxième avantage : la prévisibilité. Vous choisissez vous-même le modèle, les paramètres de qualité et la vitesse de traitement, et vous ne dépendez ni des tarifs d'une API ni des files d'attente du cloud. Faster-Whisper se distingue ici en offrant un moyen plus léger et plus pratique d'exploiter les modèles de la famille Whisper en environnement local.
Il ne s'agit pas d'une expérience pour le plaisir d'expérimenter, mais d'un scénario parfaitement opérationnel pour la transcription quotidienne de fichiers. S'y ajoute un bonus purement opérationnel : les transcriptions locales s'intègrent plus facilement dans un traitement d'archives ou par lots. On peut enchaîner des dizaines de fichiers sans se soucier des limites d'un service externe, de la disponibilité d'Internet ou du coût variable de chaque minute d'audio.
Comment se déroule l'exécution
Le schéma est assez direct : un script Python charge le modèle Faster-Whisper, reçoit un fichier audio et renvoie le texte découpé en segments avec horodatage. Ce format se prête non seulement à la simple transcription, mais aussi à l'automatisation en aval — par exemple pour générer des sous-titres, extraire les points clés d'une réunion ou passer le texte dans un outil de résumé. L'approche reste universelle : le même pipeline peut tourner sur un ordinateur portable, une station de travail ou un serveur.
- Chargement du modèle en mémoire Lecture du fichier audio local Reconnaissance vocale par segments * Restitution du texte avec horodatages La question du matériel mérite qu'on s'y arrête. L'exécution sur GPU apporte un gain de vitesse sensible, surtout sur les enregistrements longs et les modèles plus volumineux. Mais l'essentiel est ailleurs : l'article ne repose pas uniquement sur une carte graphique coûteuse. Avec un CPU ordinaire, la transcription locale reste accessible ; le traitement prendra simplement plus de temps. Faster-Whisper devient ainsi une option pratique aussi bien pour un développeur indépendant que pour une petite équipe qui ne veut pas bâtir d'emblée une infrastructure complexe.
Où cela peut servir Les cas d'usage concrets ne manquent pas.
Les journalistes peuvent transcrire des interviews sans transmettre leurs sources à des tiers. Les équipes produit peuvent convertir rapidement des enregistrements de réunions en texte et y rechercher des décisions ou des bugs. Les podcasteurs peuvent préparer des brouillons de sous-titres et de descriptions d'épisodes.
En entreprise, cette stack a un autre atout : elle s'intègre facilement aux processus maison. On charge le fichier, on récupère le texte, puis on le transmet à un moteur de recherche, à un outil d'analyse ou à un assistant AI interne. Pour autant, l'exécution locale ne supprime pas les limites fondamentales de la reconnaissance vocale.
Le bruit, plusieurs locuteurs parlant en même temps, un fort accent ou un enregistrement de mauvaise qualité continuent de peser sur le résultat. En pratique, le flux de travail se construit donc ainsi : choisir d'abord la taille de modèle adaptée à la tâche, puis vérifier la vitesse sur son propre matériel, et seulement ensuite passer à l'échelle. C'est précisément ce pragmatisme qui redonne de l'actualité à la transcription locale, d'autant plus dans un contexte d'intérêt général pour les outils AI respectueux de la vie privée.
Ce que cela signifie L'intérêt pour l'AI locale glisse du cercle des
passionnés vers les usages professionnels du quotidien. Si Faster-Whisper atteint un niveau de qualité acceptable, les équipes disposent d'un moyen simple de transcrire de l'audio sans les compromis du cloud, sans dépenses superflues en API et sans perdre la maîtrise de leurs données.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.