ruGPT3XL passe à un contexte de 8k : le modèle restauré dépasse la limite de 2k presque sans perte
Après sa restauration, ruGPT3XL dispose non seulement d'un sparse attention fonctionnel, mais aussi d'une fenêtre de contexte de 8k au lieu des 2k tokens d'origine. L'auteur du projet a d'abord trouvé une erreur dans le mécanisme d'attention qui faisait chuter la qualité, puis a affiné le modèle en deux étapes : 2k→4k et 4k→8k. Résultat : une PPL de 13.00 à 8k, alors que celle du contexte de base de 2k n'a presque pas bougé.
Traité par IA depuis Habr AI ; édité par Hamidun News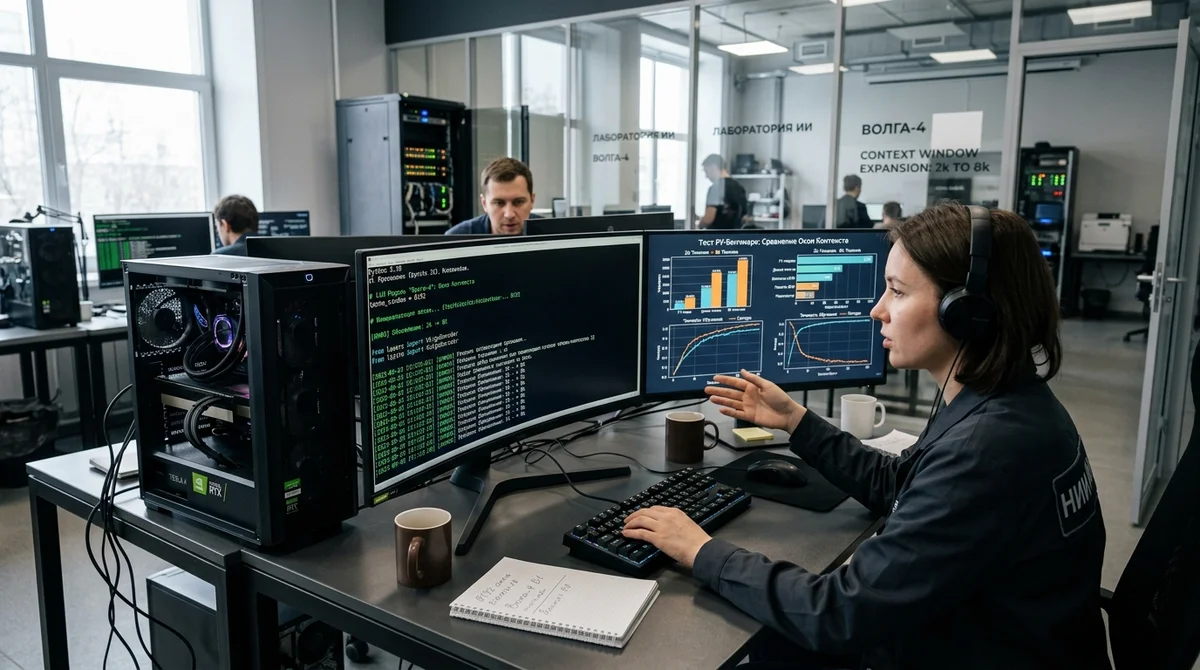
ruGPT3XL, restauré à partir d'un ancien checkpoint Megatron-LM, dispose désormais d'une vraie fenêtre de contexte de 8 000 tokens au lieu des 2 000 d'origine, et n'a presque rien perdu en qualité sur les textes courts. Au passage, l'auteur du projet a corrigé une erreur clé dans le mécanisme d'attention, qui donnait à la première version du modèle un niveau nettement inférieur à l'original, bien qu'elle démarre et génère du texte.
Le projet a commencé comme une restauration technique d'un ancien modèle en russe : les poids de ruGPT3XL ont été convertis au format Hugging Face, une version GGUF a été préparée pour llama.cpp et les tests ont démarré. C'est à ce stade qu'il est apparu que la conversion ne fonctionnait pas tout à fait correctement. À la place du sparse attention d'origine, le modèle utilisait en réalité le dense attention classique de GPT-2, ce qui faisait chuter la qualité sur les séquences longues. La métrique de perplexity l'a vite confirmé : la première vérification a donné une PPL de 50.1, alors que le ruGPT3XL d'origine affiche 12.05.
Après la restauration de l'alternating sparse attention, la situation a radicalement changé. La PPL est tombée à 11.68 : le modèle s'est de nouveau rapproché des valeurs d'origine et calcule l'attention comme le prévoyait l'architecture initiale. En parallèle, il a fallu mettre à jour aussi la prise en charge dans llama.cpp : l'ancien patch transférait les poids vers GGUF mais n'implémentait pas le sparse attention lui-même, si bien que la version locale calculait elle aussi selon le schéma dense.
L'auteur a en outre corrigé une erreur dans le masque pour les batchs de plus d'un exemple et ajouté une accélération via SDPA, torch.compile et Triton. Sur une RTX 4090, cela a donné un gain de vitesse d'entraînement d'environ 1.85 fois par rapport à l'implémentation eager de base.
L'objectif principal de l'étape suivante était pratique : supprimer l'ancienne limite de 2048 tokens, qui gênait le travail sur de longues conversations et de longs documents. Mais pour ruGPT3XL, il ne suffit pas de changer un nombre dans la configuration. Le modèle utilise des learned absolute positional embeddings, qui ne savent pas extrapoler correctement vers de nouvelles positions sans réentraînement, et le schéma de sparse attention dépend lui aussi de la longueur maximale du contexte.
L'extension a donc été menée par paliers : d'abord de 2k à 4k, puis de 4k à 8k. Pour les nouvelles positions, un tiling des embeddings positionnels a été appliqué afin de ne pas casser les séquences courtes déjà apprises, et le dataset a été composé d'exemples longs et courts dans une proportion de 60 pour 40. L'entraînement sur le dataset Gazeta a duré environ 2.6 heures pour la première étape et 3.9 heures pour la seconde.
Le résultat est soigné plutôt que spectaculaire. Sur la fenêtre d'origine de 2k, la version finale 8k a obtenu une PPL de 11.77 contre 11.68 pour le modèle de base, soit une régression de seulement 0.09. À 4k, la valeur finale est de 11.99 et, sur la fenêtre complète de 8k, de 13.00, ce qui paraît très honorable pour un contexte multiplié par quatre.
Côté mémoire, l'expérience s'est aussi révélée viable : grâce au sparse attention, la hausse de consommation n'a pas tourné à la catastrophe, et l'entraînement comme l'inférence tiennent sur une RTX 4090 avec 48 Go de VRAM. Pendant l'entraînement à 8k, un autre problème pratique est apparu, la fragmentation de la mémoire CUDA, mais il a été contourné grâce au réglage expandable_segments, ce qui a fait passer le pic de consommation de 46.8 à 38.5 Go.
La vitesse de génération baisse évidemment quand le prompt s'allonge, mais sur le contexte complet de 8k le modèle tient encore environ 38 tokens par seconde : il ne s'agit pas seulement d'un tour de force de recherche, mais d'un scénario local tout à fait exploitable.
Pour le segment open source russophone, c'est un signal important : même les anciens modèles peuvent ne pas être simplement archivés, mais remis à un niveau de fonctionnement moderne si l'on restaure soigneusement les détails architecturaux et que l'on ne fait pas d'économies sur la validation. Dans le cas de ruGPT3XL, il ne s'agit plus d'une mise à jour cosmétique, mais d'un gain réel d'utilité : le modèle est plus proche de l'original en qualité, a gagné la prise en charge dans des outils populaires et sait désormais travailler avec un contexte long sans perte sérieuse sur les tâches courtes.
- 2 nov. 2026TensorFold 1.2.0 augmente de 44,2% le débit de Qwen3.8-27B sur M3 Ultra à 16 flux
- 1 nov. 2026Les modèles locaux battus par Opus et Codex : 0,21 sur MacBook contre 1,00 pour Codex
- 1 nov. 2026Un auteur de Habr affine YOLOv8l sur des radiographies dentaires et atteint un mAP50 de 0,642
- 1 nov. 2026Les bots vocaux à base de LLM s'appuient sur le classifieur rapide Jev : une décision en 200–500 ms
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.