Comment monter le pipeline Netflix Void pour supprimer des objets dans une vidéo avec CogVideoX
Un nouveau guide montre comment monter un pipeline Void pour supprimer des objets dans une vidéo à partir de CogVideoX. Il couvre la configuration de l'environnement, le téléchargement du modèle de base et du checkpoint, la préparation des sample inputs et l'exécution de toute la chaîne d'inférence avec des prompts personnalisés. Pour les équipes de post-production vidéo, l'intérêt tient à ce qu'il ne s'agit pas d'une démo, mais d'un flux de travail reproductible en local.
Traité par IA depuis MarkTechPost ; édité par Hamidun News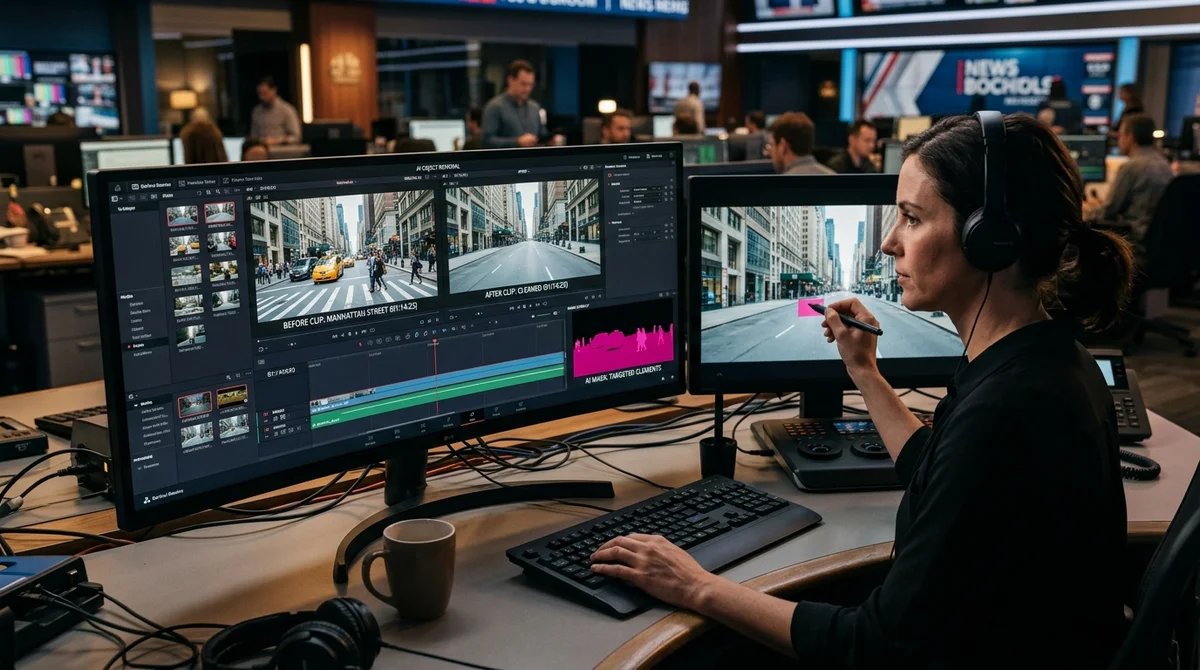
Un nouveau guide détaille comment monter un pipeline fonctionnel de suppression d'objets dans une vidéo avec le modèle Void de Netflix : de l'installation des dépendances et du téléchargement des poids jusqu'à l'exécution de la chaîne d'inférence complète, avec des prompts personnalisés et des exemples prêts à l'emploi. Pour les équipes de post-production, de montage génératif et d'édition vidéo, l'essentiel n'est pas la démonstration de qualité elle-même, mais un processus reproductible, qu'on peut déployer en local, tester sur des données d'essai et adapter à sa propre production.
Au centre du document se trouve le modèle Void, conçu pour les tâches de video object removal et d'inpainting : retirer d'une image les objets indésirables, puis reconstruire l'arrière-plan et le mouvement pour que le résultat paraisse naturel d'une image à l'autre. Dans ces scénarios, restaurer une seule image ne suffit pas : si l'arrière-plan tremble, que les textures flottent et que l'éclairage change par à-coups, le spectateur remarque aussitôt l'intervention. C'est pourquoi le guide associe CogVideoX à un checkpoint distinct. Le modèle vidéo de base gère la dynamique générale de la scène, tandis que l'ajustement spécialisé aide à traiter plus précisément la retouche locale sans abîmer le reste de la vidéo.
Sur le plan pratique, c'est un véritable mode d'emploi d'ingénierie. On commence par préparer l'environnement, installer toutes les dépendances nécessaires et cloner le dépôt. Il faut ensuite télécharger le modèle de base officiel et le checkpoint Void, puis préparer des sample inputs pour un essai : la vidéo source, un masque ou d'autres artefacts d'entrée indiquant quel objet doit être supprimé.
Cet ordre compte sur le fond, pas seulement sur la forme. En inférence vidéo, la plupart des pannes ne viennent pas de l'architecture du modèle, mais de la jonction entre versions de bibliothèques, structure des répertoires, formats de fichiers, limites de mémoire vidéo et chemins de poids mal renseignés.
Le guide insiste tout particulièrement sur les prompts personnalisés et sur une inférence d'exemple complète de bout en bout. C'est crucial, car la qualité de la vidéo finale ne dépend pas que du masque, mais aussi de la façon dont le modèle interprète la scène après l'édition : quel arrière-plan doit apparaître à la place de l'objet supprimé, comment le mouvement de caméra se poursuit, quels éléments doivent rester inchangés et avec quel soin les petits détails sont restaurés.
Le document met aussi en avant une manière plus pratique d'interagir avec le pipeline, via une saisie sécurisée des paramètres de type terminal. Pour une équipe d'ingénierie, cela signifie des exécutions plus prévisibles, moins de routine manuelle et une automatisation plus commode des tâches répétitives de montage vidéo.
L'intérêt pour ces systèmes n'a rien de fortuit. La vidéo est devenue un format clé pour le marketing, la formation, les médias et les démonstrations de produits, et la demande a grimpé pour des outils capables de retirer vite de l'image les objets superflus, reflets, logos, passants fortuits ou artefacts techniques, sans retouche manuelle image par image. Plus important encore, les modèles génératifs passent peu à peu du stade de démos impressionnantes à celui d'outils de production.
Dans ce contexte, la qualité de la sortie ne suffit pas : la répétabilité du résultat, une installation claire, une configuration transparente et la possibilité d'intégrer la solution à un pipeline de traitement de contenu existant comptent tout autant. Ce type de guide accélère l'adoption plus que les annonces tonitruantes.
La conclusion principale : ce guide présente non pas une idée de recherche abstraite, mais un schéma de montage vidéo par IA presque prêt pour la production. Quand les étapes d'installation, les dépendances, les poids, la logique de lancement et les exemples de test sont décrits ensemble, la technologie se rapproche nettement d'un usage réel. Si l'écosystème autour de Void et de CogVideoX continue de se développer, le seuil d'entrée pour une suppression d'objets vidéo de qualité baissera pour les studios, les équipes produit et les services de montage automatisé. Pour le marché, le signal est clair : le video inpainting passe de plus en plus vite du statut de fonction expérimentale à celui d'outil de travail.
- 2 nov. 2026Cosmos a généré de la vidéo d'entraînement pour drones : le mAP@50–95 du détecteur progresse de 10,3%
- 2 nov. 2026Karpathy bâtit en deux heures un clone de YouTube avec 6454 vidéos issues des conseils de Hacker News
- 2 nov. 2026Avec Claude, Andrej Karpathy a assemblé HackerTube : 6454 vidéos recommandées sur Hacker News
- 2 nov. 2026Un journaliste de The Verge assemble un équivalent du Meta Muse Charm à $50 avec Claude Code
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.