MarkTechPost décortique le cycle complet d'entraînement des grands modèles de langage, des données au déploiement
Un LLM moderne n'est pas un grand entraînement unique, mais un long pipeline : préentraînement, SFT, LoRA/QLoRA, RLHF, optimisation du raisonnement et déploiement. L'analyse de MarkTechPost montre que les capacités de base du modèle naissent au contact des données brutes, tandis que son utilité réelle vient ensuite, quand on l'ajuste à une tâche, qu'on l'aligne sur les attentes humaines et qu'on le prépare à tourner sous charge. La conclusion principale : la qualité d'un LLM tient à une chaîne de décisions sur tout le parcours, et non à une unique étape secrète.
Traité par IA depuis MarkTechPost ; édité par Hamidun News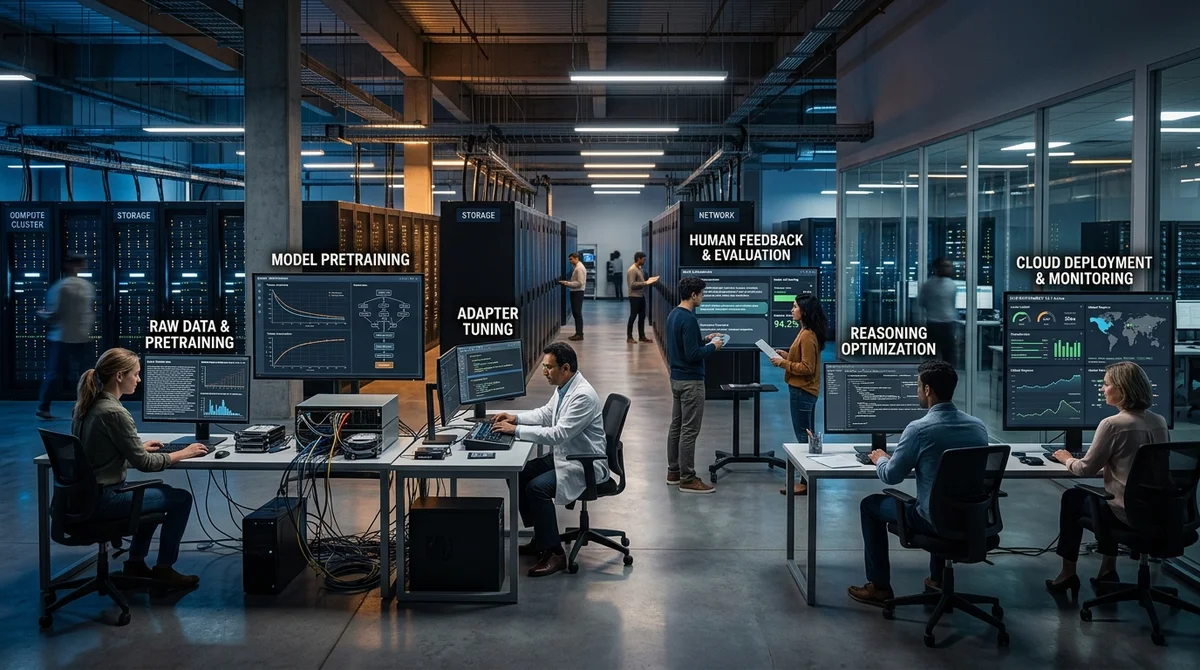
Un grand modèle de langage ne naît pas d'un seul passage sur les données : c'est une longue chaîne d'ingénierie où une erreur à n'importe quelle étape pèse sur la qualité, la sécurité et le coût d'exploitation. L'analyse technique de MarkTechPost décrit le parcours complet d'un LLM moderne, du préentraînement au déploiement en production, et montre pourquoi deux modèles de taille comparable peuvent se comporter de façon très différente. La différence ne tient pas à la seule architecture, mais à la qualité de tout le pipeline : données, réglage du comportement, alignement et infrastructure.
La première étape est le préentraînement. Le modèle y reçoit d'énormes volumes de données brutes : livres, sites web, documentation, code et autres corpus de texte. On ne lui apprend pas une tâche métier précise ; il assimile plutôt les régularités générales du langage, les liens entre concepts, la structure de l'argumentation et des schémas de raisonnement de base. Les objectifs typiques sont la prédiction du token suivant ou la reconstitution de passages manquants. En somme, le préentraînement transforme un réseau de neurones initialisé au hasard en un système capable de prolonger un texte de façon sensée et de tenir le contexte. Si cette base est faible, aucune amélioration ultérieure ne donnera un résultat vraiment solide.
Vient ensuite le réglage fin supervisé, ou SFT. On ne nourrit plus le modèle d'une simple masse de texte : on l'entraîne sur des paires « entrée-sortie » annotées. Cela permet de l'adapter à des instructions précises, au style de réponse, au ton de la communication et aux règles d'un secteur.
Un exemple simple montre bien l'écart : un modèle de base peut répondre sèchement et brièvement à la plainte d'un utilisateur, alors qu'après le SFT il livre une réponse structurée, polie et utile, avec des étapes claires. C'est à ce stade qu'on intègre au modèle l'expertise métier, les exigences de l'entreprise et le format de communication souhaité. Autrement dit, le préentraînement répond à la question de ce que le modèle sait faire en général, et le SFT à celle de la façon dont il doit se comporter dans un scénario d'usage donné.
Mais le réentraînement complet des grands modèles coûte trop cher ; dans la pratique, on recourt donc à des méthodes d'adaptation économes. MarkTechPost met en avant LoRA et QLoRA. Avec LoRA, les poids de base du modèle sont gelés et l'entraînement passe uniquement par de petites matrices de faible rang insérées dans certaines couches.
Cela réduit fortement le nombre de paramètres entraînables, la charge mémoire et le temps d'entraînement. QLoRA va plus loin : elle combine la même approche avec la quantification du modèle de base, par exemple à 4 bits, ce qui permet d'adapter même de très gros modèles sans exigences excessives d'infrastructure. L'intérêt pratique est simple : une entreprise n'a plus besoin de repartir sur un réentraînement complet pour chaque nouvelle tâche.
Elle peut prendre une base solide et la régler à un coût relativement bas pour des juristes, le support, des analystes ou un assistant interne.
L'alignement entre ensuite en jeu. Même si le modèle sait beaucoup de choses et suit plutôt bien les instructions, il peut encore répondre de façon trop brusque, dangereuse ou simplement différente de ce qu'attend l'utilisateur. On applique pour cela le RLHF, l'apprentissage par renforcement à partir de retours humains. Des personnes comparent plusieurs réponses du modèle et les classent ; un modèle de récompense est entraîné sur cette base, puis le LLM lui-même est optimisé pour produire plus souvent les variantes préférées.
Le texte mentionne aussi GRPO, une approche plus récente visant à améliorer le raisonnement et les solutions en plusieurs étapes. Le modèle génère plusieurs réponses à une même requête, puis l'entraînement ne repose pas sur une note absolue pour chaque réponse, mais sur la comparaison au sein du groupe. Ce mécanisme est particulièrement utile quand compte non seulement la réponse finale, mais aussi la qualité du raisonnement : mathématiques, problèmes de logique, explications séquentielles.
L'étape finale est le déploiement, et c'est là qu'un modèle de recherche devient un produit. En production, ce ne sont plus la loss ni la qualité du jeu de données en soi qui comptent, mais la latence, le coût d'inférence, le débit, l'utilisation des GPU et la stabilité sous charge réelle. Les modèles sont donc optimisés davantage : quantifiés, exécutés via des moteurs d'inférence spécialisés comme vLLM, TensorRT-LLM ou SGLang, enveloppés dans une API et hébergés dans le cloud ou dans un environnement auto-hébergé lorsque le contrôle des données et l'économie l'exigent.
S'y ajoute l'observabilité : suivi de la latence, du débit et de la consommation mémoire, ainsi que mise à l'échelle automatique. Sans cela, même un modèle performant devient vite un service coûteux et instable.
La conclusion principale de l'analyse de MarkTechPost est que la qualité d'un LLM ne dépend pas d'une étape « secrète », mais de l'enchaînement des décisions sur tout le parcours. Le préentraînement apporte l'intelligence brute, le SFT rend le modèle utile pour une tâche précise, LoRA et QLoRA rendent l'adaptation moins chère, RLHF et GRPO affinent le comportement et la logique, et le déploiement décide si l'ensemble du système peut fonctionner en conditions réelles, vite et de façon prévisible. Pour le marché, c'est un signal important : la concurrence entre produits d'IA se déplace de plus en plus de la taille du modèle en soi vers la qualité de l'environnement d'ingénierie qui l'entoure.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.