Meta dévoile Sapiens2, un modèle de vision unique pour la pose, la segmentation et la 3D
Meta a lancé Sapiens2, une nouvelle famille de modèles de vision haute résolution pour les tâches centrées sur l'humain. Une seule architecture couvre l'estimation de pose, la segmentation des parties du corps, les surface normals, le pointmap et l'albédo. La gamme va de 0,4 à 5 milliards de paramètres, a été entraînée sur 1 milliard d'images de personnes et, selon l'entreprise, surpasse nettement en précision la première génération de Sapiens. *Meta a été déclarée organisation extrémiste et est interdite en Russie.
Traité par IA depuis MarkTechPost ; édité par Hamidun News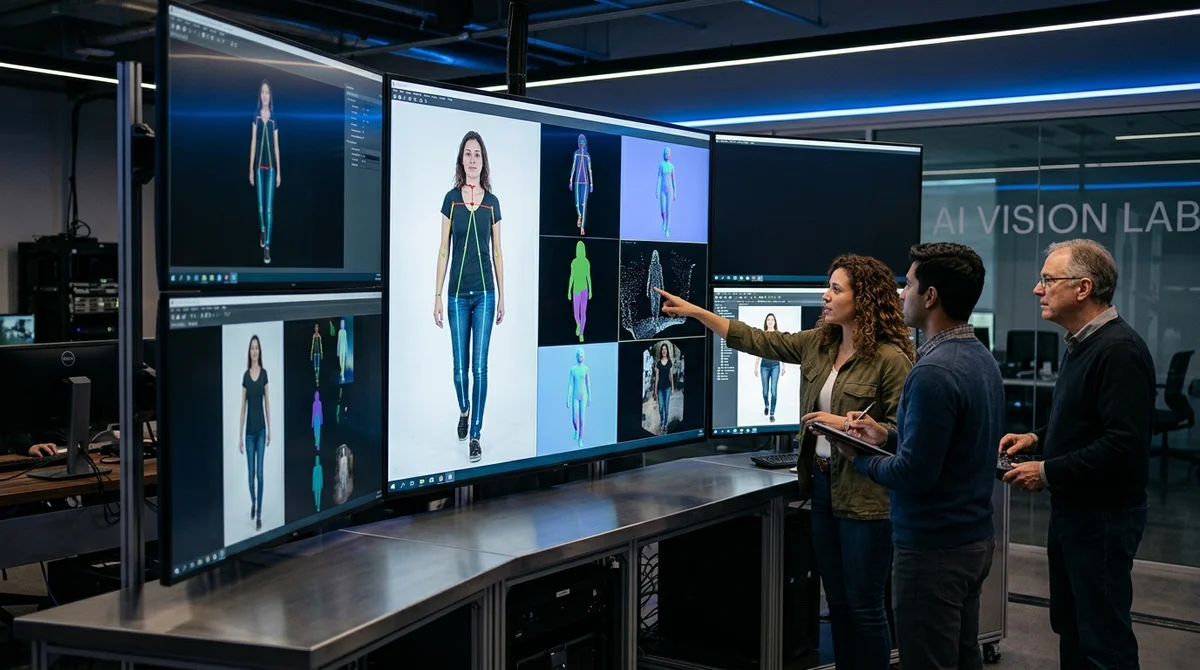
Meta Reality Labs a lancé Sapiens2, une nouvelle génération de modèles de vision centrés sur l'humain, qui cherche à remplacer un ensemble disparate de réseaux spécialisés par une base commune unique. Dans une seule gamme, l'entreprise réunit des tâches généralement traitées séparément : estimation de la pose humaine, segmentation des parties du corps, restitution des normales de surface, pointmap pour la géométrie 3D et estimation de l'albédo. Pour le marché, c'est un signal important : Meta continue de miser non seulement sur l'IA générative, mais aussi sur la vision par ordinateur appliquée, nécessaire aux appareils de RA, aux avatars numériques, à l'essayage virtuel, à la motion capture et à l'analyse vidéo.
L'idée centrale de Sapiens2 est qu'une seule architecture de base peut travailler simultanément à plusieurs niveaux de compréhension d'une personne dans l'image. Le système n'a plus besoin d'un réseau pour le squelette, d'un autre pour l'étiquetage du corps et d'un troisième pour la géométrie de surface. Meta affirme qu'un seul backbone couvre tous ces scénarios après fine-tuning.
Concrètement, cela simplifie le pipeline de production : moins de composants, moins de désynchronisation entre modèles et des coûts de maintenance réduits. Parmi les checkpoints publiés figure notamment un modèle d'estimation de pose top-down sur 308 points clés, dont des points détaillés du visage, des mains et des pieds, ainsi qu'une segmentation en 29 classes de parties du corps. La mise à jour majeure ne tient pas seulement à l'éventail de tâches, mais aussi à la manière dont le modèle a été entraîné.
Sapiens2 a été pré-entraîné sur un jeu de données trié de 1 milliard d'images de personnes de haute qualité. Lors du pré-entraînement, Meta a combiné la reconstruction d'images masquées avec un objectif contrastif auto-distillé, afin que le modèle conserve à la fois les détails de bas niveau pour la prédiction dense et la sémantique de haut niveau pour les scénarios zero-shot et à peu d'étiquettes. L'architecture reprend aussi des techniques de modèles frontier plus récents pour tenir des cycles d'entraînement plus longs sans perte de stabilité.
La gamme va de 0,4 à 5 milliards de paramètres, fonctionne en résolution native 1K, et les variantes hiérarchiques prennent en charge la 4K et utilisent du windowed attention pour un contexte spatial plus étendu. Par rapport à la première génération de Sapiens, Meta revendique un gain notable sur presque toutes les métriques clés. En estimation de pose, la nouvelle version gagne 4 points de mAP ; en segmentation des parties du corps, 24,3 points de mIoU ; et en surface normals, elle réduit l'erreur angulaire de 45,6 %.
Il faut aussi noter que Sapiens2 dépasse les tâches habituelles de la première version. La famille sait désormais construire un pointmap, c'est-à-dire prédire pour chaque pixel les coordonnées 3D dans le repère de la caméra, et travailler avec l'albédo, la couleur de base d'une surface sans l'influence de l'éclairage. Pour les avatars, la RA et l'essayage numérique, c'est particulièrement utile : ces représentations aident à restituer plus précisément la forme d'une personne, à transférer l'éclairage et à construire des scènes 3D plus crédibles à partir d'une simple photo.
L'intérêt pratique de cette sortie tient à ce que Meta ne s'est pas contentée d'une publication de recherche. L'entreprise a déjà mis la famille Sapiens2 en ligne sur Hugging Face et le code sur GitHub, et la collection propose des variantes distinctes pour la pose, la segmentation, les normals et le pointmap. Cela abaisse la barrière d'entrée pour les équipes qui construisent des produits de vision par ordinateur centrés sur l'humain, des applications de fitness et systèmes de vidéo-analyse aux interfaces XR et personnages virtuels.
Il faut toutefois garder en tête que Sapiens2 n'est pas un modèle universel pour toute la vision par ordinateur, mais une pile performante spécifiquement pour l'imagerie centrée sur l'humain. Sa force principale réside donc dans les plans où la personne reste le sujet central, avec sa pose, sa surface, ses vêtements et la géométrie de son corps. Ce que cela change en pratique : Meta fait un pas de plus vers un backbone visuel unifié pour tout ce qui touche à une personne dans l'image.
Si les résultats annoncés se confirment en conditions réelles de production, l'entreprise disposera d'une base solide pour ses propres produits XR et placera la barre plus haut pour la recherche ouverte en vision centrée sur l'humain. Pour le marché, c'est un bon exemple de foundation models qui commencent à rapporter non seulement en texte et en génération, mais aussi sur des tâches de vision par ordinateur précises, relevant de l'ingénierie.
*Meta a été déclarée organisation extrémiste et est interdite en Russie.
- 2 nov. 2026L'assistant Muse de Meta tient un dossier sur vos proches et obtient root par défaut sous Ubuntu
- 2 nov. 2026Un journaliste de The Verge assemble un équivalent du Meta Muse Charm à $50 avec Claude Code
- 1 nov. 2026La couche de protection MoneyGate n'a laissé passer aucune des 42 demandes frauduleuses adressées à des IA locales
- 31 oct. 2026La passerelle LLM open source KTMS 1.0 branche ses propres GPU au cloud et résiste aux pannes
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.