Embeddings OpenAI et RL : comment construire un agent doté d'une mémoire à long terme pour des réponses précises
Un tutoriel détaille la construction d'un agent RL doté d'une mémoire à long terme, qui apprend à extraire d'une base de connaissances précisément les entrées qui aident le LLM à répondre plus juste. Le pipeline part d'un jeu de données synthétique et de requêtes de rappel de faits. Il s'appuie ensuite sur les embeddings OpenAI pour convertir la mémoire et les questions en vecteurs, puis entraîne de manière ciblée une politique de sélection des souvenirs pertinents.
Traité par IA depuis MarkTechPost ; édité par Hamidun News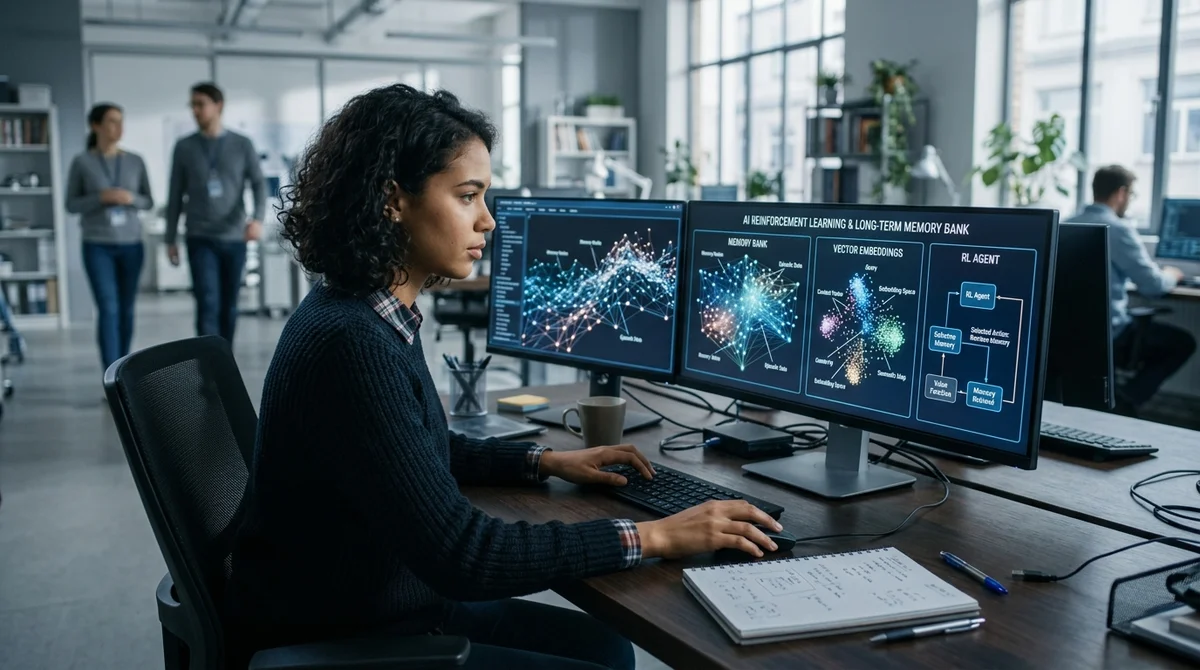
La mémoire à long terme pour l'IA devient un enjeu pratique. Un nouveau tutoriel montre comment construire un agent fondé sur l'apprentissage par renforcement qui ne se contente pas de chercher des entrées similaires : il apprend à extraire de sa mémoire précisément les faits dont le LLM a besoin pour répondre juste. L'approche compte pour les systèmes dont les connaissances dépassent la capacité d'une seule fenêtre de contexte, et où une erreur dans le choix du bon souvenir dégrade immédiatement la qualité de la réponse.
Les auteurs partent d'un jeu de mémoire synthétique : ils créent une collection d'entrées, puis formulent des requêtes qui exigent de se rappeler des détails précis. Ce cadrage est pratique, car il permet de contrôler quelle entrée est réellement pertinente et d'évaluer non seulement la réponse finale du modèle, mais aussi l'étape d'extraction elle-même. Plutôt que d'écrire des règles à la main, on utilise un agent entraînable qui reçoit progressivement un signal sur les actions qui le mènent au bon fait. Cela réduit aussi le risque de surajustement à un scénario de recherche unique et facilite la vérification automatique des expériences.
La mémoire et les requêtes sont ensuite projetées dans un espace vectoriel à l'aide des embeddings OpenAI. Le système dispose ainsi d'un signal de similarité de base : quelles entrées semblent sémantiquement proches de la question. Mais la seule proximité vectorielle fait souvent trébucher ce type de système. Une entrée similaire peut être trop générale, ne recouper le sujet que partiellement ou contenir un fait voisin, mais pas le bon. C'est là que le RL vient se greffer sur la recherche classique : l'agent doit apprendre à choisir non pas l'élément le plus similaire, mais le plus utile pour la réponse.
Concrètement, la recherche en mémoire passe d'une recherche statique des plus proches voisins à une séquence de décisions. L'agent peut classer les candidats, affiner sa sélection, combiner plusieurs signaux et recevoir une récompense lorsqu'il extrait des fragments qui permettent au LLM de répondre plus précisément. Pour les développeurs, le changement est notable : la mémoire cesse d'être un stockage passif pour devenir un élément d'une boucle optimisable.
Cette conception sert particulièrement les assistants personnels, les bases de connaissances d'entreprise, les systèmes agentiques avec historique de dialogue et tout produit où le modèle doit se souvenir de faits anciens sans recharger en permanence l'archive complète dans le prompt. C'est précisément cette architecture qui permet de séparer le contexte court terme de la requête en cours de la mémoire accumulée, qui grandit avec le produit.
Le caractère synthétique du jeu de données et la manière d'évaluer le résultat méritent une attention particulière. Dans un premier temps, un tel jeu permet d'itérer rapidement sur l'entraînement et de vérifier que la mécanique du signal de récompense fonctionne. Mais il faudra ensuite transposer le dispositif à des données réelles, bien plus bruitées : notes d'utilisateurs, événements CRM, fragments de documents, correspondances et comptes rendus de réunions.
En conditions réelles, la pertinence n'est presque jamais binaire, et les faits importants peuvent être éparpillés sur plusieurs entrées. Pour ces systèmes, il ne suffit donc pas de vérifier que le modèle a trouvé quelque chose de similaire : il faut mesurer si l'extraction a aidé à produire la bonne réponse, si le nombre d'hallucinations a baissé et à quel point le comportement de l'agent reste stable selon les types de requêtes. En ce sens, l'intérêt du RL est d'optimiser précisément l'utilité de la mémoire extraite pour la tâche finale, et non une métrique abstraite de similarité.
La principale leçon de ce tutoriel : la prochaine vague d'améliorations des agents LLM ne dépendra pas seulement de la taille des modèles, mais aussi de la qualité de la gestion de la mémoire. Si un agent sait apprendre à partir d'un signal d'utilité et choisir le bon souvenir au bon moment, il est possible, même sans élargir la fenêtre de contexte, d'améliorer nettement la précision des réponses, de réduire le bruit et de rendre le comportement du système plus robuste sur la durée. Pour les équipes qui construisent des produits d'IA reposant sur le RAG et des scénarios agentiques, c'est un bon cap : il faut optimiser non seulement la génération, mais aussi la politique d'extraction des connaissances.
- 1 nov. 2026Les modèles locaux battus par Opus et Codex : 0,21 sur MacBook contre 1,00 pour Codex
- 1 nov. 2026Kimi obtient 96,2 % à un test d'analytique sur une base 1C et s'impose comme solution de repli en cas de blocage de Claude
- 1 nov. 2026OpenAI réécrit les règles de comportement de GPT : cinq valeurs et une chaîne de priorités
- 1 nov. 2026Google reconnaît que l'AI Mode réduit les revenus de la recherche, l'action chute de 15%
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.