Google bâtit une chaîne d'approvisionnement en puces avec quatre partenaires pour défier Nvidia dans l'inférence IA
Google construit une chaîne d'approvisionnement de puces IA avec quatre partenaires pour défier Nvidia dans l'inférence. Ces partenaires sont Broadcom, MediaTek, Marvell et Intel. La feuille de route couvre l'Ironwood TPU, déjà livré par millions, et les puces TPU v8 gravées en 2 nm chez TSMC, attendues d'ici fin 2027.
Traité par IA depuis TNW ; édité par Hamidun News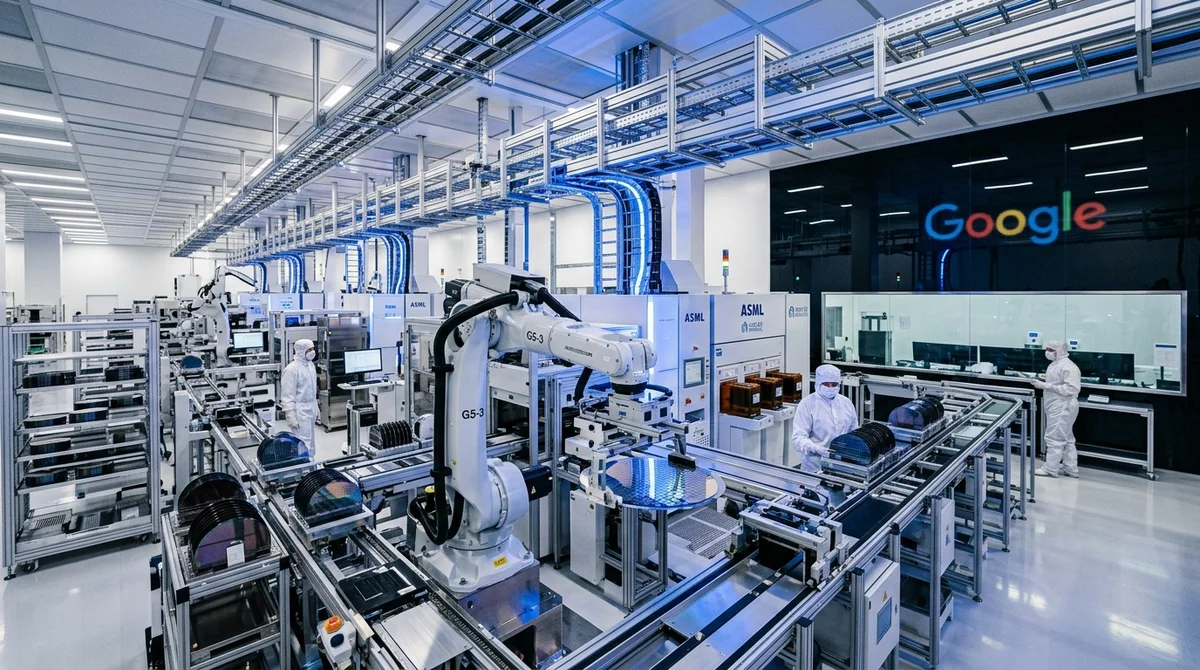
Google a annoncé la chaîne d'approvisionnement de puces sur mesure la plus diversifiée de l'industrie de l'IA, avec quatre partenaires de conception et une feuille de route courant jusqu'à fin 2027. L'entreprise parie sur une réduction de la dépendance du marché du cloud à Nvidia dans le segment de l'inférence IA.
Le réseau de partenaires de Google compte quatre acteurs majeurs : Broadcom, MediaTek, Marvell et Intel. Chacun prend en charge un volet distinct de l'architecture et de la fabrication des puces. La stratégie a été détaillée à la veille de Google Cloud Next, le grand rendez-vous annuel du groupe pour les clients d'entreprise et les partenaires.
Le premier produit de cet écosystème est l'Ironwood TPU, une puce de nouvelle génération déjà livrée par millions d'unités. C'est le premier signe que Google cesse d'être un simple consommateur de matériel conçu par d'autres et devient méthodiquement un acteur autosuffisant sur le marché de l'infrastructure IA.
La feuille de route s'achève avec les puces TPU v8, qui seront fabriquées en 2 nm chez TSMC et arriveront au second semestre 2027. La stratégie de Google répartit les prochaines générations de TPU en plusieurs flux indépendants, selon le partenaire de conception et la capacité de production. Cette approche protège contre les ruptures d'approvisionnement propres à la dépendance envers un seul fournisseur et donne de la souplesse pour adapter la puissance aux différentes charges d'inférence.
L'inférence, c'est-à-dire l'exécution de modèles déjà entraînés pour générer des réponses aux utilisateurs, est devenue le principal champ de bataille du marché des puces IA en 2025–2026. C'est là que se concentre l'essentiel de la demande des grands fournisseurs de cloud : un modèle est entraîné une fois, alors que l'inférence tourne en continu.
Nvidia conserve sa domination grâce à son architecture GPU et à la maturité de l'écosystème CUDA, mais les TPU sur mesure de Google affichent traditionnellement une meilleure efficacité énergétique sur les modèles de type transformer.
Pour le marché, cela signifie une concurrence accrue dans le matériel IA pour le cloud. Si Google parvient à porter sa propre chaîne aux volumes requis, ses clients disposeront d'une véritable alternative aux clusters de GPU de Nvidia, avec un coût d'inférence par token potentiellement plus bas et une moindre dépendance à un fournisseur unique.
- 1 nov. 2026Test de 16 modèles sur 7 moteurs de recherche : Exa obtient en moyenne 10,5 points sur 14, SearXNG environ 3
- 1 nov. 2026L'agent vidéo StreamVibe de Google devance les autres modèles de 10,7 % sur le timing et la qualité des réponses
- 1 nov. 2026OpenAI réécrit les règles de comportement de GPT : cinq valeurs et une chaîne de priorités
- 1 nov. 2026Les bots vocaux à base de LLM s'appuient sur le classifieur rapide Jev : une décision en 200–500 ms
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.