Un serveur à soi pour l'IA : arrêtez de torturer votre portable et d'écouter les coachs
Faire tourner un LLM sur son ordinateur portable, c'est un amusement d'un soir qui se heurte vite au manque de mémoire vidéo et à une lenteur d'escargot. Si vous cherchez un outil de travail et non un jouet, il est temps de passer aux solutions serveur. Les conseils pour lancer une Llama « bridée » ne manquent pas, mais ces modèles n'ont guère d'utilité pratique. La véritable inférence commence là où s'arrêtent les cartes graphiques grand public, et là où débute un réglage réfléchi du matériel et du logiciel. Nous détaillons un plan pas à pas, du choix du GPU à l'optimisation des poids. C'est un investissement dans la confidentialité et dans l'indépendance vis-à-vis des géants du cloud comme OpenAI ou Anthropic.
Traité par IA depuis Habr AI ; édité par Hamidun News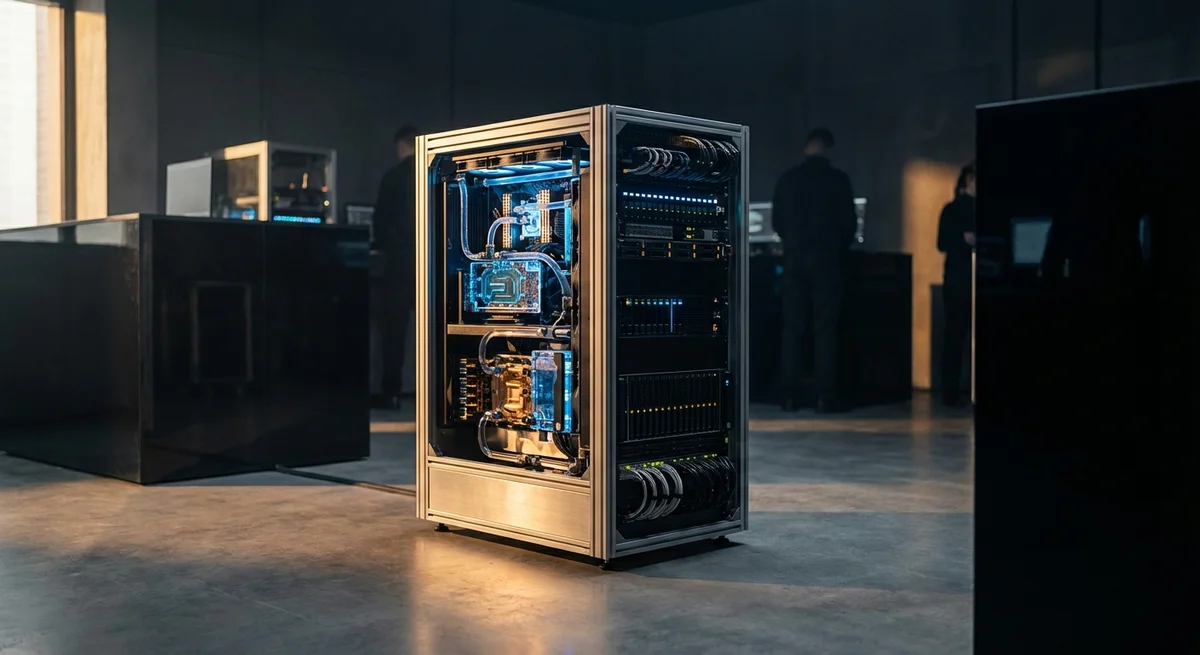
Vous souvenez-vous de la première fois où vous avez lancé Llama sur votre ordinateur portable ? D'abord l'émerveillement de voir la chose fonctionner, puis, cinq minutes plus tard, un agacement sourd : le modèle crache deux mots par seconde et les ventilateurs semblent prêts à décoller vers la stratosphère. Internet regorge aujourd'hui de guides signés par des experts autoproclamés qui promettent une intelligence artificielle complète sur du matériel vieux de cinq ans.
Soyons honnêtes : c'est de l'autosuggestion. Travailler sérieusement avec des modèles de langage locaux exige une approche sérieuse de l'infrastructure. Si vous voulez qu'une IA vous aide réellement à coder ou à analyser des documents, et pas seulement qu'elle vous divertisse avec des blagues bancales, il est temps de construire votre propre serveur.
Pourquoi s'embêter avec son propre matériel quand on a sous la main les API d'OpenAI ou d'Anthropic ? La réponse tient en deux mots : confidentialité et contrôle. Les entreprises changent les règles du jeu à la volée, imposent une censure stricte et peuvent bloquer votre compte sans explication : disposer de son propre cerveau numérique devient alors une question de sécurité.
Vous ne partagez pas vos secrets commerciaux avec des serveurs en Californie, et vous ne dépendez pas de la décision de Sam Altman de tripler ses prix demain. Par ailleurs, en usage intensif, les factures cloud finissent par ressembler à un numéro de téléphone, et l'achat de vos propres GPU se rentabilise plus vite qu'on ne le croit.
Le principal obstacle lors de la construction d'un tel serveur, c'est la mémoire vidéo. C'est elle, et non la fréquence du processeur, qui détermine quel modèle vous pourrez faire tourner et à quel point il sera intelligent. Une carte graphique de jeu moyenne suffit pour de petits modèles de 7 milliards de paramètres, mais pour quelque chose de vraiment puissant, comme Mixtral ou les grandes versions de Llama 3, il faut des dizaines, voire des centaines de gigaoctets de VRAM.
On entre ici dans la zone des compromis délicats. Soit vous dépensez une fortune en cartes professionnelles de type NVIDIA A100 ou H100, soit vous apprenez l'art de la quantification. La quantification permet de compresser les poids du modèle presque sans perte de qualité : c'est une étape de réglage cruciale, qui sépare l'amateur du professionnel.
Mais la mémoire ne représente que la moitié du problème. Le second, que les débutants oublient souvent, c'est la bande passante. Vous pouvez acheter beaucoup de mémoire bon marché, mais si le bus de données est étroit, votre modèle réfléchira avec une lenteur exaspérante. C'est pourquoi les solutions serveur reposant sur des architectures à haute bande passante valent leur prix. Nous passons de l'ère des simples utilisateurs d'IA à celle des opérateurs de systèmes locaux. Savoir déployer, optimiser et maintenir ses propres capacités de calcul vaut aujourd'hui bien plus que savoir écrire des prompts dans un chatbot.
Le volet logiciel n'est pas moins passionnant que le choix du matériel. Lancer un modèle en ligne de commande n'est que le début du chemin. Pour transformer le serveur en outil utile, il faut configurer un environnement d'inférence avec des outils modernes comme vLLM ou Ollama. Il faut apprendre à gérer les files de requêtes, à régler la fenêtre de contexte et à intégrer le modèle dans vos flux de travail habituels. Un tas de matériel coûteux devient alors une mécanique bien huilée, qui travaille pour vous 24 heures sur 24, sans week-ends ni jours fériés.
Au bout du compte, un serveur à soi, c'est la liberté d'expérimenter. Avec une machine puissante sous la main, vous commencez à tester des hypothèses sur lesquelles vous rechigniez auparavant à dépenser des tokens payants. Vous pouvez affiner des modèles sur vos propres données spécifiques, créer des agents autonomes et ne pas craindre que votre accès à la technologie soit restreint demain à cause d'un énième changement de politique de confidentialité. C'est le ticket d'entrée dans la cour des grands de l'indépendance technologique, où vous fixez vous-même les règles du jeu et contrôlez chaque octet d'information.
L'essentiel : un serveur local est le seul moyen d'obtenir une IA réellement privée et performante sans dépendre du bon vouloir des grandes entreprises. Êtes-vous prêt à investir dans votre indépendance numérique, ou continuerez-vous à louer des cerveaux aux géants de la Silicon Valley ?
- 1 nov. 2026OpenAI réécrit les règles de comportement de GPT : cinq valeurs et une chaîne de priorités
- 1 nov. 2026Google reconnaît que l'AI Mode réduit les revenus de la recherche, l'action chute de 15%
- 31 oct. 2026Un auteur soumet son scénario à un jury d'IA : le verdict coûte 850 000 tokens
- 31 oct. 2026Anthropic : replier les sous-agents dans une seule boucle a doublé la vitesse des tâches chez un client
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.