OpenAI s'allie à Cerebras pour accélérer ChatGPT
OpenAI s'est associée à Cerebras pour augmenter sa puissance de calcul de 750 MW. L'objectif : réduire la latence de ChatGPT et le rendre plus rapide sur les tâches qui exigent un traitement en temps réel. Le partenariat vise à améliorer les performances du service.
Traité par IA depuis OpenAI Blog ; édité par Hamidun News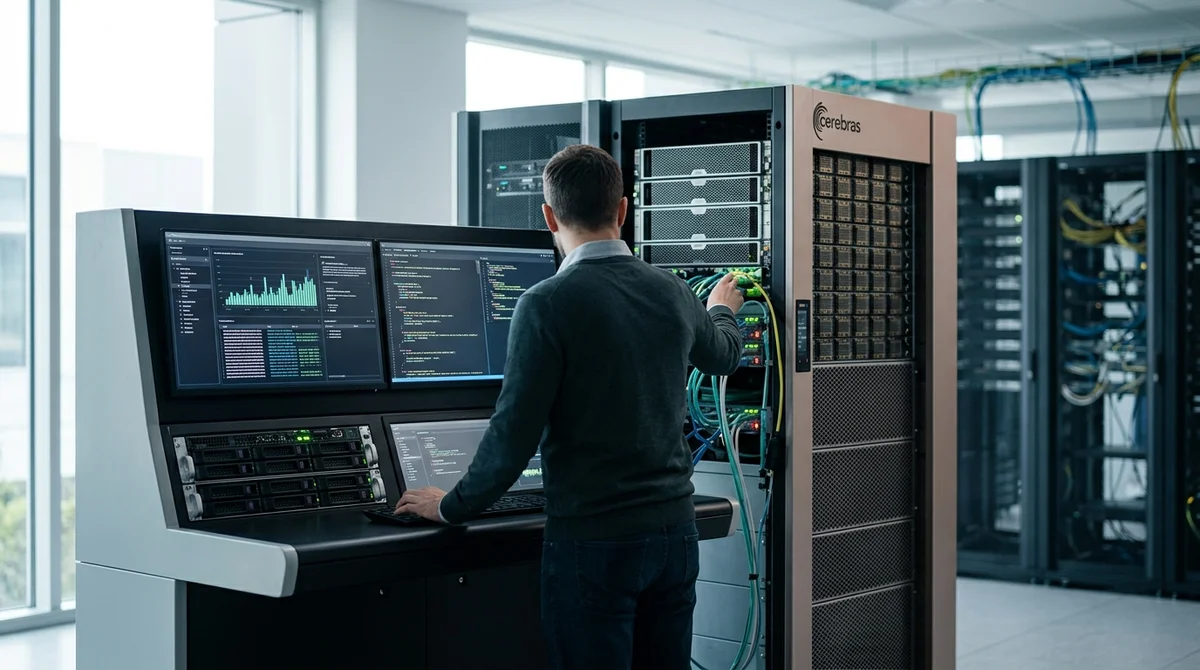
OpenAI, l'éditeur du populaire chatbot ChatGPT, a annoncé un partenariat stratégique avec Cerebras Systems, spécialiste du matériel dédié à l'intelligence artificielle. L'objectif est d'augmenter nettement la puissance de calcul dont dispose OpenAI. La société pourra ainsi réduire la latence dans le traitement des requêtes et améliorer les performances globales de ChatGPT, en particulier sur les tâches qui exigent une réponse en temps réel.
Cerebras fournira à OpenAI un accès à 750 MW de ressources de calcul à haut débit, un saut important par rapport à l'infrastructure existante. Ce partenariat répond à la demande croissante pour ChatGPT et au besoin de traiter plus vite et plus efficacement de grands volumes de données. Le succès de ChatGPT a accru la charge sur les serveurs d'OpenAI, ce qui a parfois entraîné des latences et une dégradation de la qualité de service.
Cerebras est connue pour ses innovations dans le matériel de machine learning, notamment pour avoir conçu la plus grande puce d'IA au monde, le Wafer Scale Engine (WSE). Le WSE a été pensé spécifiquement pour accélérer l'entraînement et l'inférence des réseaux de neurones. Sur certaines tâches, il offre des performances nettement supérieures à celles des processeurs graphiques (GPU) traditionnels. Grâce aux technologies de Cerebras, OpenAI pourra réduire sensiblement le temps de traitement des requêtes ChatGPT, pour des échanges plus fluides et plus réactifs avec le chatbot.
Ce partenariat a des implications importantes pour l'industrie de l'IA. D'abord, il illustre le besoin croissant de matériel spécialisé pour soutenir des charges gourmandes en ressources, comme l'entraînement et l'exploitation des grands modèles de langage (LLM). Ensuite, il souligne l'intérêt d'une collaboration entre les éditeurs de logiciels d'IA et les fabricants de matériel pour optimiser les performances et réduire les coûts. Enfin, il pourrait stimuler l'innovation dans le matériel pour l'IA, d'autres acteurs cherchant à développer des solutions alternatives capables de rivaliser avec les technologies de Cerebras.
Pour les utilisateurs de ChatGPT, cela signifie des réponses plus rapides et une latence réduite. C'est particulièrement important pour les applications qui exigent une interaction en temps réel : chatbots de service client, assistants virtuels ou outils d'analyse de données. Des performances accrues permettront aussi à OpenAI de développer des modèles d'IA plus complexes et plus riches en fonctionnalités, ce qui améliorera encore la qualité du service.
En somme, le partenariat entre OpenAI et Cerebras marque une étape importante vers des technologies d'IA plus rapides, plus efficaces et plus accessibles. Il montre que la collaboration entre acteurs du logiciel et du matériel est décisive pour faire progresser l'innovation dans ce domaine et améliorer l'expérience utilisateur.
- 1 nov. 2026Les modèles locaux battus par Opus et Codex : 0,21 sur MacBook contre 1,00 pour Codex
- 1 nov. 2026Kimi obtient 96,2 % à un test d'analytique sur une base 1C et s'impose comme solution de repli en cas de blocage de Claude
- 1 nov. 2026OpenAI réécrit les règles de comportement de GPT : cinq valeurs et une chaîne de priorités
- 1 nov. 2026Google reconnaît que l'AI Mode réduit les revenus de la recherche, l'action chute de 15%
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.