Un auteur a animé un tableau du XIXe siècle couche par couche : pour 1 clip réussi, 4 à 5 ratés
Si l'on confie à un modèle vidéo le tableau entier, il redessine les visages, les uniformes et le pont. L'auteur a donc découpé le tableau d'Alma-Tadema consacré au franchissement de la Bérézina en calques dans Photoshop, animé les figures une à une avec MiniMax H3, puis assemblé la scène dans After Effects. Le prix du contrôle se paie en temps : un seul clip réussi exigeait 4 à 5 générations ratées. Pour les scènes complexes, il est plus rentable de morceler la tâche et de vérifier chaque partie.
Traité par IA depuis Habr AI ; édité par Hamidun News
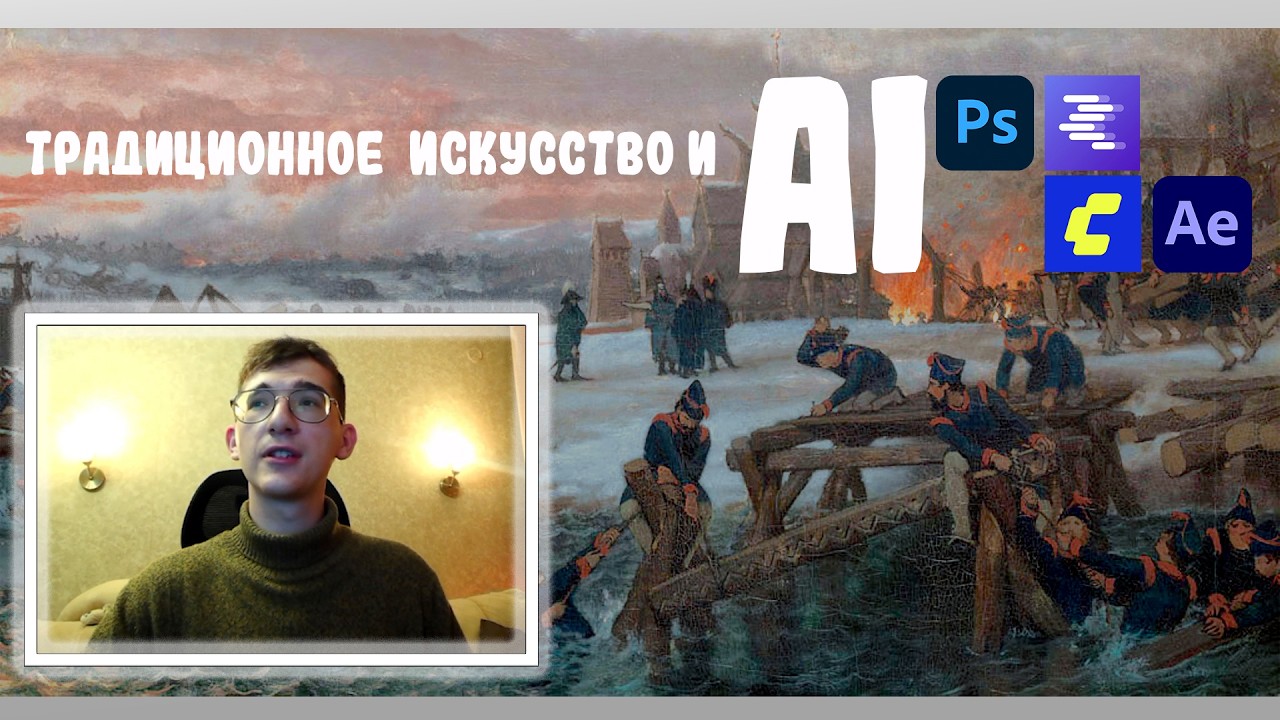
Les générateurs vidéo savent désormais animer une image de façon convaincante, mais dès qu'on leur confie une scène complexe avec des dizaines de personnages, ils se mettent à improviser : ils modifient les visages, les uniformes, l'architecture, voire le nombre de bras. Imaginez que vous demandiez à un modèle d'animer un tableau historique et qu'un soldat se retrouve vêtu d'un autre manteau, tandis que le pont se construit dans l'autre sens. L'auteur Dmitrii DAK, qui publie sur Habr, a contourné ce problème avec le tableau de Lawrence Alma-Tadema « Anno 1812.
Kapitein Benthien aan de Beresina » : on y voit des pontonniers néerlandais construisant un pont sur la Bérézina pendant la retraite de l'armée de Napoléon. Plutôt qu'une seule requête « anime tout », il a découpé le travail en petites parties contrôlables. Le prix de ce contrôle est le temps : selon ses observations, un seul clip réussi exige 4 à 5 générations ratées ou « presque » réussies.
Il s'agit de l'expérience d'un seul projet, et non de statistiques universelles, mais elle montre bien où l'effort est réellement consommé.
D'abord les calques, ensuite le mouvement
La première étape se déroule dans Photoshop. L'auteur sélectionne les personnages et les objets, place chacun sur un calque distinct et regroupe les calques par thème : eau, personnages, structures. Règle principale : les fragments conservent les coordonnées d'origine du canevas, sans être recadrés au plus petit rectangle possible. Ainsi, dans After Effects, les calques se superposent sans ajustement manuel d'échelle ni de position.
Vient ensuite le problème des trous. Si l'on retire un soldat, il faut restituer derrière lui les planches, l'épaule d'un autre homme, la neige. Ces zones sont reconstruites par inpainting (reconstruction du fond par un réseau de neurones), de manière à reproduire la couleur, la lumière, la direction des touches de peinture et la perspective. Sur une image fixe, la couture passe inaperçue ; en mouvement, le fond commence à glisser par rapport à la figure. C'est pourquoi l'auteur vérifie particulièrement soigneusement ces raccords.
Autre étape : les visages. Sur le tableau, de nombreuses figures sont petites, et en animation un visage « flou » trahit la substitution. Les personnages sont donc passés dans un outil d'amélioration des détails, avec la contrainte de ne pas modifier la pose, les proportions ni le caractère pictural. Parallèlement, le fond derrière eux est remplacé par un vert uni, qui sera retiré plus tard en composition à la pipette, car d'autres personnages animés se tiennent derrière.
Un LLM local écrit les prompts, MiniMax H3 anime les fragments
Pour ne pas rédiger lui-même de longues descriptions, l'auteur lance dans LM Studio un modèle multimodal local, Qwen 3.8 27B, en quantification Q5_K_XL (version compressée qui tient dans la mémoire vidéo). On lui transmet trois éléments : une description de base du mouvement souhaité, le fragment du tableau et une liste de contraintes (vêtements, apparence, position des voisins, caméra fixe). Le modèle analyse l'image et produit un prompt détaillé en anglais. Par exemple : huit soldats en uniforme sombre avancent de gauche à droite sur la berge enneigée en portant des rondins, caméra statique, plan moyen en 35 mm, texture de la toile.
La vidéo est générée dans ComfyUI avec le modèle MiniMax H3. Pour accélérer le calcul, l'auteur utilise une LoRA à 10 étapes (petit module complémentaire permettant de calculer plus vite), SageAttention et le nœud Spectrum. Le gros plan a été réalisé en 1,8 mégapixel (1824×1024), les autres plans en 0,3 mégapixel (736×416).
Le résultat n'est pas jugé sur son aspect esthétique, mais sur son aptitude au montage :
- la pose d'origine a-t-elle été conservée ;
- le nombre d'objets et de membres est-il resté identique ;
- le bras ou la jambe d'un personnage traverse-t-il celui d'un autre ;
- le mouvement respecte-t-il la physique du milieu.
C'est précisément à l'aune de ces critères que s'accumulent les 4 à 5 essais ratés pour un essai réussi. La scène avec les officiers et les rondins a dû être refaite plus de 15 fois : un officier traversait un soldat en train de réparer le pont. Les hommes dans l'eau glacée jusqu'à la taille, poussant des rondins et se tenant les uns aux autres, rendent moins bien que les figures sur la berge.
Assemblage dans After Effects et coût de l'expérience
Dans After Effects, les calques et les clips générés sont replacés selon leurs coordonnées d'origine. Pour détacher les figures du fond, l'auteur utilise Roto Brush : il contrôle la stabilité du masque, corrige les contours et examine séparément les vêtements, les mains et les pieds, où les erreurs sont les plus visibles. Enfin, il harmonise la couleur et la lumière pour que les fragments ne ressortent pas de l'ensemble pictural.
Le travail a été réalisé sur une station équipée d'un Intel Core i9-14900K et d'une NVIDIA GeForce RTX 5090 avec 32 Go de mémoire vidéo, entièrement en local. L'auteur souligne que cette carte graphique n'est pas indispensable : les étapes peuvent être effectuées sur un matériel moins puissant, avec des versions allégées des modèles, ou la génération peut être déportée vers le cloud. Dans ce cas, la résolution, la vitesse et le choix des modèles disponibles changent.
Ce qu'il faut retenir en pratique
L'article décrit l'expérience d'un seul auteur, et non un benchmark reproductible, et c'est sa principale limite. Mais la conclusion se généralise. Plus la scène est complexe, plus il est avantageux de la découper en morceaux indépendants et d'intégrer un humain dans la vérification de chaque étape.
La durée du clip final reflète mal l'effort fourni : quelques secondes d'animation peuvent coûter des dizaines de générations et de retouches manuelles. Si l'on fait le même calcul dans le cloud, il s'agira de tokens ou de crédits, et le budget doit prévoir une marge de 4 à 5 tentatives par fragment. Pour les installations muséales, les expositions et les projets pédagogiques, ce type de chaîne de production apporte ce qu'une simple requête adressée à un modèle vidéo ne permet pas : la préservation de la composition de l'original.
- 21 nov. 2026MLCommons se met à mesurer les API d'IA sous charge réelle : 7 mesures pour les agents
- 21 nov. 2026Unsloth met à jour ses versions compressées de Qwen3.8-27B : précision en hausse de 5 à 10 % à taille égale
- 21 nov. 2026Google ouvre les précommandes de lunettes intelligentes avec Gemini à partir de 395 $, ventes dès le 10 décembre
- 21 nov. 2026Via OpenRouter, une DeepSeek piratée a répondu pendant trois jours : les refus sont tombés de 83–98 % à 1 %
Questions clés sur cet article
Que sait-on sur D'abord les calques, ensuite le mouvement ?
La première étape se déroule dans Photoshop. L'auteur sélectionne les personnages et les objets, place chacun sur un calque distinct et regroupe les calques par thème : eau, personnages, structures. Règle principale : les fragments conservent les coordonnées d'origine du canevas, sans être recadrés au plus petit rectangle possible. Ainsi, dans After Effects, les calques se superposent sans ajustement manuel d'échelle ni de position. Vient ensuite le problème des trous.
Que sait-on sur Un LLM local écrit les prompts, MiniMax H3 anime les fragments ?
Pour ne pas rédiger lui-même de longues descriptions, l'auteur lance dans LM Studio un modèle multimodal local, Qwen 3.8 27B, en quantification Q5_K_XL (version compressée qui tient dans la mémoire vidéo). On lui transmet trois éléments : une description de base du mouvement souhaité, le fragment du tableau et une liste de contraintes (vêtements, apparence, position des voisins, caméra fixe). Le modèle analyse l'image et produit un prompt détaillé en anglais.
Que sait-on sur Assemblage dans After Effects et coût de l'expérience ?
Dans After Effects, les calques et les clips générés sont replacés selon leurs coordonnées d'origine. Pour détacher les figures du fond, l'auteur utilise Roto Brush : il contrôle la stabilité du masque, corrige les contours et examine séparément les vêtements, les mains et les pieds, où les erreurs sont les plus visibles. Enfin, il harmonise la couleur et la lumière pour que les fragments ne ressortent pas de l'ensemble pictural.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.