Des IA coulées dans le même moule : pourquoi ChatGPT, Claude et Gemini pensent pareil
Demandez à n'importe quel chatbot un nombre aléatoire entre 1 et 10 : vous obtiendrez presque à coup sûr 7. C'est le symptôme d'un problème systémique : tous les grands LLM ont été entraînés sur des données similaires et penchent vers la « pensée de groupe ». Des chercheurs ont constaté ce schéma chez Claude, ChatGPT et Gemini. Une startup développe des méthodes pour rompre ce consensus et amener les modèles à donner des réponses réellement différentes.
Traité par IA depuis MIT Technology Review ; édité par Hamidun News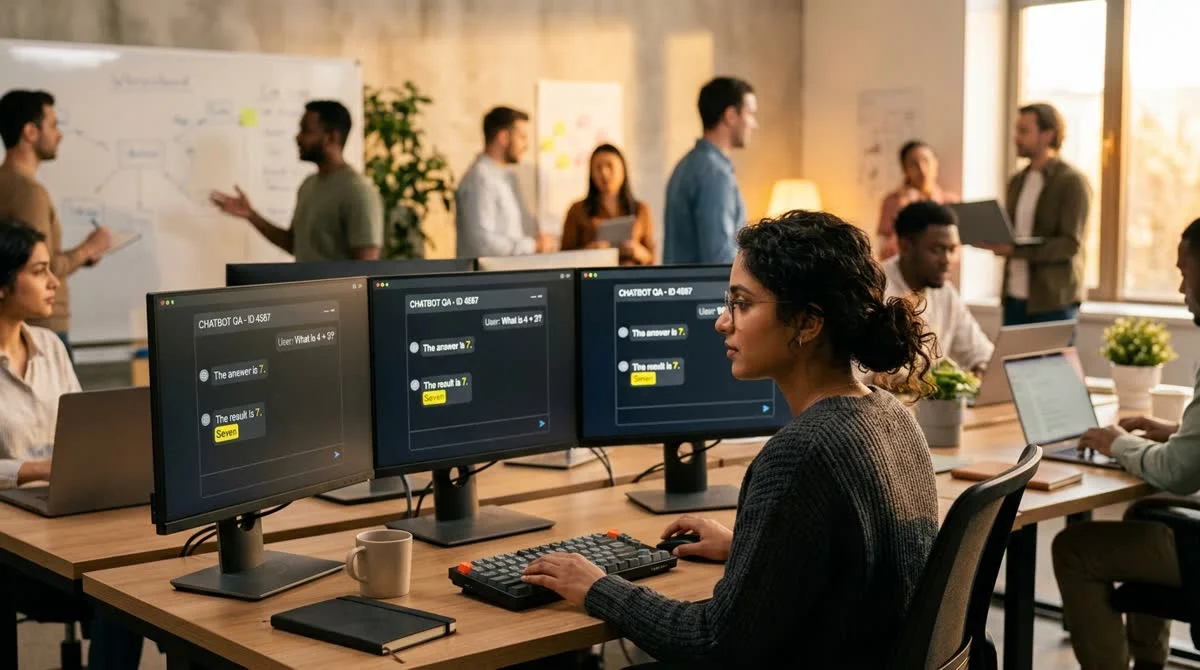
ChatGPT, Claude et Gemini donnent des réponses tout aussi prévisibles à des requêtes similaires. Le 1er juillet 2026, MIT Technology Review a décrit ce phénomène comme une « pensée de groupe » systémique des modèles de langage et présenté une startup qui développe des moyens de la surmonter.
Le test des nombres : pourquoi ce n'est pas une coïncidence ?
Demandez à n'importe quel chatbot populaire un nombre aléatoire entre 1 et 10 : vous obtiendrez presque à coup sûr 7. Reposez la question, vous aurez 3 ou 4, puis 8 ou 9. Le schéma se répète avec une stabilité frappante d'un modèle à l'autre, chez des entreprises différentes.
L'explication est simple : tous les grands LLM ont été entraînés sur des corpus web similaires, où « 7 » revient plus souvent que les autres nombres comme réponse à cette question, car les humains eux-mêmes qualifient le sept de nombre « le plus aléatoire ». Le réglage fin par apprentissage par renforcement (RLHF) récompense en outre les réponses « sûres » et attendues, celles qui obtiennent le plus souvent de bonnes notes de la part d'évaluateurs humains. Les modèles sont littéralement entraînés à donner la réponse prévisible.
- Le sept comme nombre « aléatoire » est un exemple d'école de la tendance des LLM aux schémas tout faits
- Le schéma se retrouve chez Claude (Anthropic), ChatGPT (OpenAI) et Gemini (Google DeepMind)
- La cause : des données d'entraînement qui se recoupent et des procédures de RLHF similaires dans tous les grands laboratoires
Là où la pensée de groupe fait de vrais dégâts
Les nombres ne sont qu'un symptôme visible. Dans les tâches réelles, le problème est plus vaste : les modèles reprennent les mêmes clichés culturels, formulent de façon similaire leurs recommandations stratégiques et proposent des solutions marketing comparables. Quand une entreprise utilise plusieurs LLM pour « diversifier les points de vue », elle obtient souvent des versions reformulées d'un même avis, avec une illusion d'indépendance.
«
Nous avons créé un écosystème où tous les modèles voient le monde de la même façon, parce qu'ils ont lu les mêmes choses », constate MIT Technology Review.
Le problème est particulièrement aigu là où l'originalité compte : génération d'hypothèses scientifiques, contenu atypique, évaluation de risques non triviaux. Dans ces cas, la « vérification indépendante » par plusieurs LLM donne l'illusion de la diversité, mais pas la diversité elle-même.
Ce que propose la startup
MIT Technology Review décrit une startup consacrée aux méthodes pour surmonter la « pensée en gabarit » des modèles de langage. L'architecture exacte de la solution n'a pas été dévoilée. Dans l'industrie, plusieurs approches sont par ailleurs discutées :
- Un entraînement sur des données plus variées, avec l'inclusion délibérée de points de vue de niche
- Une stochasticité contrôlée pendant le réglage fin, qui récompense la variabilité comme objectif explicite
- Des systèmes d'ensemble où plusieurs modèles aux « biais » différents débattent entre eux
- Des métriques de diversité des réponses intégrées d'office aux evals, au même titre que la précision et la sécurité
Ce que cela change
Si les méthodes pour surmonter le « consensus de groupe » parviennent à imposer une nouvelle norme dans le secteur, elles changeront notre façon d'évaluer les systèmes d'IA : la diversité et l'indépendance des réponses deviendront des exigences aussi mesurables que la précision ou la sécurité. Pour les utilisateurs en entreprise, cela ouvre la possibilité d'obtenir de l'IA des perspectives réellement différentes, plutôt qu'une vision statistiquement moyennée sous des formulations variées.
Pourquoi
ChatGPT, Claude et Gemini donnent-ils les mêmes réponses ? MIT Technology Review a identifié un phénomène systématique, qu'il appelle la « pensée de groupe » des réseaux de neurones : ils produisent des réponses tout aussi prévisibles à des requêtes similaires, même lorsqu'on leur demande d'être aléatoires.
Peut-on corriger les réponses identiques de l'IA ?
La startup décrite dans l'article développe des moyens de surmonter ce phénomène dans les modèles de langage.
- 1 nov. 2026Les modèles locaux battus par Opus et Codex : 0,21 sur MacBook contre 1,00 pour Codex
- 1 nov. 2026Kimi obtient 96,2 % à un test d'analytique sur une base 1C et s'impose comme solution de repli en cas de blocage de Claude
- 1 nov. 2026OpenAI réécrit les règles de comportement de GPT : cinq valeurs et une chaîne de priorités
- 1 nov. 2026Google reconnaît que l'AI Mode réduit les revenus de la recherche, l'action chute de 15%
Questions clés sur cet article
Le test des nombres : pourquoi ce n'est pas une coïncidence ?
Demandez à n'importe quel chatbot populaire un nombre aléatoire entre 1 et 10 : vous obtiendrez presque à coup sûr 7. Reposez la question, vous aurez 3 ou 4, puis 8 ou 9. Le schéma se répète avec une stabilité frappante d'un modèle à l'autre, chez des entreprises différentes. L'explication est simple : tous les grands LLM ont été entraînés sur des corpus web similaires, où « 7 » revient plus souvent que les autres nombres comme réponse à cette question, car les humains eux-mêmes qualifient le sept de nombre « le plus aléatoire ». Le réglage fin par apprentissage par renforc
Pourquoi ChatGPT, Claude et Gemini donnent-ils les mêmes réponses ?
MIT Technology Review a identifié un phénomène systématique, qu'il appelle la « pensée de groupe » des réseaux de neurones : ils produisent des réponses tout aussi prévisibles à des requêtes similaires, même lorsqu'on leur demande d'être aléatoires.
Peut-on corriger les réponses identiques de l'IA ?
La startup décrite dans l'article développe des moyens de surmonter ce phénomène dans les modèles de langage.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.