Docling Parse : un pipeline d'analyse de PDF précis au caractère et à la coordonnée près
Docling Parse ne lit pas un PDF comme un flux de texte, mais comme un document bidimensionnel : chaque mot et chaque caractère reçoivent des coordonnées sur la page. Le tutoriel montre comment construire ce pipeline, avec un PDF de test généré, une analyse de bas niveau, des superpositions visuelles et un export JSON et CSV prêts pour les systèmes RAG et l'analyse de l'ordre de lecture. L'approche conserve le contexte spatial que les parseurs standard écartent, ce qui compte pour les documents à colonnes, tableaux et notes de bas de page.
Traité par IA depuis MarkTechPost ; édité par Hamidun News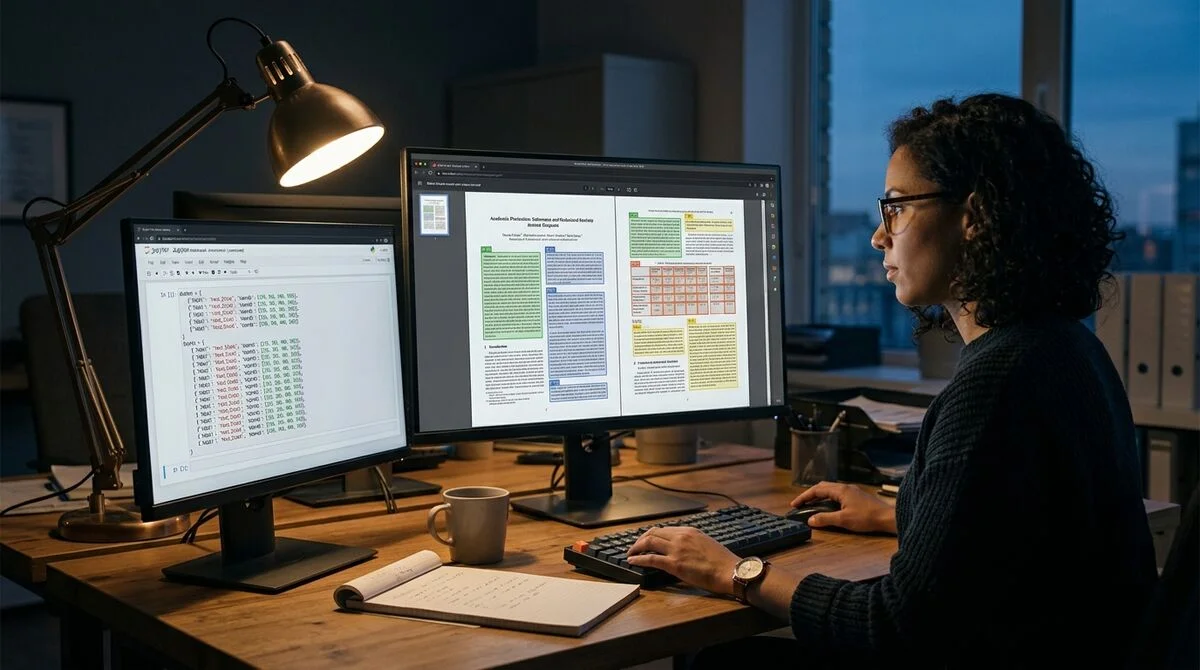
Docling Parse est une bibliothèque de bas niveau pour l'analyse structurelle de documents PDF. Le tutoriel montre comment construire un pipeline complet d'analyse de documents, précis au caractère et à la coordonnée de page près, et obtenir des données prêtes pour les systèmes RAG et les tâches d'extraction de connaissances.
Pourquoi l'analyse structurelle est nécessaire
Les parseurs PDF standard travaillent en surface : ils extraient le texte en un seul flux linéaire et perdent la position des éléments, l'ordre des colonnes et la structure des tableaux. Pour rechercher des mots ou copier du texte, cela suffit. Mais pour les systèmes RAG et la document intelligence, il faut savoir où se trouve exactement chaque élément sur la page : ce qui est à gauche, ce qui est à droite, ce qui est un titre et ce qui est une légende de tableau.
Docling Parse aborde le problème autrement. La bibliothèque analyse le PDF non comme un flux de caractères, mais comme un document bidimensionnel aux relations spatiales explicites. Chaque mot, caractère et ligne reçoit des coordonnées de bounding box rattachées à une page précise. Cela permet de restituer le bon ordre de lecture même dans des documents à la mise en page atypique : texte sur plusieurs colonnes, notes latérales, tableaux à cellules fusionnées et éléments vectoriels superposés.
Comment fonctionne le pipeline
Le tutoriel construit le flux de travail de zéro. La première étape consiste à préparer l'environnement Python : les auteurs détaillent les conflits de dépendances fréquents dans Google Colab et montrent comment configurer l'environnement pour que les paquets n'entrent pas en conflit entre eux.
Pour les tests, il génère un PDF spécial de plusieurs pages, avec du texte sur plusieurs colonnes, des blocs imitant des tableaux, des formes vectorielles et une image raster intégrée. Le document est volontairement complexe : un fichier simple d'une seule ligne n'aurait pas permis de montrer les capacités d'un parseur de bas niveau en conditions réelles.
Docling Parse analyse le fichier et renvoie :
- les mots avec leurs coordonnées de bounding box sur chaque page
- les caractères individuels avec leurs positions exactes
- les lignes et leurs relations spatiales les unes avec les autres
- des données structurelles pour restituer le bon ordre de lecture
Des superpositions visuelles sont dessinées par-dessus les résultats : des rectangles colorés autour de chaque élément détecté. On voit ainsi littéralement ce que le parseur a lu dans le document, ce qui simplifie nettement le débogage : on repère immédiatement où la frontière entre deux blocs a été mal définie ou où plusieurs caractères ont fusionné en un seul élément non reconnu.
Ce que l'on obtient en sortie
Les données finales sont enregistrées dans deux formats. Le JSON conserve toute la structure hiérarchique du document : pages → blocs → lignes → mots → caractères, chacun avec ses coordonnées et ses métadonnées. Le CSV fournit une représentation à plat de tous les éléments, pratique pour une analyse rapide dans pandas ou Excel.
Les deux formats conviennent à l'étape suivante du pipeline : transmettre les données à un système RAG, entraîner un classificateur de documents ou faire une recherche sémantique tenant compte du contexte spatial. On peut par exemple formuler la requête « toutes les lignes de la colonne de droite » ou « le texte situé juste sous le titre », ce qui est par principe impossible avec une extraction de texte à plat ordinaire.
Ce que cela signifie
L'analyse de PDF de bas niveau est une couche nécessaire, mais souvent négligée, de la document intelligence. La plupart des équipes démarrent avec des outils prêts à l'emploi qui masquent la structure du document derrière une API pratique. Docling Parse ouvre directement ce niveau : sans API externe, entièrement en local, avec un code reproductible.
Pour les entreprises qui bâtissent des systèmes RAG d'entreprise ou des produits de traitement de documents, c'est une brique de base de l'architecture : la couche sans laquelle la qualité d'extraction de l'information est difficile à améliorer.
- 1 nov. 2026Test de 16 modèles sur 7 moteurs de recherche : Exa obtient en moyenne 10,5 points sur 14, SearXNG environ 3
- 1 nov. 2026L'agent vidéo StreamVibe de Google devance les autres modèles de 10,7 % sur le timing et la qualité des réponses
- 1 nov. 2026OpenAI réécrit les règles de comportement de GPT : cinq valeurs et une chaîne de priorités
- 1 nov. 2026Les bots vocaux à base de LLM s'appuient sur le classifieur rapide Jev : une décision en 200–500 ms
Questions clés sur cet article
Pourquoi l'analyse structurelle est nécessaire?
Les parseurs PDF standard travaillent en surface : ils extraient le texte en un seul flux linéaire et perdent la position des éléments, l'ordre des colonnes et la structure des tableaux. Pour rechercher des mots ou copier du texte, cela suffit. Mais pour les systèmes RAG et la document intelligence, il faut savoir où se trouve exactement chaque élément sur la page : ce qui est à gauche, ce qui est à droite, ce qui est un titre et ce qui est une légende de tableau. Docling Parse aborde le problème autrement. La bibliothèque analyse le PDF non comme un flux de caractères, mai
Comment fonctionne le pipeline?
Le tutoriel construit le flux de travail de zéro. La première étape consiste à préparer l'environnement Python : les auteurs détaillent les conflits de dépendances fréquents dans Google Colab et montrent comment configurer l'environnement pour que les paquets n'entrent pas en conflit entre eux. Pour les tests, il génère un PDF spécial de plusieurs pages, avec du texte sur plusieurs colonnes, des blocs imitant des tableaux, des formes vectorielles et une image raster intégrée. Le document est volontairement complexe : un fichier simple d'une seule ligne n'aurait pas permis d
Que sait-on sur Ce que l'on obtient en sortie ?
Les données finales sont enregistrées dans deux formats. Le JSON conserve toute la structure hiérarchique du document : pages → blocs → lignes → mots → caractères, chacun avec ses coordonnées et ses métadonnées. Le CSV fournit une représentation à plat de tous les éléments, pratique pour une analyse rapide dans pandas ou Excel. Les deux formats conviennent à l'étape suivante du pipeline : transmettre les données à un système RAG, entraîner un classificateur de documents ou faire une recherche sémantique tenant compte du contexte spatial. On peut par exemple formuler la requ
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.