Fix Price déploie un service VLM de contrôle des rayons et des étiquettes de prix dans 8 000 magasins
Fix Price a automatisé le contrôle des rayons et des étiquettes de prix dans ses plus de 8 000 magasins grâce à un service de vision par ordinateur reposant sur des VLM externes. Plutôt que d'entraîner ses propres réseaux de neurones, l'enseigne utilise des modèles multimodaux prêts à l'emploi qui repèrent, à partir d'une photo de rayon, les emplacements vides et les erreurs d'étiquetage. L'équipe du centre d'analyse de données de Fix Price a raconté comment elle a lancé un service industriel sans long cycle de développement ML.
Traité par IA depuis Habr AI ; édité par Hamidun News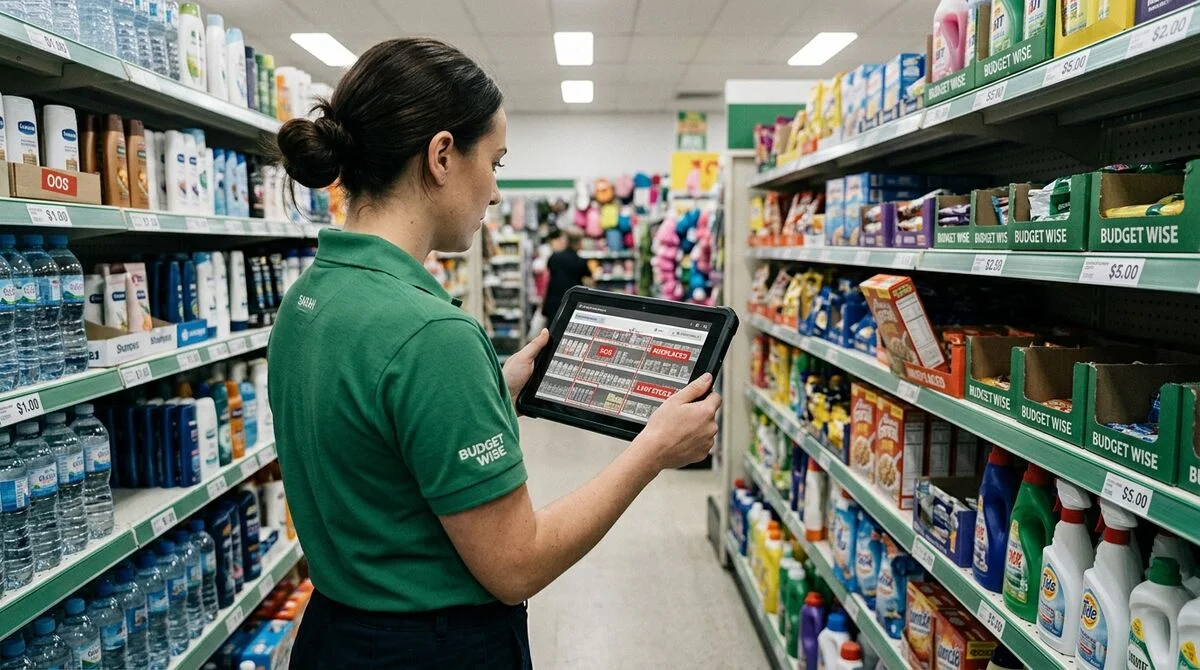
Fix Price a automatisé le contrôle de la mise en rayon et des étiquettes de prix dans ses plus de 8 000 magasins en déployant un service de vision par ordinateur reposant sur des Vision Language Models externes, sans développer de modèles de ML maison de zéro et sans cycle d'entraînement de plusieurs années.
8 000 magasins, une seule tâche
Fix Price est une chaîne de magasins à prix fixes qui compte des dizaines de millions de clients en Russie et dans la CEI. Plus de 8 000 points de vente représentent des milliers de rayons à vérifier chaque jour : les produits suivent-ils le planogramme, chaque article a-t-il son étiquette de prix, y a-t-il des emplacements vides ?
Un contrôle manuel à cette échelle est irréaliste : impossible d'envoyer chaque jour un contrôleur dans chacun des 8 000 magasins. Or l'erreur coûte directement : un rayon vide ou une étiquette erronée, c'est une vente perdue sur le moment et une mauvaise expérience que le client retient longtemps. Dans une chaîne de cette taille, même un faible pourcentage de ces cas se traduit par des pertes financières notables.
Le centre d'analyse de données de Fix Price devait donc détecter automatiquement les manquements de mise en rayon et les erreurs d'étiquetage, rapidement, à l'échelle industrielle et sans investissement excessif dans une infrastructure CV maison.
Pourquoi un VLM plutôt qu'un modèle maison
La voie classique en vision par ordinateur pour le commerce de détail consiste à entraîner un réseau de neurones sur mesure à partir de photos de rayons annotées. Cela fonctionne, mais il faut des milliers d'images annotées, une équipe d'ingénieurs ML, une infrastructure d'entraînement et un long cycle à chaque changement d'assortiment.
Fix Price a choisi une alternative : des Vision Language Models (VLM) externes. Ce sont des modèles multimodaux capables d'analyser une image et de répondre à des questions à son sujet en langage naturel, selon le même principe que GPT-4o Vision ou Claude avec prise en charge des images.
Principaux avantages de l'approche VLM dans ce cas :
- Démarrage rapide sans grand jeu de données annoté
- Un seul modèle vérifie à la fois la mise en rayon, les étiquettes et la disponibilité des produits
- Les nouveaux types de contrôle s'ajoutent en modifiant le prompt, sans réentraînement
- Souplesse pour s'étendre à de nouvelles catégories et à de nouveaux formats de magasin
- Coûts de développement et de maintenance réduits par rapport à une CV sur mesure
Comment fonctionne le service
Les images proviennent de caméras de surveillance ou des appareils mobiles des employés du magasin. Le VLM reçoit la photo et analyse l'image selon plusieurs critères : conformité au planogramme, présence d'une étiquette de prix sur chaque article, absence d'emplacements vides dans le rayon.
En sortie, il produit une liste structurée de manquements rattachée à un magasin précis. L'employé responsable reçoit une alerte et corrige le problème avant que le client ne le voie. La réactivité progresse, et les tournées manuelles avec un carnet reculent.
«
Je pense que nous savons tous comment réagissent les clients face à une étiquette manquante ou à un prix erroné, et ce que l'on ressent devant un rayon vide, sans le produit pour lequel on est venu », a déclaré Kristina Istratova, responsable du centre d'analyse de données de Fix Price.
Ce que cela change
Le cas de Fix Price montre que les VLM ont tellement abaissé la barrière d'entrée de la vision par ordinateur industrielle qu'un grand distributeur a lancé un service opérationnel sans projet ML de plusieurs années. 8 000 magasins, ce n'est pas un pilote, mais une charge de production réelle. Pour le reste du commerce de détail, le signal est clair : automatiser le contrôle des rayons n'exige plus de laboratoire ML interne.
- 1 nov. 2026OpenAI réécrit les règles de comportement de GPT : cinq valeurs et une chaîne de priorités
- 1 nov. 2026Google reconnaît que l'AI Mode réduit les revenus de la recherche, l'action chute de 15%
- 31 oct. 2026Un auteur soumet son scénario à un jury d'IA : le verdict coûte 850 000 tokens
- 31 oct. 2026Anthropic : replier les sous-agents dans une seule boucle a doublé la vitesse des tâches chez un client
Questions clés sur cet article
Que sait-on sur 8 000 magasins, une seule tâche ?
Fix Price est une chaîne de magasins à prix fixes qui compte des dizaines de millions de clients en Russie et dans la CEI. Plus de 8 000 points de vente représentent des milliers de rayons à vérifier chaque jour : les produits suivent-ils le planogramme, chaque article a-t-il son étiquette de prix, y a-t-il des emplacements vides ? Un contrôle manuel à cette échelle est irréaliste : impossible d'envoyer chaque jour un contrôleur dans chacun des 8 000 magasins. Or l'erreur coûte directement : un rayon vide ou une étiquette erronée, c'est une vente perdue sur le moment et une
Pourquoi un VLM plutôt qu'un modèle maison?
La voie classique en vision par ordinateur pour le commerce de détail consiste à entraîner un réseau de neurones sur mesure à partir de photos de rayons annotées. Cela fonctionne, mais il faut des milliers d'images annotées, une équipe d'ingénieurs ML, une infrastructure d'entraînement et un long cycle à chaque changement d'assortiment. Fix Price a choisi une alternative : des Vision Language Models (VLM) externes. Ce sont des modèles multimodaux capables d'analyser une image et de répondre à des questions à son sujet en langage naturel, selon le même principe que GPT-4o Vi
Comment fonctionne le service?
Les images proviennent de caméras de surveillance ou des appareils mobiles des employés du magasin. Le VLM reçoit la photo et analyse l'image selon plusieurs critères : conformité au planogramme, présence d'une étiquette de prix sur chaque article, absence d'emplacements vides dans le rayon. En sortie, il produit une liste structurée de manquements rattachée à un magasin précis. L'employé responsable reçoit une alerte et corrige le problème avant que le client ne le voie. La réactivité progresse, et les tournées manuelles avec un carnet reculent. « Je pense que nous savons
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.