La fenêtre de contexte n'est pas une mémoire : ce que les développeurs d'agents IA doivent comprendre
Les développeurs d'agents IA prennent souvent une grande fenêtre de contexte pour une mémoire à long terme, et c'est une erreur d'architecture fondamentale. Le contexte disparaît à la fin de chaque session, alors qu'une vraie mémoire exige un système distinct : RAG, compression ou stockage épisodique. Un agent doté d'une fenêtre de 2 millions de tokens oubliera quand même l'utilisateur dès le lendemain.
Traité par IA depuis Machine Learning Mastery ; édité par Hamidun News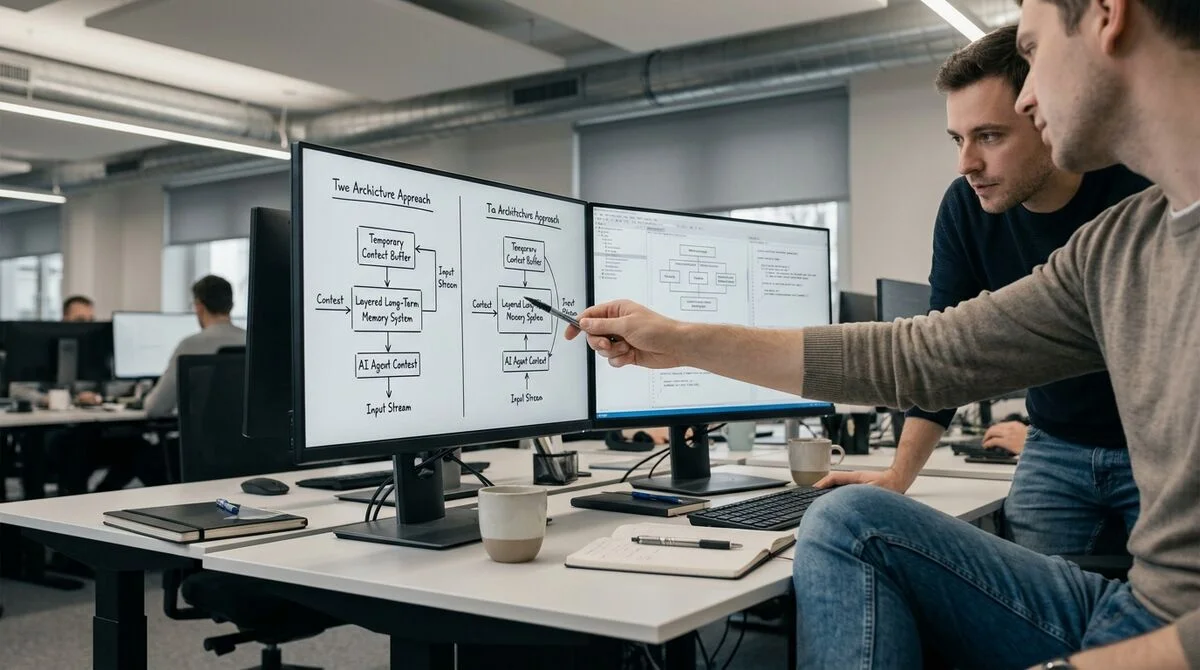
Une grande fenêtre de contexte est un argument courant au moment de choisir un modèle pour un agent IA. Mais elle résout un autre problème que la mémoire à long terme. Les développeurs qui les confondent bâtissent des agents affectés d'un défaut d'architecture fondamental.
Le contexte est un bureau, pas des archives
La fenêtre de contexte fonctionne comme la mémoire vive d'un ordinateur : tout ce qu'elle contient, l'agent le "voit" à l'instant présent et peut l'utiliser dans sa réponse. Quand la session se termine, le contenu disparaît sans laisser de trace.
La mémoire à long terme est fondamentalement différente : la connaissance persiste d'une session à l'autre, elle est indexée et rappelée au besoin. C'est un système distinct, avec sa propre architecture, conçu indépendamment du choix du modèle.
Un agent doté d'une fenêtre de 2 millions de tokens oublie toujours l'utilisateur le lendemain. Agrandir le contexte ne fait que repousser l'échéance, sans éliminer le problème.
Cinq techniques pour une vraie mémoire
Les développeurs d'agents IA recourent à plusieurs approches pour gérer les connaissances entre les sessions :
- RAG (Retrieval-Augmented Generation) : l'agent interroge une base de connaissances externe uniquement quand c'est nécessaire, au lieu de tout conserver dans la fenêtre. Adapté aux grands corpus de documents.
- Compression : un long historique de conversation est condensé en un court résumé qui occupe 10 à 20 fois moins de tokens.
- Episodic memory : les faits clés sur l'utilisateur ou la tâche sont enregistrés dans un stockage structuré et chargés au début de la session suivante.
- Summarization chains : les gros documents sont convertis en synthèses avant d'atteindre le contexte de l'agent.
- Selective storage : un orchestrateur décide de ce qu'il faut conserver, de ce qu'il faut compresser et de ce qu'il faut jeter purement et simplement.
Chaque outil répond à un besoin précis. Un chatbot de support a besoin de mémoire épisodique ; un agent analyste travaillant sur un corpus de documents, de RAG.
Le problème du contexte saturé
Il y a une autre raison de ne pas s'en remettre à la seule grande fenêtre : le phénomène "lost in the middle". Les recherches montrent que les modèles traitent moins bien l'information située au milieu d'un long contexte : la qualité de la réponse baisse même quand la place est techniquement disponible.
La conclusion pratique : même si le contexte peut techniquement contenir 500 pages de texte, il ne faut pas y entasser n'importe quoi. La sélectivité et la compression donnent de meilleures réponses que le remplissage en force brute.
"La fenêtre de contexte est un bureau.
On n'y empile pas tout ce qu'on possède : on n'en sort que ce dont on a besoin tout de suite."
Architecture de mémoire pour la production
Les équipes qui construisent des agents pour de vrais utilisateurs doivent concevoir le système de mémoire séparément du choix du modèle. Les questions clés à l'étape de conception : que faut-il retenir entre les sessions, quel est le TTL de chaque type d'information, comment l'agent décide de ce qu'il enregistre, et où le stocker : dans une base vectorielle, une base relationnelle ou un graphe de connaissances.
Sans réponses à ces questions, l'agent reste un outil jetable : l'utilisateur doit réexpliquer le contexte à chaque lancement. C'est particulièrement critique dans le support, l'éducation et la médecine, partout où la connaissance de l'utilisateur s'accumule sur des semaines.
Ce que cela signifie
Choisir un modèle à grand contexte relève de la tactique. Le système de mémoire, lui, relève de l'architecture. Les développeurs qui confondent les deux découvriront le problème non pas dans le prototype, mais dans le produit, quand les utilisateurs sont déjà mécontents. Concevez la mémoire dès le premier jour.
- 1 nov. 2026Les modèles locaux battus par Opus et Codex : 0,21 sur MacBook contre 1,00 pour Codex
- 1 nov. 2026Le juge d'EditAgent (Adobe) retient une retouche valable dans 81,3% des cas, contre 74,8% pour EditScore
- 1 nov. 2026Test de 16 modèles sur 7 moteurs de recherche : Exa obtient en moyenne 10,5 points sur 14, SearXNG environ 3
- 1 nov. 2026L'agent vidéo StreamVibe de Google devance les autres modèles de 10,7 % sur le timing et la qualité des réponses
Questions clés sur cet article
Que sait-on sur Le contexte est un bureau, pas des archives ?
La fenêtre de contexte fonctionne comme la mémoire vive d'un ordinateur : tout ce qu'elle contient, l'agent le "voit" à l'instant présent et peut l'utiliser dans sa réponse. Quand la session se termine, le contenu disparaît sans laisser de trace. La mémoire à long terme est fondamentalement différente : la connaissance persiste d'une session à l'autre, elle est indexée et rappelée au besoin. C'est un système distinct, avec sa propre architecture, conçu indépendamment du choix du modèle. Un agent doté d'une fenêtre de 2 millions de tokens oublie toujours l'utilisateur le len
Que sait-on sur Cinq techniques pour une vraie mémoire ?
Les développeurs d'agents IA recourent à plusieurs approches pour gérer les connaissances entre les sessions : RAG (Retrieval-Augmented Generation) : l'agent interroge une base de connaissances externe uniquement quand c'est nécessaire, au lieu de tout conserver dans la fenêtre. Adapté aux grands corpus de documents. Compression : un long historique de conversation est condensé en un court résumé qui occupe 10 à 20 fois moins de tokens. Episodic memory : les faits clés sur l'utilisateur ou la tâche sont enregistrés dans un stockage structuré et chargés au début de la sessio
Que sait-on sur Le problème du contexte saturé ?
Il y a une autre raison de ne pas s'en remettre à la seule grande fenêtre : le phénomène "lost in the middle". Les recherches montrent que les modèles traitent moins bien l'information située au milieu d'un long contexte : la qualité de la réponse baisse même quand la place est techniquement disponible. La conclusion pratique : même si le contexte peut techniquement contenir 500 pages de texte, il ne faut pas y entasser n'importe quoi. La sélectivité et la compression donnent de meilleures réponses que le remplissage en force brute. "La fenêtre de contexte est un bureau. On
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.