Accélérer les modèles PyTorch : guide pratique de torch.profiler
Hugging Face a publié la première partie de son guide sur torch.profiler, l'outil d'analyse de performances intégré à PyTorch. Il suit chaque opération sur le GPU et le CPU, met au jour les goulots d'étranglement dans les calculs et aide à réduire le temps d'entraînement des modèles. Ce guide s'adresse aux ingénieurs ML et aux chercheurs qui veulent comprendre où passe leur puissance de calcul et accélérer leurs projets.
Traité par IA depuis Hugging Face Blog ; édité par Hamidun News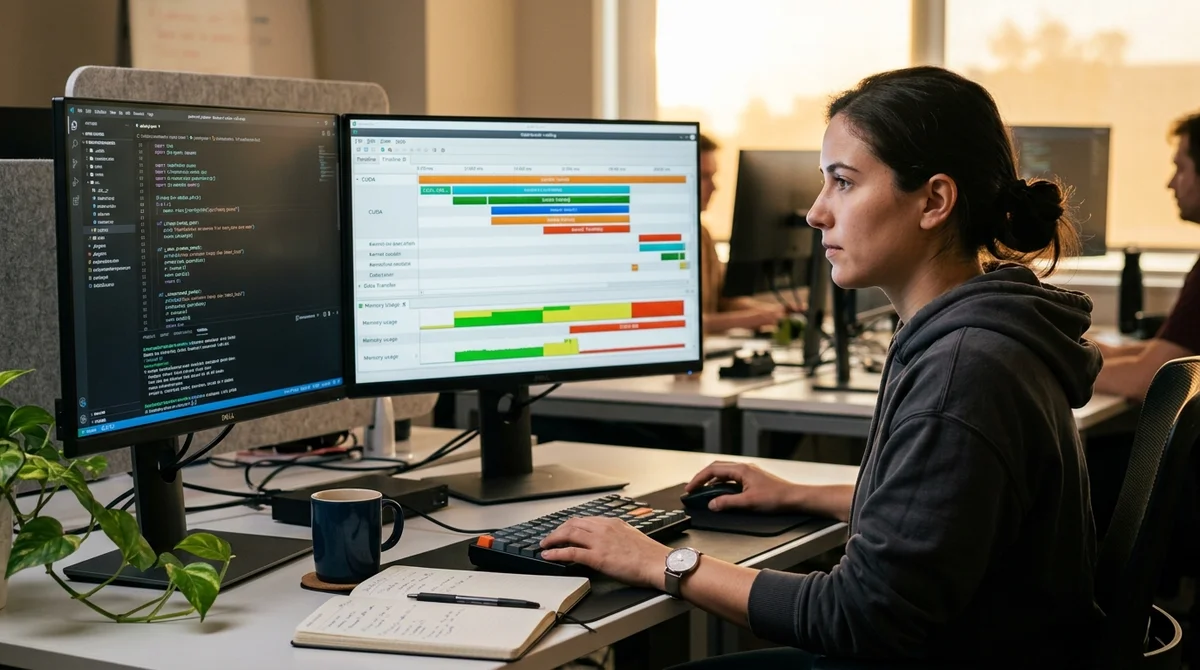
PyTorch intègre un outil, torch.profiler, pour analyser les performances des modèles. Il suit chaque opération sur le GPU et le CPU, ce qui aide à trouver les goulots d'étranglement dans les calculs et à optimiser le temps d'entraînement.
Pourquoi profiler les modèles
Sans profilage, le développeur ne voit que le chiffre final : « l'époque a pris 2 heures ». Mais pourquoi 2 heures ? Où le temps est-il passé ? Le dataloader est-il peut-être lent ? Une opération sur le GPU est-elle inefficace ? Ou le GPU reste-t-il inactif en attendant les données du CPU ?
Optimiser à l'aveugle, c'est deviner. Vous modifiez le batch size, la vitesse de chargement, la précision des calculs, et le résultat ne s'améliore pas, car vous optimisez le mauvais goulot d'étranglement. torch.profiler vous épargne cette perte de temps : il montre la répartition exacte du temps et de la mémoire par opération.
Comment fonctionne torch.profiler
L'outil trace l'exécution du code au niveau des kernels CUDA et des threads CPU. Pour chaque opération, par exemple une multiplication matricielle dans une couche Linear ou une convolution dans Conv2d, il enregistre l'heure de début, l'heure de fin et la mémoire utilisée. Les résultats peuvent être exportés dans un format compatible avec Chrome DevTools et visualisés sous forme de timeline.
Les principales métriques du profiler :
- Exclusive time : le temps pris par l'opération elle-même (hors opérations imbriquées)
- Inclusive time : le temps de l'opération avec tous ses appels imbriqués
- Memory : pic d'utilisation de la mémoire GPU pendant l'opération
- Sync time : temps passé à synchroniser CPU et GPU (le goulot d'étranglement numéro un)
Quand torch.profiler révèle des problèmes
Scénario typique : un modèle s'entraîne lentement, vous pensez qu'il faut un GPU plus rapide, mais le profiler montre que 60 % du temps de l'époque est de l'attente de données du dataloader. Le problème ne vient pas du GPU, mais du chargement des données. La solution : augmenter num_workers dans DataLoader ou utiliser la pinned memory.
Autre exemple : un modèle s'entraîne sur un système distribué (plusieurs GPU) et le profiler montre qu'une grande part du temps part dans la synchronisation des gradients entre appareils. C'est un signal pour optimiser le graphe de communication ou revoir la stratégie de parallélisme.
Précision importante : le profilage ajoute lui-même de l'overhead. Si vous lancez le profiler sur toute la boucle d'entraînement, il peut ralentir les calculs de 10–30 %. Pour des mesures précises, mieux vaut ne profiler que le bloc de code qui vous intéresse (par exemple, une seule passe forward-backward).
Ce que cela signifie
torch.profiler est la première étape avant toute optimisation. Ne devinez pas où se trouve le goulot d'étranglement : profilez, examinez les résultats et optimisez précisément ce qui ralentit. Cela peut épargner des semaines d'expériences et orienter les efforts là où ils porteront vraiment leurs fruits. Pour les ingénieurs ML qui veulent accélérer l'entraînement de leurs modèles, c'est un outil de base.
- 2 nov. 2026TensorFold 1.2.0 augmente de 44,2% le débit de Qwen3.8-27B sur M3 Ultra à 16 flux
- 1 nov. 2026Les modèles locaux battus par Opus et Codex : 0,21 sur MacBook contre 1,00 pour Codex
- 1 nov. 2026Un auteur de Habr affine YOLOv8l sur des radiographies dentaires et atteint un mAP50 de 0,642
- 1 nov. 2026Les bots vocaux à base de LLM s'appuient sur le classifieur rapide Jev : une décision en 200–500 ms
Questions clés sur cet article
Pourquoi profiler les modèles?
Sans profilage, le développeur ne voit que le chiffre final : « l'époque a pris 2 heures ». Mais pourquoi 2 heures ? Où le temps est-il passé ? Le dataloader est-il peut-être lent ? Une opération sur le GPU est-elle inefficace ? Ou le GPU reste-t-il inactif en attendant les données du CPU ? Optimiser à l'aveugle, c'est deviner. Vous modifiez le batch size, la vitesse de chargement, la précision des calculs, et le résultat ne s'améliore pas, car vous optimisez le mauvais goulot d'étranglement. torch.profiler vous épargne cette perte de temps : il montre la répartition exacte
Comment fonctionne torch.profiler?
L'outil trace l'exécution du code au niveau des kernels CUDA et des threads CPU. Pour chaque opération, par exemple une multiplication matricielle dans une couche Linear ou une convolution dans Conv2d, il enregistre l'heure de début, l'heure de fin et la mémoire utilisée. Les résultats peuvent être exportés dans un format compatible avec Chrome DevTools et visualisés sous forme de timeline. Les principales métriques du profiler : Exclusive time : le temps pris par l'opération elle-même (hors opérations imbriquées) Inclusive time : le temps de l'opération avec tous ses appel
Quand torch.profiler révèle des problèmes?
Scénario typique : un modèle s'entraîne lentement, vous pensez qu'il faut un GPU plus rapide, mais le profiler montre que 60 % du temps de l'époque est de l'attente de données du dataloader. Le problème ne vient pas du GPU, mais du chargement des données. La solution : augmenter num_workers dans DataLoader ou utiliser la pinned memory. Autre exemple : un modèle s'entraîne sur un système distribué (plusieurs GPU) et le profiler montre qu'une grande part du temps part dans la synchronisation des gradients entre appareils. C'est un signal pour optimiser le graphe de communicat
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.