LLM azerbaïdjanais sur SageMaker : comment Azercell a résolu le problème des langues rares
L'opérateur de télécommunications azerbaïdjanais Azercell a développé son propre grand modèle de langage en utilisant Amazon SageMaker AI. En six semaines de collaboration intensive avec l'AWS Generative AI Innovation Center, l'entreprise a surmonté avec succès la pénurie chronique de données d'entraînement et la complexité morphologique de la langue azerbaïdjanaise. Un LLM prêt pour la production a été créé pour les chatbots orientés vers les clients et les processus métier internes — le premier exemple industriel de la région.
Traité par IA depuis AWS Machine Learning Blog ; édité par Hamidun News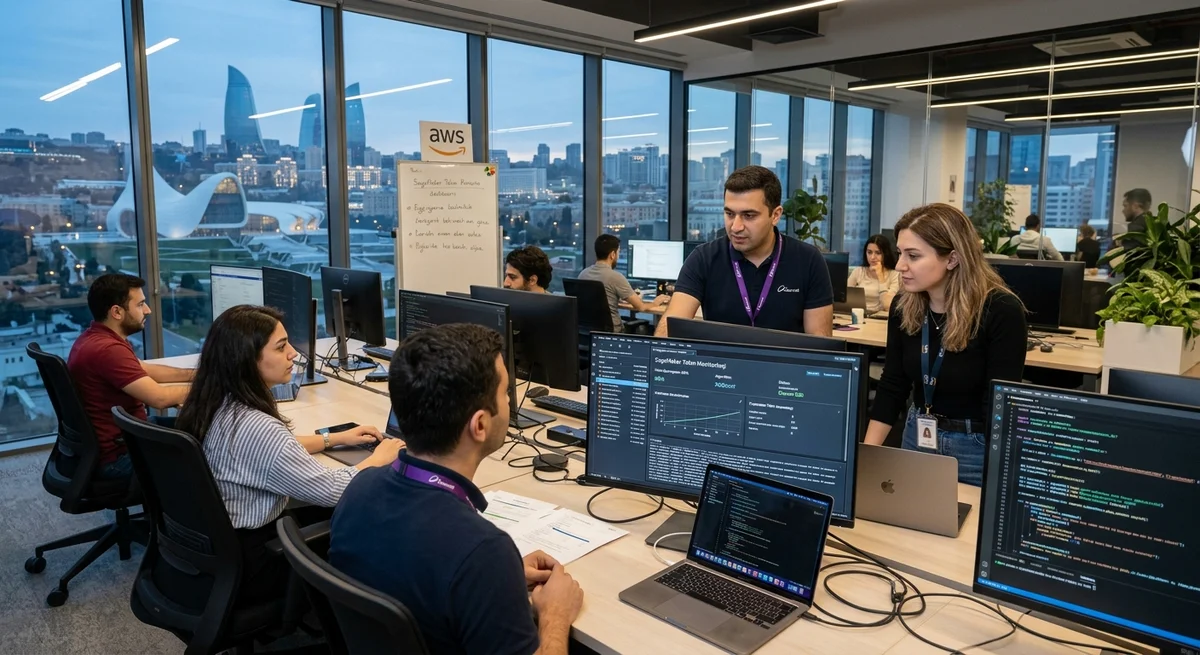
Azercell, un opérateur de télécommunications azerbaïdjanais, a développé son propre modèle de langage sur Amazon SageMaker AI. L'entreprise s'est fixé un objectif ambitieux : créer un LLM de qualité production pour une langue morphologiquement complexe avec une pénurie de données prêtes à l'emploi et sans solutions existantes sur le marché.
Pourquoi l'azerbaïdjanais est un cas complexe
L'azerbaïdjanais est un représentant typique des langues agglutinantes avec une morphologie riche. Un seul mot peut porter plusieurs suffixes qui changent drastiquement son sens et sa fonction grammaticale. Cela nécessite des approches entièrement différentes de la tokenisation et de l'entraînement des modèles par rapport aux langues indo-européennes. À la complexité morphologique s'ajoute un facteur critique : le volume de données d'entraînement ouvertes en azerbaïdjanais est nettement inférieur à celui de l'anglais, du russe ou de l'espagnol. Les méthodes standard d'entraînement des LLM, testées sur de grands corpus textuels, ne fonctionnent pas directement ici.
- La complexité morphologique exige une tokenisation spécialisée
- Déficit de données : 100+ fois moins de textes que pour les grandes langues
- Absence d'exemples existants et de bonnes pratiques pour les LLMs en azerbaïdjanais
- Nécessité d'adapter les modèles fondamentaux entraînés sur des données en anglais
- Exigence d'intégrer le modèle dans les systèmes de production des télécommunications
Comment Azercell a résolu la tâche
L'entreprise s'est associée avec le AWS Generative AI Innovation Center. Au cours de six semaines intensives de travail conjoint, des spécialistes des deux côtés ont construit un framework prêt pour la production sur Amazon SageMaker. La solution incluait plusieurs composants clés : une préparation adéquate et un nettoyage des données existantes, une tokenisation spécialisée tenant compte de la morphologie de l'azerbaïdjanais, et une optimisation du processus d'entraînement pour fonctionner avec des volumes de données plus petits. Les ingénieurs ont utilisé le transfer learning — en adaptant des modèles déjà entraînés plutôt que d'entraîner à partir de zéro sur un corpus azerbaïdjanais.
Ce qui en a résulté : deux rôles pour le modèle
Le modèle d'Azercell fonctionne dans deux directions. Premièrement, il sert de chatbot orienté client qui aide les abonnés à répondre aux questions sur les services et les tarifs en azerbaïdjanais. Deuxièmement, le modèle est utilisé dans les processus commerciaux internes : traitement des demandes entrantes, analyse de la parole dans les centres d'appels, classification des problèmes et recommandations de services personnalisées. La concentration sur l'azerbaïdjanais permet d'éviter la perte de sens lors de la traduction et garantit que le modèle comprend les contextes locaux et les nuances du langage.
Ce que cela signifie
Ceci est le premier exemple public d'un LLM entièrement fonctionnel pour l'azerbaïdjanais développé dans une infrastructure cloud. Le cas montre que les plateformes cloud peuvent adapter les LLMs non seulement pour les langues rares, mais aussi pour des tâches industrielles spécifiques. Pour les autres entreprises de la région, ceci est un signal : l'investissement dans votre propre modèle de langage est réel et réalisable en quelques semaines.
- 27 oct. 2026BioStack lève 9,5 millions de dollars pour les données d'entraînement de l'IA médicale
- 27 oct. 2026Anthropic dépose son S-1 auprès de la SEC : IPO sous le ticker ANT et 16,3 milliards en six mois
- 27 oct. 2026Qwen3.8 a tenté de charger un fichier vers le cloud d'Alibaba à Pékin depuis le bac à sable de Cohere
- 26 oct. 2026Anthropic dépose un S-1 auprès de la SEC et va entrer au Nasdaq sous le ticker ANT
Questions clés sur cet article
Pourquoi l'azerbaïdjanais est un cas complexe?
L'azerbaïdjanais est un représentant typique des langues agglutinantes avec une morphologie riche. Un seul mot peut porter plusieurs suffixes qui changent drastiquement son sens et sa fonction grammaticale. Cela nécessite des approches entièrement différentes de la tokenisation et de l'entraînement des modèles par rapport aux langues indo-européennes. À la complexité morphologique s'ajoute un facteur critique : le volume de données d'entraînement ouvertes en azerbaïdjanais est nettement inférieur à celui de l'anglais, du russe ou de l'espagnol. Les méthodes standard d'entra
Comment Azercell a résolu la tâche?
L'entreprise s'est associée avec le AWS Generative AI Innovation Center. Au cours de six semaines intensives de travail conjoint, des spécialistes des deux côtés ont construit un framework prêt pour la production sur Amazon SageMaker. La solution incluait plusieurs composants clés : une préparation adéquate et un nettoyage des données existantes, une tokenisation spécialisée tenant compte de la morphologie de l'azerbaïdjanais, et une optimisation du processus d'entraînement pour fonctionner avec des volumes de données plus petits. Les ingénieurs ont utilisé le transfer lear
Que sait-on sur Ce qui en a résulté : deux rôles pour le modèle ?
Le modèle d'Azercell fonctionne dans deux directions. Premièrement, il sert de chatbot orienté client qui aide les abonnés à répondre aux questions sur les services et les tarifs en azerbaïdjanais. Deuxièmement, le modèle est utilisé dans les processus commerciaux internes : traitement des demandes entrantes, analyse de la parole dans les centres d'appels, classification des problèmes et recommandations de services personnalisées. La concentration sur l'azerbaïdjanais permet d'éviter la perte de sens lors de la traduction et garantit que le modèle comprend les contextes loc
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.