Habr AI
Fuente de noticias de IA. Los artículos son seleccionados y adaptados por la redacción de Hamidun News.
Últimas publicaciones
Hugging Face y ModelAudit: un estudio muestra los límites de la protección integrada de modelos de ML
Un experimento con modelos de Hugging Face muestra que ModelAudit detecta señales peligrosas adicionales, pero genera mucho ruido y su precisión depende de las versiones de las reglas y del triaje manual.
Visión local para z.ai GLM-5.1: un modelo de 8B cierra el 70% de la brecha con la frontera
Un autor muestra cómo dar «visión» local a un agente de código barato basado en z.ai GLM-5.1 con un servidor MCP y qwen3-vl:8b para que revise la interfaz en capturas.
El Tesoro Federal ruso lanza una supervisión con IA de las obras de proyectos nacionales basada en QMonitoring
El Tesoro Federal ha incorporado QMonitoring para vigilar las 24 horas las obras de proyectos nacionales: la IA analiza vídeo para detectar riesgos, incidentes y retrasos.
Aurora propone un manifiesto de IA duradera, con memoria, identidad y desarrollo
Habr AI publica un manifiesto sobre la «IA duradera»: su autor propone evaluar los sistemas no por benchmarks, sino por su capacidad de conservar identidad, cambiar y reproducirse con el tiempo.
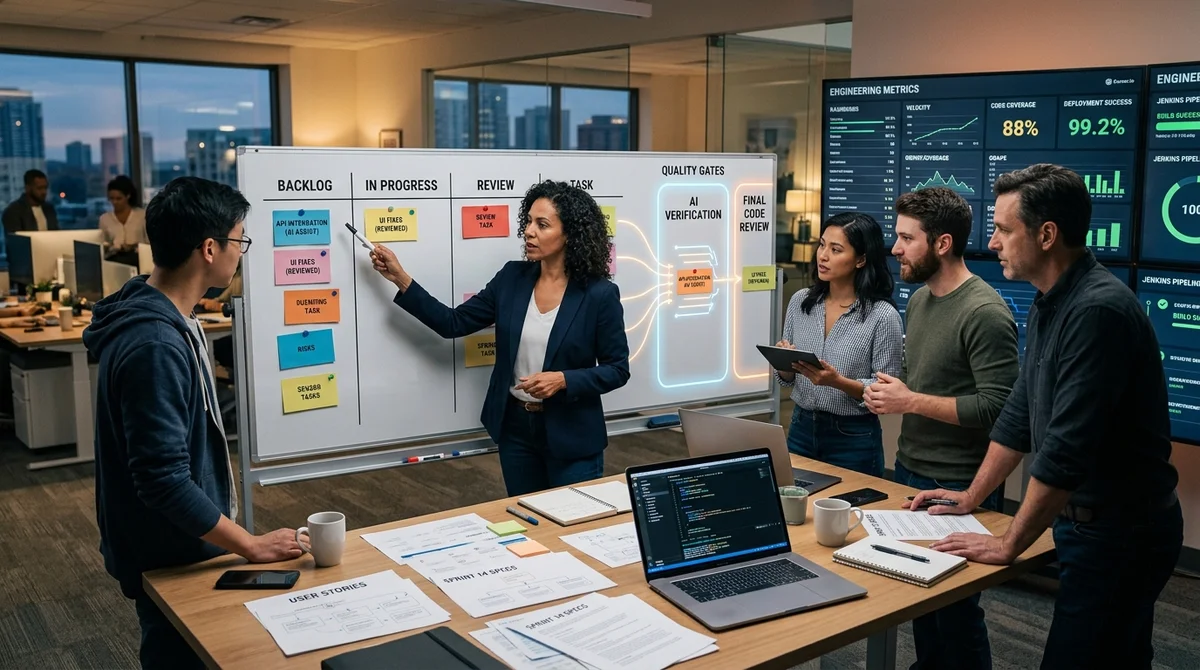
SENAR introduce puertas de calidad para el desarrollo con IA: cómo las especificaciones y las métricas reducen los errores
Habr publica una nueva entrega sobre SENAR: especificaciones obligatorias, puertas de entrada y salida y métricas como FPSR y MIR reducen bugs y correcciones manuales.
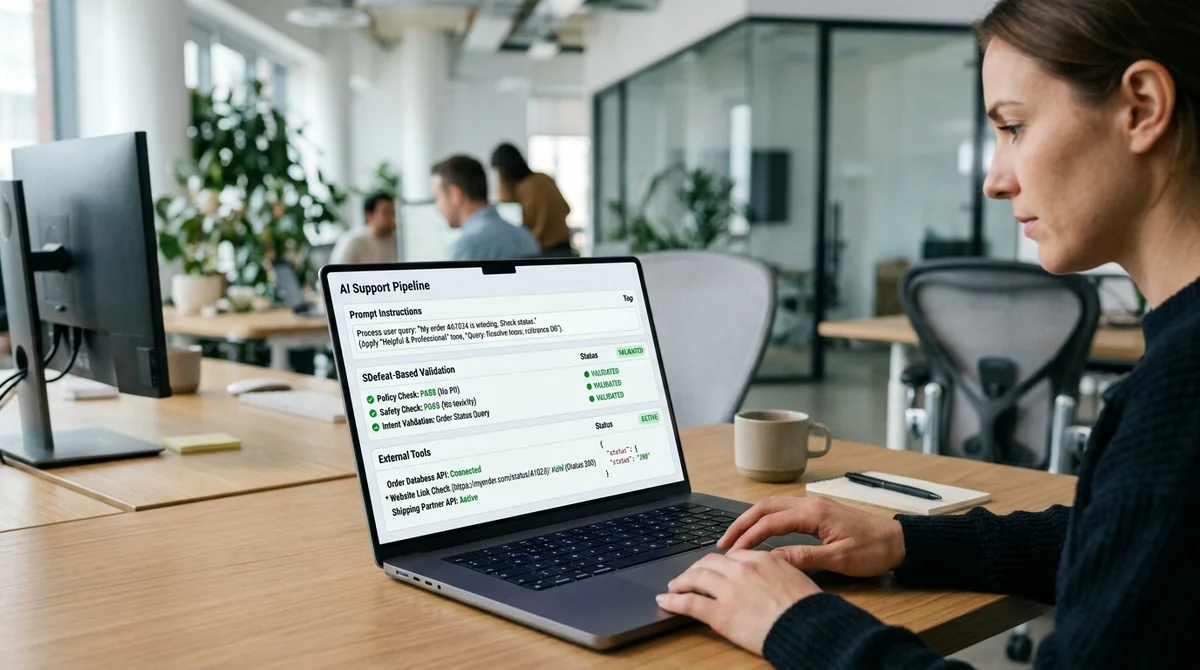
OpenWebUI explica cómo combinar System Prompt, Skills y MCP Tools para verificar enlaces
Un bot de soporte técnico en OpenWebUI muestra por qué separar el prompt de sistema, los Skills y las MCP Tools cuando no basta con generar un enlace, sino que hay que comprobar que realmente abre.
Anthropic cambió el carácter de Claude Opus 4.7 y parte de los desarrolladores ve una regresión
Anthropic prometió con Claude Opus 4.7 un modelo más directo y preciso, pero parte de los desarrolladores se topa con discusiones inútiles, más gasto de tokens y prompts antiguos rotos.
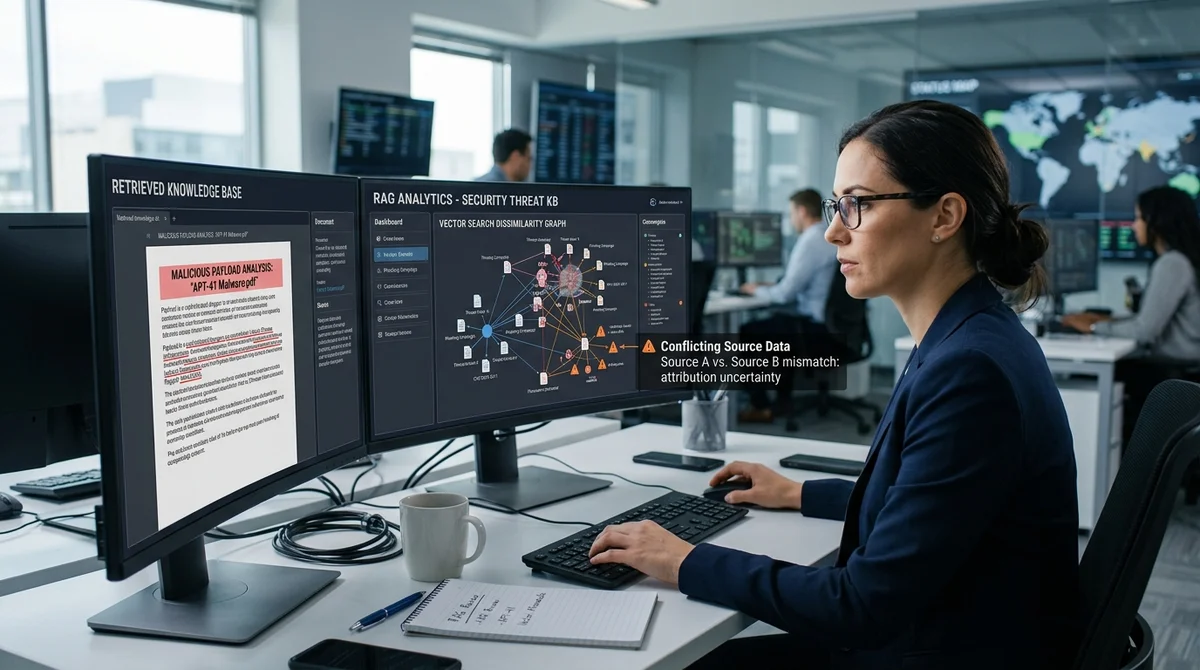
Cómo cinco documentos pueden romper un sistema RAG y convertir la base de conocimiento en un canal de ataque
RAG reduce las alucinaciones, pero el contexto de confianza de la base de conocimiento se convierte en un punto de ataque: bastan unos pocos documentos envenenados para desviar las respuestas del modelo y eludir las defe
Habr AI analiza cómo un solo puerto abierto en una plataforma LLM lleva a claves e infraestructura
Un equipo de auditoría revisó un servicio RAG con decenas de miles de usuarios. Las cadenas de ataque complejas fallaron, pero un puerto abierto dio acceso a claves e infraestructura.
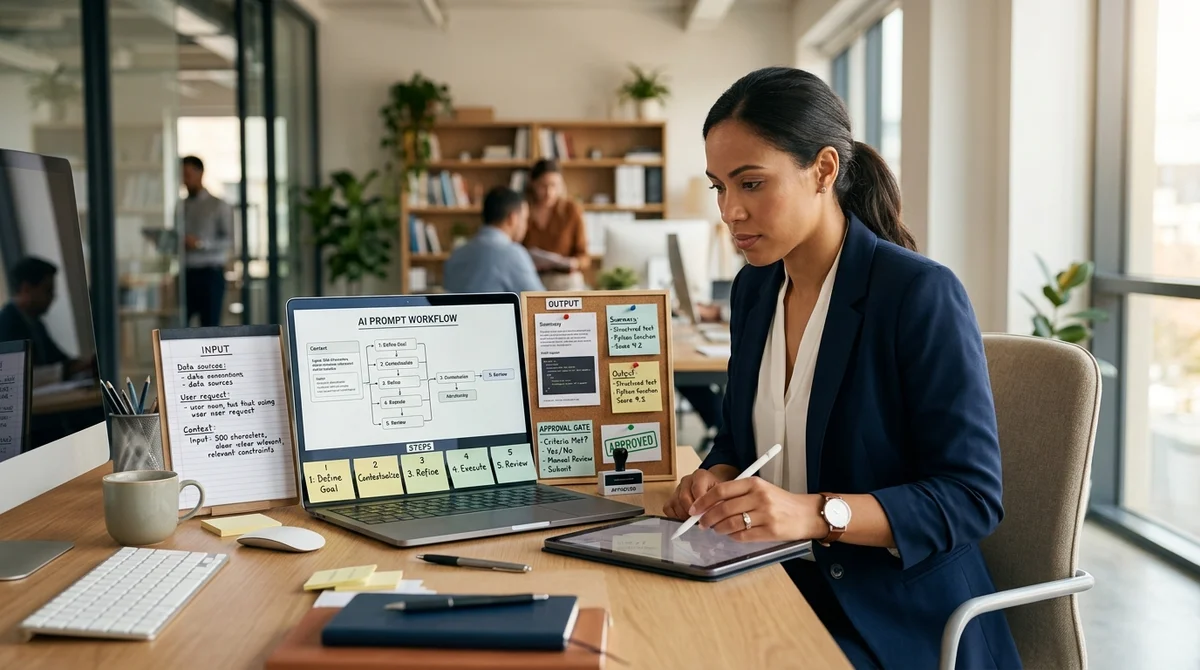
Claude no salva un mal brief: por qué la IA entrega resultados convincentes pero flojos
Con Claude como ejemplo, el autor muestra que la IA acelera más las respuestas verosímiles que los resultados útiles cuando la tarea no se descompone en entrada, etapas, salida y criterios de aceptación.
Cómo un desarrollador ruso pasó días intentando ejecutar Gemini y qué terminó funcionando
Un programador ruso dedicó varios días a poner en marcha Gemini desde Rusia con VPN, probó decenas de opciones y documentó cada paso: qué falló y qué ayudó al final.
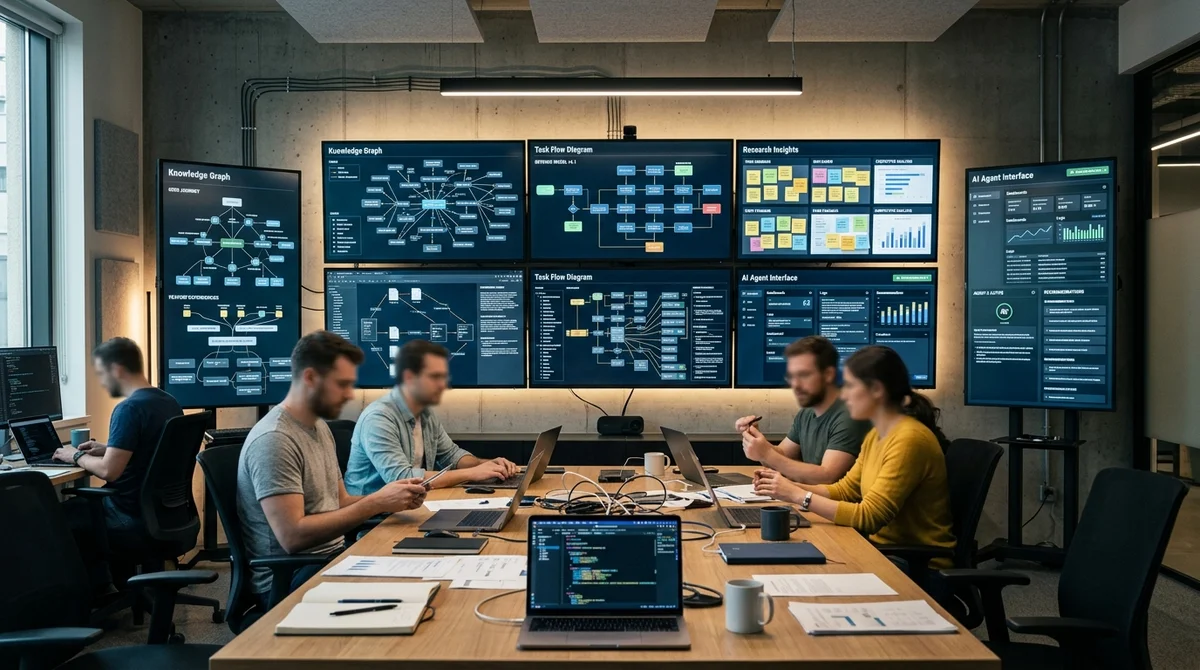
Product Graph y la memoria de los agentes: por qué la IA no salva un producto sin estructura de conocimiento
Un análisis de Product Graph explica por qué incluso los agentes de IA más potentes resultan inútiles sin una memoria común del producto y cómo un conocimiento conectado reduce el caos.
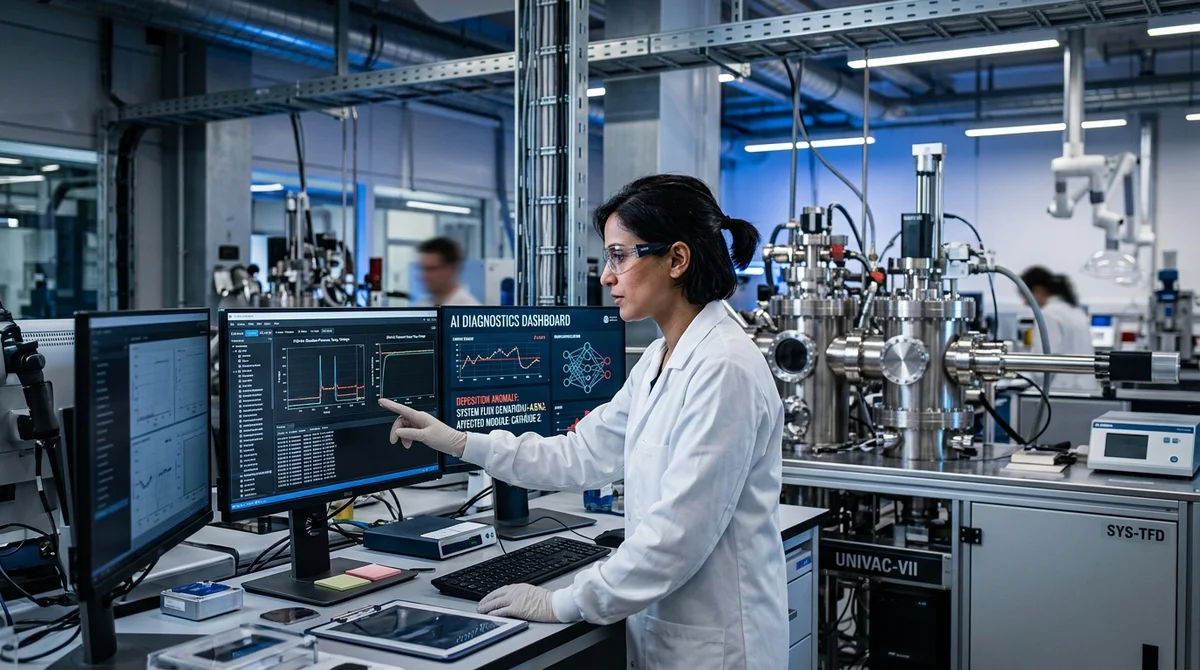
Seis años de laboratorio: de las memorias USB y los cuadernos a una IA que detecta defectos ocultos en los equipos
Un laboratorio tardó seis años en construir su infraestructura digital. El resultado: una IA que lee los registros del proceso de pulverización catódica y detecta defectos ocultos antes de que causen problemas.
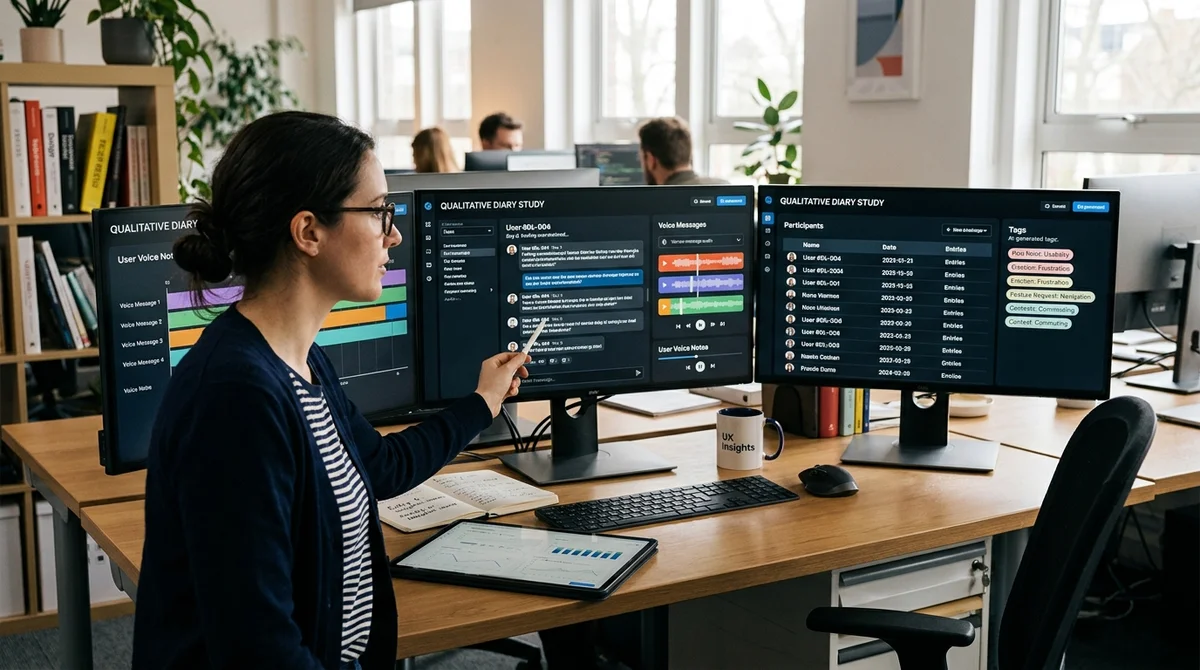
Cómo la IA cambió el estudio de diario: tres concesiones que se dejaron atrás
Un equipo de investigadores UX explica cómo la IA permitió evitar concesiones en muestra, duración y profundidad de análisis, sin recortar el valor del método.
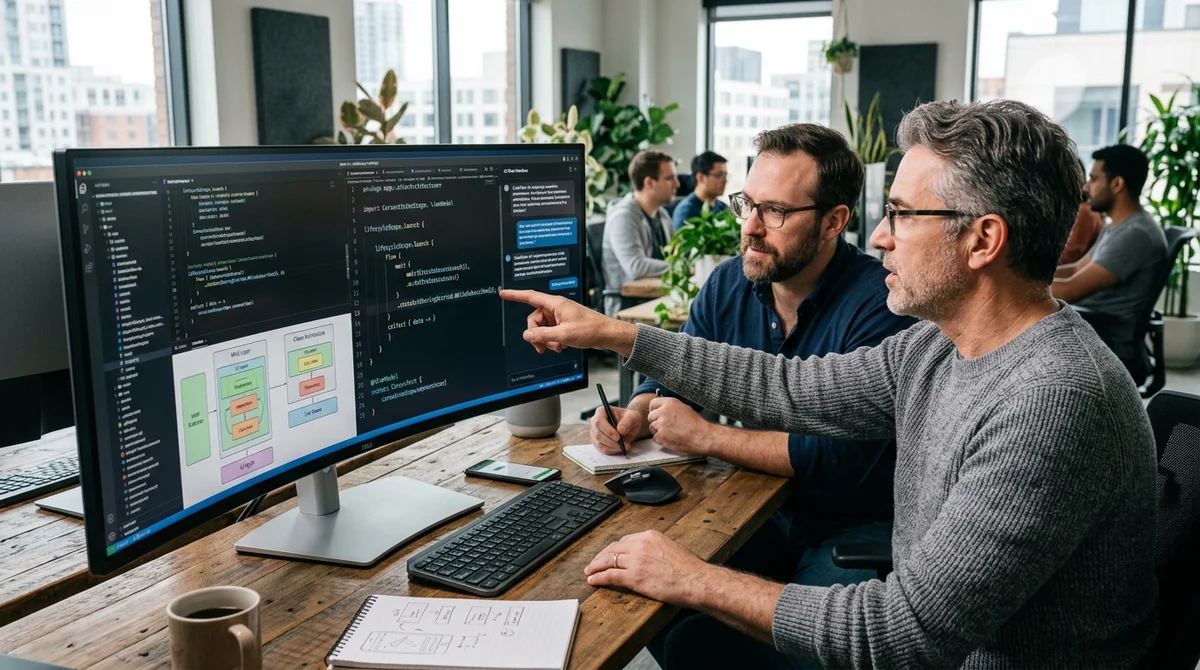
Marcin Moskała auditó GeminiAI: lo que reveló sobre las corrutinas y la arquitectura de Android
El autor del cliente open source GeminiAI cuenta cómo superó la auditoría de Marcin Moskała y por qué los errores en corrutinas fueron la gran prueba de madurez de su arquitectura Android.
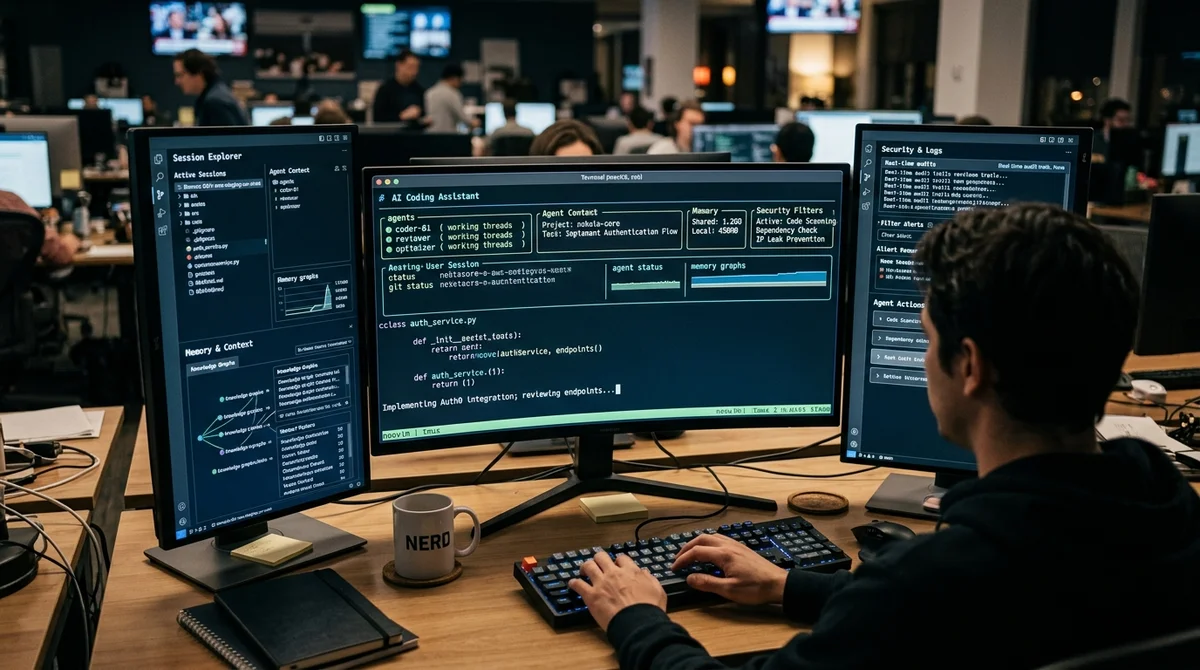
Anthropic: la filtración del código de Claude Code revela una arquitectura de agentes sofisticada
El código filtrado mediante un sourcemap muestra que Claude Code dejó atrás el «CLI de chat» y es una plataforma con subagentes, memoria, modos remotos y una seguridad estricta en la shell.
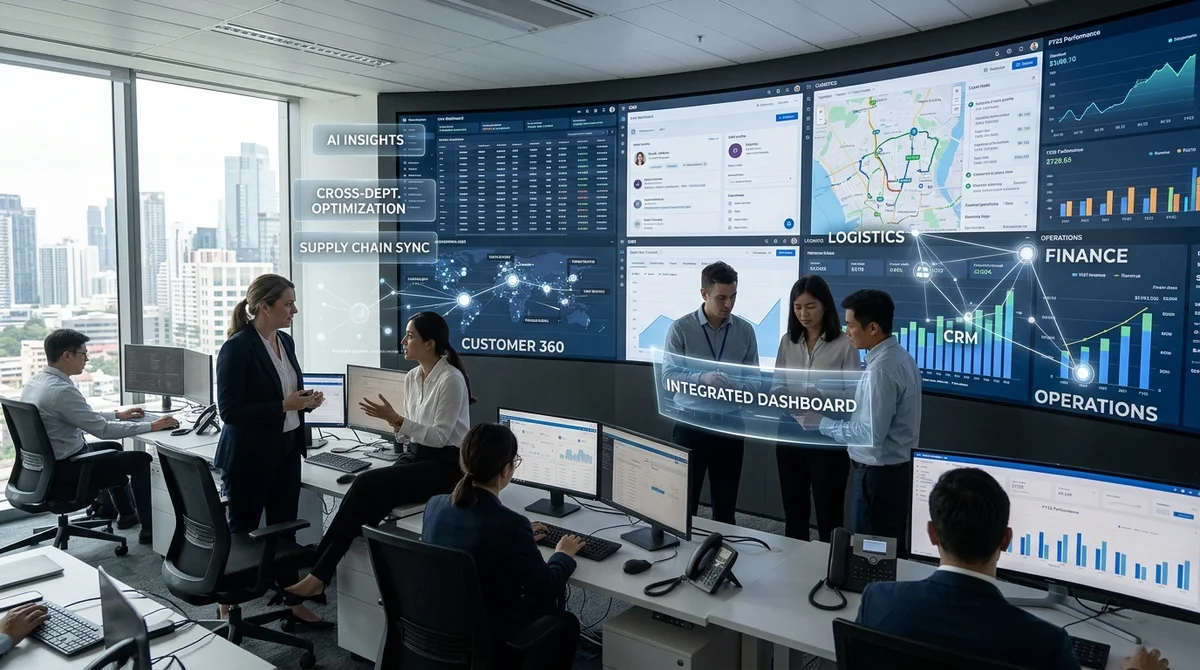
Sber explica por qué las empresas necesitan una capa AI Overlay en lugar de reestructurar sus departamentos
Sber explica por qué la adopción aislada de IA generativa rara vez genera beneficios y propone una capa horizontal AI Overlay sobre procesos, datos y sistemas corporativos.
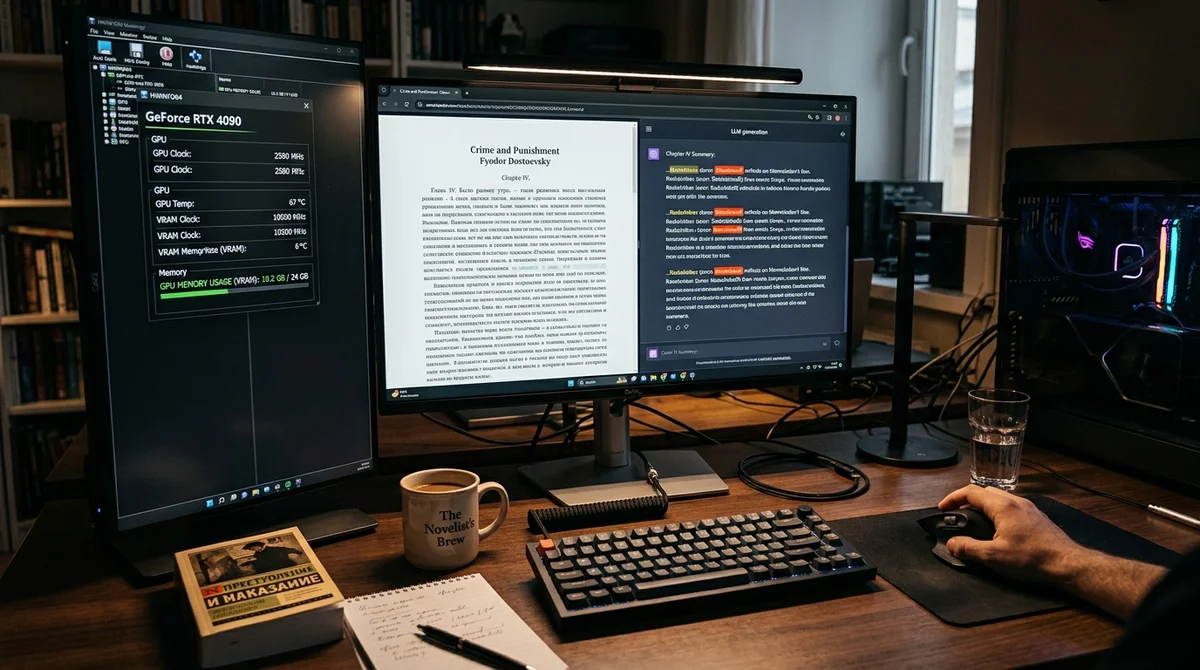
Saiga Llama 3 8B con 10 GB de VRAM: cómo en Habr lograron un 93 % de precisión con «Guerra y paz»
Habr AI muestra cómo ejecutar Saiga Llama 3 8B con 10 GB de VRAM, resumir dos tomos de «Guerra y paz» y reducir las alucinaciones con un prompt estricto y posprocesamiento.
4 patrones de los fundadores no técnicos que impiden que una startup despegue
Un desarrollador de Habr trabajó con varios fundadores no técnicos y describe cuatro patrones que frenan el lanzamiento de startups, y cómo la AI los agrava.
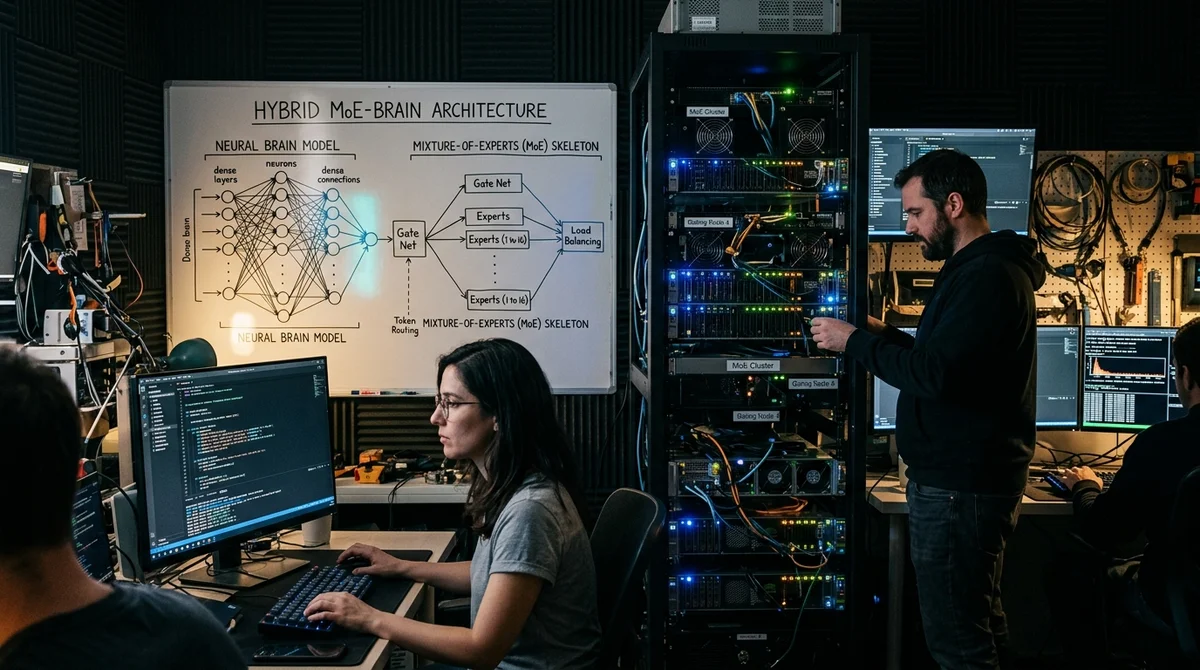
DeepSeek y Gemma: cómo un experimento de LLM híbrido en Kaggle rompió la biblioteca Transformers
Unos aficionados trasplantaron cuatro capas de 31B de Gemma a la arquitectura MoE de DeepSeek sin reentrenar, sortearon los límites de PyTorch y Transformers y arrancaron una quimera de LLM caótica pero funcional.
Google Gemma 4 y Qwen 3.6 encabezan la lista de mejores modelos locales para el hogar en 2026
Una selección de modelos locales de 2026 muestra que una RTX 3060 ya basta para la IA doméstica. Hay que elegir según VRAM, cuantización y tarea.
Yandex Praktikum explica cómo ven las imágenes las CNN y por qué los parámetros no lo son todo
Yandex Praktikum publicó en Habr AI un análisis de cómo las redes convolucionales procesan imágenes, por qué la arquitectura pesa más que el tamaño bruto del modelo y a quién le sirve.
Google presenta TurboQuant, una caché KV de 3 bits para LLM, pero el mercado de memoria se asustó demasiado pronto
Tras el anuncio de TurboQuant, las acciones de los fabricantes de memoria cayeron, pero el efecto esconde límites: no hay código, no hay integración y la disputa científica apenas empieza.
Rutube pasa de un piloto con Whisper a su propia plataforma de subtítulos y reconocimiento de voz
Rutube explica cómo convirtió un piloto rápido con Whisper en una plataforma completa de subtítulos con arquitectura de microservicios y ASR propio, que procesa hasta 1200 vídeos por hora.
Raft explica cómo evaluar agentes de IA antes de ponerlos en procesos de trabajo
Raft publica una guía práctica de evals para agentes de IA: en lugar de intuición y demos puntuales, propone comprobar el resultado, el camino y el coste de los errores.
Veai muestra cómo prueba un agente de IA en los IDE de JetBrains sin depender del modelo
Veai describió su enfoque de automatización de UI para un plugin de JetBrains: separó la interfaz determinista de las respuestas del LLM y redujo los fallos falsos de las pruebas.
Habr AI explica cuándo una empresa necesita sistemas de recomendación y cuándo sobran
Habr AI publica una guía práctica sobre sistemas de recomendación: cuándo bastan reglas simples, cuándo hacen falta modelos de ML y qué métricas deciden si la inversión se amortiza.
Lanzan Tab, un bot antispam para Telegram con red neuronal propia y reentrenamiento
Un desarrollador presenta Tab, un bot antispam gratuito para Telegram: filtra mensajes con su propia red neuronal, se reentrena con las denuncias de los moderadores y ya funciona en chats reales.
SpeShu.AI lanza AI-Profi, un servicio para encontrar especialistas en IA según las tareas de cada empresa
SpeShu.AI presenta AI-Profi: las empresas pueden encontrar en pocos clics especialistas en IA para tareas concretas, en plena escalada de la demanda de habilidades en redes neuronales en Rusia.
Qwen 3.6 Plus supera a DeepSeek V4 Pro en el battle test en ruso y resulta más rentable
En una comparación reciente de seis LLM de abril, Qwen 3.6 Plus obtuvo 92 puntos en contenido en ruso y superó al nuevo DeepSeek V4 Pro, que quedó por debajo y es bastante más caro.