Product Graph y la memoria de los agentes: por qué la IA no salva un producto sin estructura de conocimiento
El autor analiza la mayor debilidad de los equipos de producto AI-first: el conocimiento sobre decisiones, investigaciones y restricciones se dispersa entre personas y documentos. En ese entorno, los agentes de IA no curan el caos, sino que lo aceleran. La salida que se propone es Product Graph, un enfoque en el que las tareas se vinculan con insights, requisitos, decisiones y resultados. Los agentes ayudan a mantener esa memoria en lugar de limitarse a cerrar tickets.
Procesado por IA desde Habr AI; editado por Hamidun News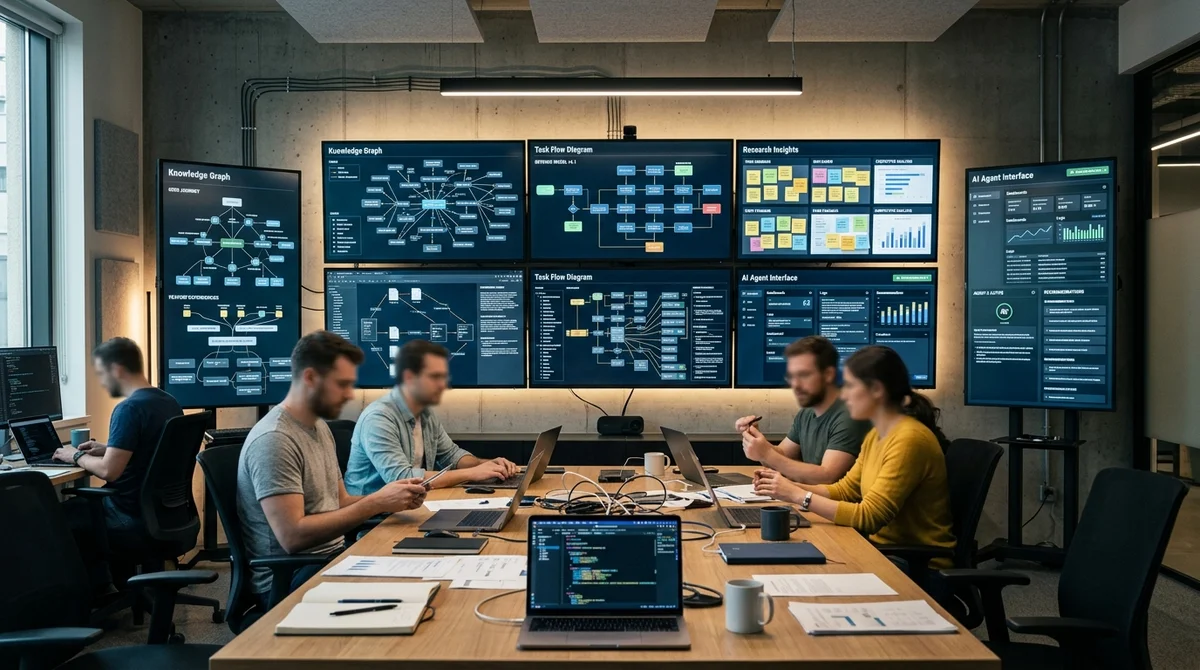
Los agentes de IA ya saben escribir código, actualizar tickets y montar PR, pero eso no resuelve el problema básico de la mayoría de los equipos de producto: la memoria del producto sigue almacenada en fragmentos. Mientras las decisiones, las investigaciones y las restricciones estén repartidas entre reuniones, chats y cabezas de empleados, la automatización acelerará la confusión, no la comprensión.
Dónde se pierde el contexto
Cuando un producto crece, las empresas casi inevitablemente lo dividen en equipos separados. Cada uno tiene su propio backlog, sus métricas y su parte del recorrido del usuario. Desde fuera, el esquema parece racional: menos dependencias, más autonomía, decisiones locales más rápidas.
Pero con la autonomía llega la fragmentación del conocimiento. Un equipo recuerda por qué se cambió el onboarding, otro sabe qué restricciones existen en la facturación y un tercero sabe que los usuarios no entienden el modelo actual de permisos de acceso. Como resultado, la imagen íntegra del producto se rompe en versiones locales de la realidad.
El problema no se reduce a una mala documentación. Aunque un equipo mantenga con cuidado los PRD, las notas de investigación y los decision records, todo sigue siendo un conjunto de artefactos sueltos. Notion, Confluence, Jira y Google Docs guardan bien los fragmentos, pero casi no ayudan a ver las conexiones entre ellos. Un documento registra un hecho, pero por sí solo no crea comprensión.
Por eso las empresas caen con frecuencia en un ciclo repetitivo: vuelven a discutir cuestiones antiguas, repiten investigaciones ya realizadas y toman decisiones sin tener en cuenta restricciones anteriores.
Por qué los agentes no lo arreglan
En este contexto, la tentación de delegar parte del trabajo en agentes parece lógica. Un modelo puede leer una tarea, abrir un repositorio, proponer código, actualizar un ticket y generar en minutos un resultado convincente.
Pero el agente trabaja dentro del mismo entorno de información que el equipo. Si las decisiones pasadas no están registradas en ningún sitio, no las tendrá en cuenta. Si una investigación importante está enterrada en una presentación antigua, el agente no sabrá de ella. Si la estrategia solo existe en la cabeza del directivo, el agente optimizará la ejecución, no el sentido.
La IA no necesariamente reduce el caos.
A veces solo aumenta su capacidad de procesamiento.
Aquí el autor introduce la idea del metatrabajo. No se trata de burocracia por la burocracia, sino de una capa de acciones que convierte eventos dispersos en un sistema de conocimiento. Alguien debe conectar una investigación nueva con un insight antiguo, dejar constancia de en qué datos se basa un requisito y mostrar dónde dos equipos ya avanzan en direcciones distintas. Para los agentes, este puede ser incluso un papel más útil que escribir código desde cero: no sustituir el trabajo de producto, sino mantener la memoria colectiva y devolver al contexto todo lo que el equipo termina olvidando.
Para qué sirve un Product Graph
Como alternativa al habitual enfoque task-first, se propone Product Graph: no un nuevo gestor de tareas, sino un modelo donde el objeto principal no es la tarjeta del tablero, sino el conocimiento conectado. En un sistema así, la tarea importa no por sí misma, sino como eslabón de una cadena: fuente de la señal, insight, decisión, requisito, implementación y resultado. Si esa cadena no se pierde, el equipo puede en cualquier momento retroceder desde un lanzamiento hasta el motivo por el que ese trabajo surgió.
Este enfoque se apoya en varios principios prácticos:
- cada tarea debe tener una fuente clara: una señal de usuarios, una métrica, una investigación o una apuesta estratégica
- la decisión debe existir como un objeto aparte, con alternativas, argumentos y condiciones de revisión
- los nuevos resultados deben volver al sistema y afinar las conclusiones antiguas, en lugar de desaparecer tras el lanzamiento
- las contradicciones entre estrategia, UX, investigación y restricciones técnicas deben hacerse visibles lo antes posible
Si Product Graph funciona de verdad, el agente recibe no solo un ticket, sino un mapa de causas y consecuencias. Entonces puede no solo ejecutar, sino también comprobar la coherencia: recuperar investigaciones olvidadas, detectar supuestos en conflicto, recordar hipótesis sin cerrar y ayudar al equipo a aprender de sus propios resultados. En este modelo, la IA deja de ser un autómata que cierra tareas y pasa a participar en la memoria del producto.
Qué significa
La idea central del texto es sencilla: la IA resulta útil donde el equipo ya tiene una estructura de conocimiento a la que conectar la automatización. Si no existe esa estructura, la velocidad de los agentes solo escala más rápido el viejo problema: la amnesia organizativa.
Por eso, el siguiente paso para los equipos AI-first no es solo implantar agentes, sino construir un sistema en el que decisiones, investigaciones, requisitos y resultados estén conectados entre sí.
- 2 nov 2026El creador de Bun migra 750 mil líneas de Zig a Rust en 11 días con Claude Code
- 2 nov 2026Un periodista de The Verge construye con Claude Code un equivalente del Meta Muse Charm por 50 dólares
- 1 nov 2026Prueba de 16 modelos en 7 buscadores: Exa obtuvo una media de 10,5 puntos de 14; SearXNG, en torno a 3
- 1 nov 2026StreamVibe, el agente de vídeo de Google, supera en un 10,7 % a otros modelos en momento y calidad de respuesta
Preguntas frecuentes sobre la noticia
Dónde se pierde el contexto?
Cuando un producto crece, las empresas casi inevitablemente lo dividen en equipos separados. Cada uno tiene su propio backlog, sus métricas y su parte del recorrido del usuario. Desde fuera, el esquema parece racional: menos dependencias, más autonomía, decisiones locales más rápidas. Pero con la autonomía llega la fragmentación del conocimiento. Un equipo recuerda por qué se cambió el onboarding, otro sabe qué restricciones existen en la facturación y un tercero sabe que los usuarios no entienden el modelo actual de permisos de acceso. Como resultado, la imagen íntegra del
¿Qué se sabe sobre Por qué los agentes no lo arreglan?
En este contexto, la tentación de delegar parte del trabajo en agentes parece lógica. Un modelo puede leer una tarea, abrir un repositorio, proponer código, actualizar un ticket y generar en minutos un resultado convincente. Pero el agente trabaja dentro del mismo entorno de información que el equipo. Si las decisiones pasadas no están registradas en ningún sitio, no las tendrá en cuenta. Si una investigación importante está enterrada en una presentación antigua, el agente no sabrá de ella. Si la estrategia solo existe en la cabeza del directivo, el agente optimizará la eje
¿Qué se sabe sobre Para qué sirve un Product Graph?
Como alternativa al habitual enfoque task-first, se propone Product Graph: no un nuevo gestor de tareas, sino un modelo donde el objeto principal no es la tarjeta del tablero, sino el conocimiento conectado. En un sistema así, la tarea importa no por sí misma, sino como eslabón de una cadena: fuente de la señal, insight, decisión, requisito, implementación y resultado. Si esa cadena no se pierde, el equipo puede en cualquier momento retroceder desde un lanzamiento hasta el motivo por el que ese trabajo surgió. Este enfoque se apoya en varios principios prácticos: cada tarea
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.