Habr AI analiza cómo un solo puerto abierto en una plataforma LLM lleva a claves e infraestructura
La auditoría de una gran plataforma RAG dejó una lección incómoda: los agujeros más peligrosos suelen estar no en los prompts, LangChain o CVE exóticas, sino en la infraestructura básica. Los investigadores dedicaron dos semanas a probar SSRF, inyecciones y deserialización, pero lograron acceso crítico con una petición corriente a un puerto abierto. La conclusión es simple: los servicios de IA no pueden protegerse solo a nivel del modelo. Hace falta un control estricto de la red, los secretos y los servicios internos.
Procesado por IA desde Habr AI; editado por Hamidun News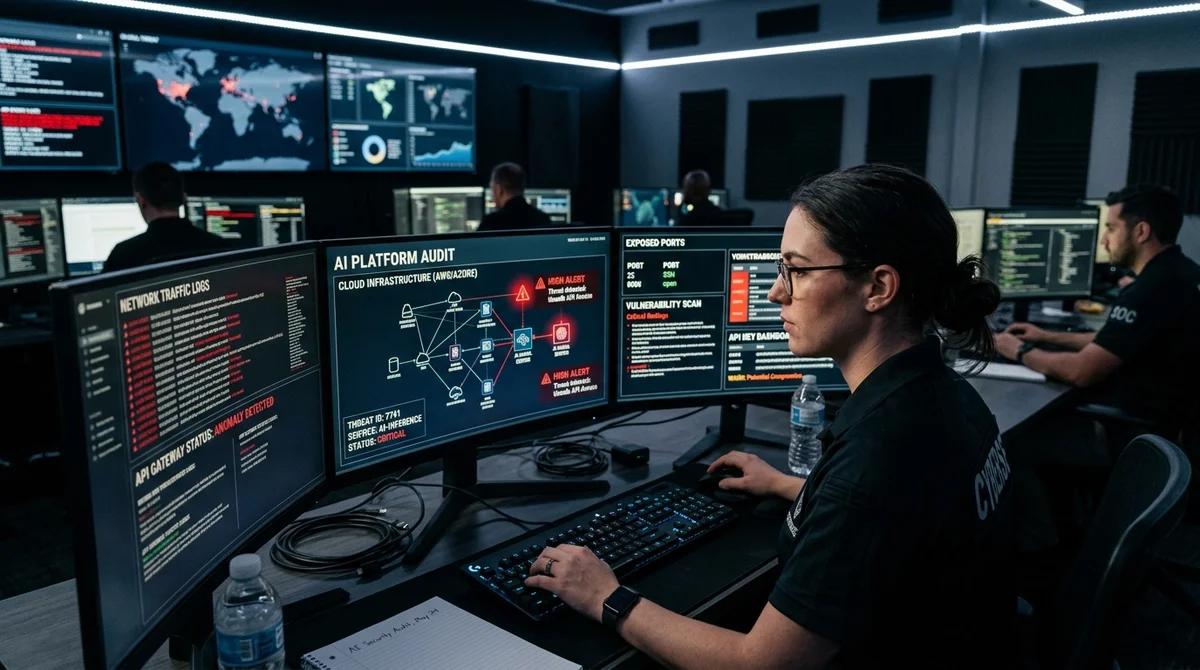
Una historia de la auditoría de una gran plataforma RAG deja una conclusión incómoda para el mercado de la IA: los incidentes más caros suelen empezar no con un ataque «inteligente» al modelo, sino con un error banal de infraestructura. El equipo pasó dos semanas buscando vulnerabilidades sofisticadas, pero al final obtuvo acceso a claves y servicios internos en cuestión de minutos.
Cómo encontraron el acceso
Los auditores probaron un servicio con decenas de miles de usuarios. Primero siguieron la ruta esperable en un stack LLM: comprobaron SSRF combinado con LangChain, probaron inyecciones de prompt, analizaron el manejo de HTTP y buscaron vulnerabilidades de deserialización. La lógica es clara: son los frentes que se suelen discutir cuando se habla de seguridad en RAG, agentes y aplicaciones LLM. Pero ninguna de las cadenas largas dio un resultado funcional. El hallazgo crítico apareció no en la aplicación, sino en una infraestructura mal protegida.
«Hicimos un solo curl a un puerto abierto y obtuvimos todas las claves
en 5 minutos».
Esa frase resume el contraste central del material. Mientras la industria teme ataques exóticos a la orquestación de modelos, en los entornos de producción reales siguen quedando interfaces abiertas por las que se pueden ver configuraciones, variables de entorno de servicio, URL internas y tokens de API externas. Si esos secretos están junto a las claves de producción, comprometer un servicio se convierte rápidamente en comprometer toda la plataforma.
Por qué ocurre
Las plataformas LLM rara vez funcionan como un servidor con un modelo. Normalmente son un conjunto de microservicios: pasarela de API, orquestador de cadenas, base de datos vectorial, almacenamiento de archivos, colas, paneles de administración internos, proveedores de embeddings, registro, monitorización y facturación. Cada componente nuevo añade red, secretos, roles y puntos de integración. Así, un equipo puede tener bien configurada la interfaz de usuario y la autorización básica, pero mal aislados los puertos internos, los paneles de depuración o los contenedores con acceso privilegiado.
El problema se agrava porque las startups de IA suelen pensar en amenazas a nivel del modelo. Hablan mucho de jailbreak, filtración del prompt de sistema, alucinaciones y protección del contexto RAG, pero aplazan la higiene clásica de DevSecOps. Sin embargo, esa higiene determina si un atacante podrá llegar a los secretos, a la infraestructura en la nube o a claves de pago por cientos de miles de dólares. Si un servicio interno escucha en la red sin necesidad y los secretos están disponibles para un proceso «por si acaso», el LLM ya no es el problema principal: solo aumenta el coste de las consecuencias.
Dónde se falla más
El material es útil porque devuelve la conversación sobre la seguridad de los servicios de IA a lo básico de la disciplina de ingeniería. Aunque la aplicación se construya en torno a una cadena compleja de recuperación, agentes y varios modelos, el atacante casi siempre busca el camino más barato. Y ese camino suele pasar por errores viejos y conocidos para cualquier equipo que haya trabajado con infraestructura en la nube y contenedores.
- Puertos y servicios internos abiertos sin ACL estrictas
- Secretos en variables de entorno, logs o configuración accesibles a servicios vecinos
- Permisos excesivos en contenedores, runners y cuentas de servicio
- Falta de segmentación entre la capa RAG, el panel de administración y la infraestructura en la nube
- Foco en la inyección de prompts e ignorancia de la higiene de red
Para el producto, esto significa que una auditoría de seguridad no puede reducirse al red teaming de prompts. Hace falta un inventario de todos los componentes alrededor del modelo: qué servicios quedan expuestos hacia fuera, qué claves están al alcance de cada contenedor, dónde hay interfaces de depuración activas, cómo se limita el tráfico saliente y entrante, y quién tiene acceso a los logs y a las instantáneas del entorno. Sin esto, incluso una buena protección de la capa de aplicación deja la infraestructura vulnerable, y cualquier compromiso pasa de ser un fallo local a un incidente a gran escala con fuga de datos, de presupuesto y de acceso a proveedores.
Qué significa
La conclusión principal es simple: un producto de IA hay que protegerlo no como «magia especial con LLM», sino como una plataforma crítica normal con secretos caros y un gran radio de impacto. Si la infraestructura básica no está cerrada, de nada servirá hablar de ataques sofisticados al modelo: una puerta abierta resulta más importante que toda tu arquitectura de IA.
Preguntas frecuentes sobre la noticia
Cómo encontraron el acceso?
Los auditores probaron un servicio con decenas de miles de usuarios. Primero siguieron la ruta esperable en un stack LLM: comprobaron SSRF combinado con LangChain, probaron inyecciones de prompt, analizaron el manejo de HTTP y buscaron vulnerabilidades de deserialización. La lógica es clara: son los frentes que se suelen discutir cuando se habla de seguridad en RAG, agentes y aplicaciones LLM. Pero ninguna de las cadenas largas dio un resultado funcional. El hallazgo crítico apareció no en la aplicación, sino en una infraestructura mal protegida. «Hicimos un solo curl a un
¿Qué se sabe sobre Por qué ocurre?
Las plataformas LLM rara vez funcionan como un servidor con un modelo. Normalmente son un conjunto de microservicios: pasarela de API, orquestador de cadenas, base de datos vectorial, almacenamiento de archivos, colas, paneles de administración internos, proveedores de embeddings, registro, monitorización y facturación. Cada componente nuevo añade red, secretos, roles y puntos de integración. Así, un equipo puede tener bien configurada la interfaz de usuario y la autorización básica, pero mal aislados los puertos internos, los paneles de depuración o los contenedores con ac
Dónde se falla más?
El material es útil porque devuelve la conversación sobre la seguridad de los servicios de IA a lo básico de la disciplina de ingeniería. Aunque la aplicación se construya en torno a una cadena compleja de recuperación, agentes y varios modelos, el atacante casi siempre busca el camino más barato. Y ese camino suele pasar por errores viejos y conocidos para cualquier equipo que haya trabajado con infraestructura en la nube y contenedores. Puertos y servicios internos abiertos sin ACL estrictas Secretos en variables de entorno, logs o configuración accesibles a servicios vec
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.