DeepSeek y Gemma: cómo un experimento de LLM híbrido en Kaggle rompió la biblioteca Transformers
En Kaggle intentaron algo casi imposible: tomar los pesos de 31B de Gemma, trasplantarlos al armazón MoE de DeepSeek y ejecutar el híbrido sin reentrenamiento. Para lograrlo tuvieron que parchear Transformers, sortear un fallo de inicialización de los pesos de 4 bits y buscar a mano los expertos ocultos. El modelo resultante habla de forma incoherente, pero el experimento muestra hasta dónde se puede llegar con PyTorch, Hugging Face y un puñado de trucos.
Procesado por IA desde Habr AI; editado por Hamidun News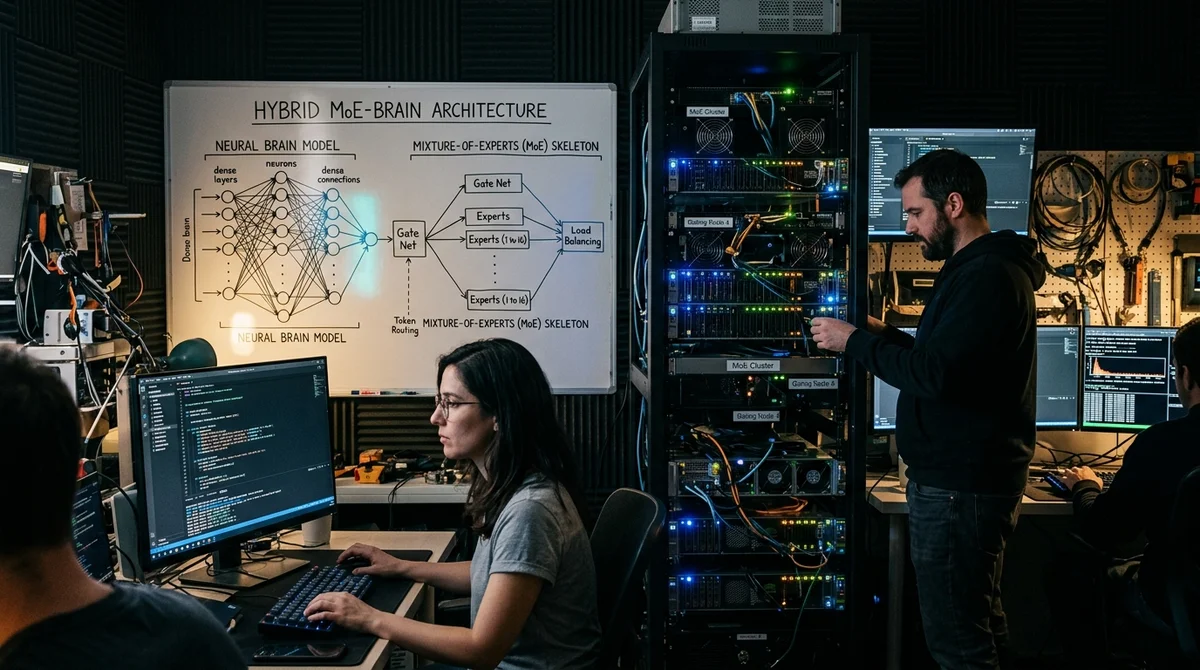
Un grupo de aficionados montó un LLM híbrido casi contra las reglas: tomaron cuatro capas del modelo Gemma de 31B y las integraron en una arquitectura MoE vacía de DeepSeek-V4, sin reentrenamiento. No salió de ahí un competidor funcional de ChatGPT, pero el proceso mostró hasta qué punto se pueden forzar PyTorch y Transformers para probar una idea extrema.
Por qué un híbrido
La idea nació de restricciones muy duras: dos GPU T4 gratuitas en Kaggle, unos 30 GB de RAM y ningún presupuesto para un fine-tuning completo. En lugar de entrenar, los autores decidieron probar un escenario más tosco: el empalme estructural de modelos. Como donante actuó Gemma-4-31B, comprimida al formato NF4 de 4 bits, y como «esqueleto», un DeepSeek-V4 vacío con un enrutador Mixture-of-Experts. La tarea sonaba casi a meme: trasplantar parte de los pesos de una arquitectura a otra y ver si la quimera llegaba a cobrar vida.
Desde el punto de vista de la ingeniería, el proyecto interesaba no por la calidad de las respuestas, sino por el hecho mismo de la compatibilidad. Gemma y DeepSeek tienen dimensiones distintas, su propia lógica de normalización, bloques de attention diferentes y reglas propias para enrutar tokens entre expertos. Los manuales suelen considerar imposible un trasplante así sin proyecciones intermedias y reentrenamiento. Los autores rompieron deliberadamente esa regla y plantearon un experimento de supervivencia para las bibliotecas: qué fallaría primero, el modelo, la memoria de Kaggle o la propia pila de Hugging Face.
Dónde se vino todo abajo
El primer fallo llegó ya en la carga. Transformers se negó a reconocer correctamente el tipo personalizado gemma4 y después se estrelló con el error dict.to_dict(), porque un módulo interno serializaba la configuración como un diccionario normal e inmediatamente intentaba tratarlo como un objeto. Para avanzar, los autores registraron el tipo a mano en CONFIG_MAPPING y añadieron un monkey patch para GenerationConfig que envuelve el diccionario en un objeto proxy al vuelo. Sin él, toda la operación terminaba antes de crear el híbrido.
Luego, la biblioteca intentó inicializar con ruido aleatorio las zonas vacías de DeepSeek llamando a normal_. Aquí PyTorch lanzó un NotImplementedError: los pesos del donante se habían cargado con bitsandbytes en 4 bits y se almacenaban como uint8, mientras que el generador de distribución normal trabaja con tensores float. El problema se resolvió de la forma más directa: interceptaron TORCH_INIT_FUNCTIONS["normal_"] y le prohibieron tocar tensores de bytes. No es un arreglo elegante, sino un rodeo quirúrgico, pero sin él el trasplante ni siquiera arrancaba.
Lo más ingrato fueron los expertos de DeepSeek y la memoria. Los bloques MoE no estaban en un ModuleList corriente, sino dentro de una clase personalizada que no se puede recorrer simplemente con un bucle. Además, desempaquetar una capa de 31B de Gemma en la RAM de Kaggle provocaba un OOM casi instantáneo. Para esquivarlo, los autores escribieron un «sonar» recursivo que busca las subcapas necesarias por los atributos gate_proj, up_proj y down_proj, y transfirieron los pesos en microlotes a través de la CPU, repartiendo los modelos entre dos GPU y llamando constantemente al recolector de basura.
«En el aprendizaje automático no hay muros de arquitectura infranqueables».
Cómo se cosió el modelo
El script final redujo toda la operación a una secuencia de parches rígidos y copias de pesos. Para cada una de las cuatro capas, ajustaba las matrices al tamaño de la capa de destino, rellenándolas con ceros cuando hacía falta, trasplantaba por separado las proyecciones de attention y, también por separado, los componentes MLP de cada experto encontrado. Tras cada copia importante se limpiaba la memoria de inmediato. Después del trasplante, los autores tuvieron además que reescribir el enrutador MoE para que, durante la inferencia, el modelo no fallara por conflictos de dimensiones y pudiera generar al menos algo de texto.
Los pasos técnicos clave fueron estos:
- Registro de la configuración personalizada de Gemma en el registro global de Transformers
- Monkey patch para
GenerationConfigque sobrevive al errordict.to_dict() - Bloqueo de
normal_para pesosuint8de 4 bits - Búsqueda recursiva de expertos y transferencia de matrices en microlotes a través de la CPU
La prueba de la quimera dio el resultado esperado: el modelo arrancó, pero generó texto incoherente, una mezcla de tokens aleatorios y fragmentos de frases. Para los autores, aun así, fue un éxito, porque el objetivo no era la calidad de las respuestas, sino demostrar el principio. No armonizaron los vocabularios, no entrenaron proyecciones de transición ni hicieron fine-tuning tras el trasplante, así que un flujo caótico de tokens a la salida era casi inevitable. Aun así, el experimento demostró que los límites arquitectónicos suelen ser no un muro, sino una larga lista de problemas de bajo nivel que se pueden sortear con código.
Qué significa
Estos experimentos no crean un producto terminado, pero muestran bien los límites de los LLM open source actuales. Si pesos, cuantización, enrutamiento y hidden states se pueden acoplar al menos en parte sin reentrenar, se abre el camino a híbridos más prácticos, con proyecciones adecuadas, adaptación del vocabulario y ajuste posterior. Para los desarrolladores es una señal: la pila que rodea a los modelos sigue siendo frágil, y por tanto el espacio para ensamblajes poco convencionales no deja de crecer.
- 18 nov 2026Sciforium acelera DeepSeek-V4.1-Flash en AMD hasta 1 129 tokens por segundo
- 18 nov 2026Una sola coma china hizo que DeepSeek respondiera en chino en el 94% de los casos
- 18 nov 2026Una IA encuentra una vulnerabilidad desconocida en V8 por $4,24 y en 13 minutos; en febrero no la halló con $350
- 18 nov 2026Agentes de IA publicaron 228 releases de un juego sin revisión humana; los tests devolvieron el 25% de las tareas
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Por qué un híbrido?
La idea nació de restricciones muy duras: dos GPU T4 gratuitas en Kaggle, unos 30 GB de RAM y ningún presupuesto para un fine-tuning completo. En lugar de entrenar, los autores decidieron probar un escenario más tosco: el empalme estructural de modelos. Como donante actuó Gemma-4-31B, comprimida al formato NF4 de 4 bits, y como «esqueleto», un DeepSeek-V4 vacío con un enrutador Mixture-of-Experts.
Dónde se vino todo abajo?
El primer fallo llegó ya en la carga. Transformers se negó a reconocer correctamente el tipo personalizado gemma4 y después se estrelló con el error dict.to_dict(), porque un módulo interno serializaba la configuración como un diccionario normal e inmediatamente intentaba tratarlo como un objeto. Para avanzar, los autores registraron el tipo a mano en CONFIG_MAPPING y añadieron un monkey patch para GenerationConfig que envuelve el diccionario en un objeto proxy al vuelo.
Cómo se cosió el modelo?
El script final redujo toda la operación a una secuencia de parches rígidos y copias de pesos. Para cada una de las cuatro capas, ajustaba las matrices al tamaño de la capa de destino, rellenándolas con ceros cuando hacía falta, trasplantaba por separado las proyecciones de attention y, también por separado, los componentes MLP de cada experto encontrado. Tras cada copia importante se limpiaba la memoria de inmediato.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.