Google Gemma 4, NVIDIA y OpenClaw: agentes de IA locales sin pagar por cada token
Google, junto con NVIDIA, promueve Gemma 4 como base para agentes de IA locales. Los modelos pueden ejecutarse en Jetson Orin Nano, PC con RTX y DGX Spark, y su combinación con OpenClaw elimina la principal barrera de los escenarios siempre activos: el gasto constante en API. Un matiz importante: para datos corporativos y sensibles, NVIDIA promueve por separado NemoClaw, con restricciones de sandbox y políticas de acceso.
Procesado por IA desde MarkTechPost; editado por Hamidun News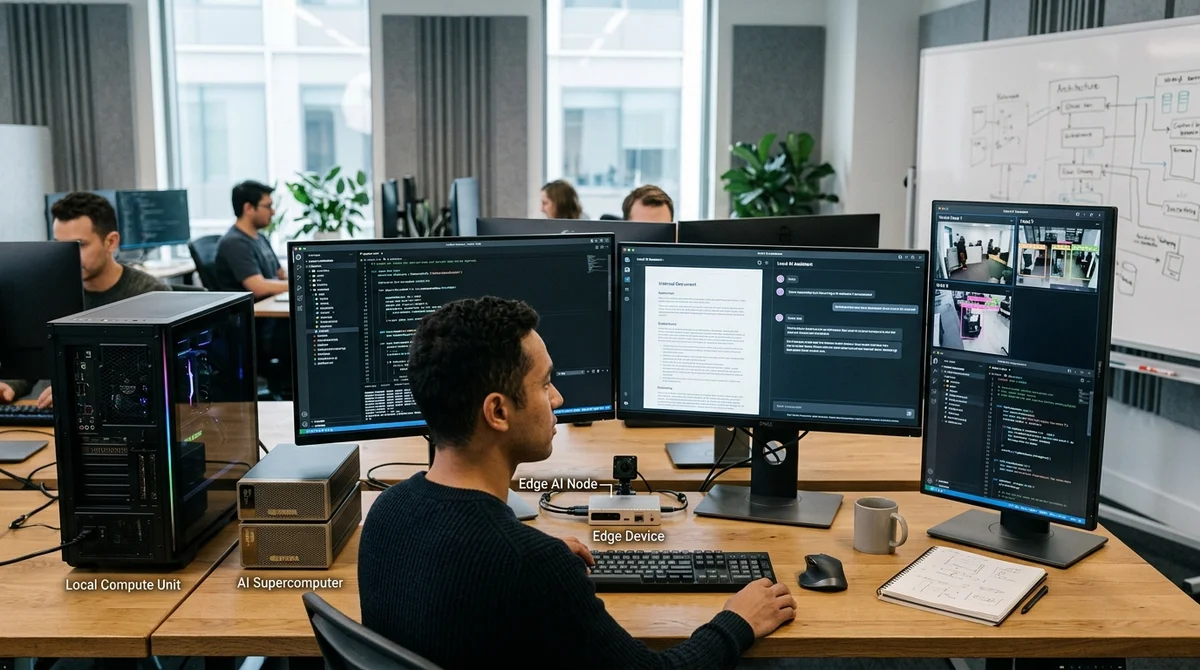
La idea es sencilla: si un agente de IA debe funcionar de forma permanente, ver la pantalla, leer archivos locales, analizar documentos y lanzar acciones en segundo plano, un modelo que se paga por token a través de una API en la nube se convierte muy rápido en un servicio caro. Google, NVIDIA y el ecosistema de OpenClaw proponen otro camino: mantener el modelo junto a los datos, ejecutarlo en hardware local y eliminar así no solo la latencia, sino la propia lógica de «pagar por cada paso» del agente.
Por «impuesto de tokens» no se entiende aquí el gasto puntual de un chatbot, sino el efecto acumulativo de los asistentes siempre activos. Estos sistemas leen contexto de forma continua: conversaciones, ventanas de aplicaciones, código, documentos, calendario, carpetas y notificaciones. Si cada observación, cada razonamiento intermedio y cada acción pasan por un modelo en la nube, el coste se vuelve rápidamente impredecible. En un asistente personal, esto afecta al presupuesto; en un escenario corporativo, añade además un problema de privacidad, porque hay que enviar datos sensibles al exterior con regularidad. Por eso la ejecución local importa aquí no por ideología, sino como necesidad económica y operativa.
La familia Google Gemma 4, presentada el 2 de abril de 2026, tiene un papel clave en este esquema. Google lanzó cuatro variantes: E2B, E4B, 26B y 31B. Los modelos pequeños están pensados para dispositivos edge y escenarios móviles; los grandes, para razonamiento, código y flujos de trabajo agénticos en estaciones de trabajo.
El 26B usa una arquitectura Mixture of Experts y durante la inferencia activa solo 3800 millones de parámetros. Gemma 4 incluye soporte nativo de function calling, salida JSON estructurada e instrucciones de sistema, es decir, todo lo necesario para un agente fiable que use herramientas. Todos los modelos trabajan con imágenes y vídeo, y E2B y E4B admiten además entrada de audio nativa.
La ventana de contexto llega a 128K tokens en los modelos edge y a 256K en los mayores.
Según Google, a 2 de abril de 2026 la versión 31B ocupaba el tercer puesto entre los modelos abiertos en Arena AI y la 26B el sexto, y la compañía subraya que la serie supera a modelos bastante más grandes. También es relevante que Gemma 4 se distribuye bajo licencia Apache 2.0 y que, en el momento del lanzamiento, la familia Gemma había acumulado más de 400 millones de descargas y más de 100 000 variantes en el ecosistema.
La segunda mitad de la historia es el hardware y la pila de ejecución. NVIDIA presenta Gemma 4 como una gama que escala desde Jetson Orin Nano hasta GeForce RTX, RTX Pro y DGX Spark casi sin cambiar de enfoque. Para escenarios edge, Jetson Orin Nano admite E2B y E4B, lo que permite construir sistemas autónomos de visión y voz con baja latencia directamente en el dispositivo.
Para estaciones de trabajo locales y asistentes personales, el foco pasa a 26B y 31B, que pueden ejecutarse con Ollama, llama.cpp, vLLM y Unsloth. DGX Spark es especialmente importante: NVIDIA destaca la configuración con el GB10 Grace Blackwell Superchip y 128 GB de memoria unificada como un punto de entrada cómodo para prototipado local, ajuste fino y ejecución de modelos grandes sin la nube.
En este modo, OpenClaw deja de ser una «envoltura de una API remota» y se convierte en un agente realmente local, que toma contexto de archivos, aplicaciones y flujos de trabajo en la propia máquina del usuario.
El propio OpenClaw hace que esta historia sea comprensible en la práctica. Es un agente local-first que puede vivir de forma permanente en el ordenador, conectarse a mensajeros, recordar el estado de las tareas y llamar a herramientas. Para él, un modelo local no es un extra agradable, sino la condición básica para una economía razonable. Si el agente debe leer un código base todo el día, vigilar proyectos, responder en chats o analizar documentos financieros, la tarificación por token en la nube se convierte en la principal limitación.
Sin embargo, que sea local no resuelve por sí solo la seguridad: un agente con acceso a archivos, red y cuentas sigue siendo una entidad de riesgo. Por eso NVIDIA promueve en paralelo NemoClaw, una pila abierta con OpenShell y guardarraíles basados en políticas, que debe limitar el comportamiento de los agentes siempre activos, aislar su ejecución en un sandbox y mantener los datos sensibles dentro del perímetro local.
En la práctica, esto supone un cambio en el propio modelo de consumo de IA. Ya no se trata solo de lo inteligente que sea un modelo en las pruebas, sino de si se puede mantener encendido todo el día sin temer por la factura, la latencia o la fuga de datos. La combinación de Gemma 4, NVIDIA RTX o DGX Spark y OpenClaw muestra que el mercado avanza hacia agentes personales y corporativos que trabajan más cerca de los datos y del usuario.
La nube no va a desaparecer, pero para asistentes siempre activos, código local, gestión documental, robótica y archivos sensibles, la inferencia local deja de ser una opción de nicho y pasa a ser la arquitectura base.
- 1 nov 2026Prueba de 16 modelos en 7 buscadores: Exa obtuvo una media de 10,5 puntos de 14; SearXNG, en torno a 3
- 1 nov 2026StreamVibe, el agente de vídeo de Google, supera en un 10,7 % a otros modelos en momento y calidad de respuesta
- 1 nov 2026OpenAI reescribe las reglas de comportamiento de GPT: cinco valores y una cadena de prioridades
- 1 nov 2026Los bots de voz con LLM recurren al clasificador rápido Jev: decisiones en 200–500 ms
Build & Ship Production AI Agents Without Boilerplate Code
Start your free 72-hour trial at Hamidun Academy (academy.hamidun.com) — interactive lessons on Claude Code & Cursor, live Tech Radar, and production agent templates.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.