NVIDIA muestra Gemma 4 con voz y webcam funcionando en una Jetson Orin Nano Super
NVIDIA ha montado una demo local de Gemma 4 para la Jetson Orin Nano Super. El modelo escucha la voz del usuario, recurre por su cuenta a la webcam cuando lo necesita y responde mediante TTS. El sistema combina Parakeet para el reconocimiento de voz, Kokoro para la síntesis y llama.cpp con vision projector. Lo más relevante es que un agente multimodal funciona en una placa compacta con 8 GB de memoria sin depender obligatoriamente de la nube.
Procesado por IA desde Hugging Face Blog; editado por Hamidun News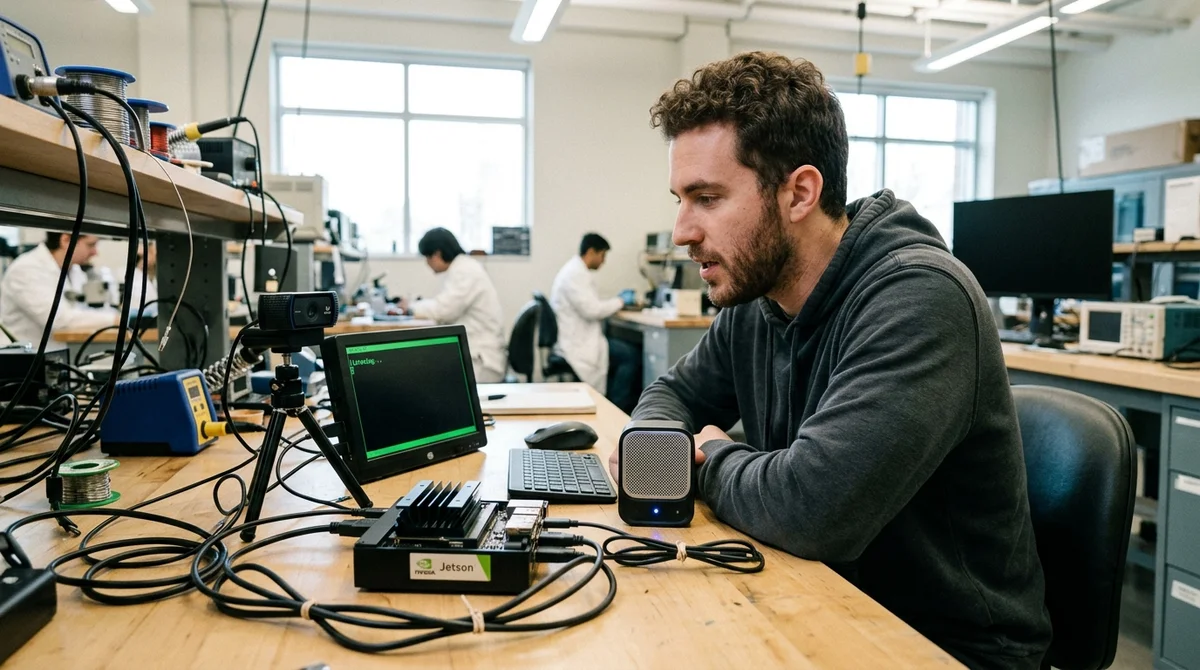
NVIDIA ha mostrado una demo práctica de edge: Gemma 4 escucha una pregunta, recurre por su cuenta a la webcam cuando lo necesita y responde por voz, todo en local en una Jetson Orin Nano Super con 8 GB de memoria. La publicación, del 22 de abril de 2026, tiene interés por el tutorial en sí y, sobre todo, porque el agente multimodal se ejecuta en una placa compacta y no en la nube.
Cómo funciona el sistema
El escenario está planteado como un agente de voz sencillo con una única herramienta visual. El usuario pulsa la barra espaciadora y formula una pregunta en voz alta. Parakeet convierte la voz en texto en local. Después, Gemma 4 recibe la consulta y decide por sí misma si necesita mirar a través de la webcam. Si es así, el script captura un fotograma y se lo pasa al modelo; la respuesta se reproduce luego con Kokoro TTS. El artículo subraya que el modelo no describe la imagen en general, sino que usa lo que ve solo para responder a la pregunta concreta.
«Sinceramente, ya impresiona que esto funcione en una
Jetson Orin Nano».
La clave es que no hay disparadores rígidos ni lógica manual del tipo «si la pregunta contiene la palabra camera». El script expone a Gemma 4 exactamente una herramienta, `look_and_answer`, que toma una foto y analiza la escena. Es el modelo quien decide si la invoca o no. Para ello, NVIDIA utiliza `llama-server` de `llama.cpp` con el flag `--jinja`, que activa el soporte nativo de tool calling. En la práctica, se trata de un escenario VLA compacto en el que la visión solo entra en juego cuando de verdad hace falta.
Qué se necesita para ejecutarlo
La demo no es magia lista para usar: es más bien una guía bien armada para entusiastas y desarrolladores que quieran replicar un pipeline multimodal local por su cuenta. NVIDIA no se limita a explicar cómo lanzar el script de Python: describe todo el stack, desde los paquetes del sistema y la compilación de `llama.cpp` hasta la configuración del audio y la cámara y la descarga del vision projector para Gemma 4.
- Jetson Orin Nano Super con 8 GB de memoria, webcam, micrófono USB o cámara con micrófono integrado, altavoces USB y teclado
- Entorno de Python con `opencv-python-headless`, `onnx_asr`, `kokoro-onnx`, `soundfile`, `huggingface-hub` y `numpy`
- `llama.cpp` compilado en local con CUDA, el modelo `gemma-4-E2B-it` en GGUF y un archivo `mmproj` aparte, sin el cual Gemma 4 no podrá ver
- Configuración de `MIC_DEVICE`, `SPK_DEVICE`, `WEBCAM` y `VOICE`; después, la demo se lanza con un solo comando: `python3 Gemma4_vla.py`
- Un modo de solo texto independiente mediante Docker, por si se quiere probar rápidamente la parte del LLM sin la configuración visual completa
La memoria recibe una atención especial. La placa de 8 GB da la talla, pero el autor recomienda expresamente liberar RAM, desactivar procesos innecesarios e incluso añadir swap para evitar un OOM al cargar el modelo. La opción base es la cuantización `Q4_K_M`, y con restricciones muy severas se puede bajar a `Q3`. Es un detalle importante: no hablamos de un producto de consumo pulido, sino de una receta funcional en la que cada gigabyte influye de verdad en el resultado.
Por qué es interesante
La noticia no es que Gemma 4 pueda ejecutarse en una Jetson; eso ya era de esperar con las versiones ligeras. Lo importante es que NVIDIA presenta una plantilla práctica de agente multimodal local que combina STT, LLM, tool calling, visión y TTS sin necesidad de recurrir a la nube. Para los dispositivos edge es una señal potente. Hasta ahora, este tipo de escenarios se asociaba más a menudo con un servidor o con demos muy recortadas en las que el modelo se limita a responder texto.
Aun así, la guía muestra con honestidad sus limitaciones. El primer arranque es lento, porque hay que descargar los modelos y generar los archivos de voz. El modo VLA completo exige una compilación nativa y el vision projector, mientras que la variante con Docker solo sirve para texto. Si al servidor le falta memoria, hay que limpiar el sistema a mano. NVIDIA tampoco incluye en el artículo benchmarks de velocidad ni muestra vídeos con la latencia real, así que todavía queda lejos un asistente listo para cualquiera. Pero como demostración de hacia dónde va el sector, es un caso muy sólido.
Qué significa
Los agentes de AI locales se acercan al uso práctico en hardware asequible. Para los desarrolladores, esto abre la posibilidad de crear interfaces de voz privadas y prototipos multimodales sin depender obligatoriamente de una infraestructura en la nube. Para el mercado del edge AI, es un paso más desde las presentaciones vistosas hacia sistemas que realmente se pueden montar sobre la mesa, probar e integrar en un producto.
- 1 nov 2026Los modelos locales pierden ante Opus y Codex: 0,21 puntos en un MacBook frente a 1,00 de Codex
- 1 nov 2026Un autor de Habr ajusta YOLOv8l con radiografías dentales y lleva el mAP50 a 0,642
- 1 nov 2026Los bots de voz con LLM recurren al clasificador rápido Jev: decisiones en 200–500 ms
- 1 nov 2026La capa de seguridad MoneyGate frenó las 42 peticiones fraudulentas a IA locales
Preguntas frecuentes sobre la noticia
Cómo funciona el sistema?
El escenario está planteado como un agente de voz sencillo con una única herramienta visual. El usuario pulsa la barra espaciadora y formula una pregunta en voz alta. Parakeet convierte la voz en texto en local. Después, Gemma 4 recibe la consulta y decide por sí misma si necesita mirar a través de la webcam. Si es así, el script captura un fotograma y se lo pasa al modelo; la respuesta se reproduce luego con Kokoro TTS. El artículo subraya que el modelo no describe la imagen en general, sino que usa lo que ve solo para responder a la pregunta concreta. «Sinceramente, ya im
¿Qué se sabe sobre Qué se necesita para ejecutarlo?
La demo no es magia lista para usar: es más bien una guía bien armada para entusiastas y desarrolladores que quieran replicar un pipeline multimodal local por su cuenta. NVIDIA no se limita a explicar cómo lanzar el script de Python: describe todo el stack, desde los paquetes del sistema y la compilación de `llama.cpp` hasta la configuración del audio y la cámara y la descarga del vision projector para Gemma 4. Jetson Orin Nano Super con 8 GB de memoria, webcam, micrófono USB o cámara con micrófono integrado, altavoces USB y teclado Entorno de Python con `opencv-python-head
¿Qué se sabe sobre Por qué es interesante?
La noticia no es que Gemma 4 pueda ejecutarse en una Jetson; eso ya era de esperar con las versiones ligeras. Lo importante es que NVIDIA presenta una plantilla práctica de agente multimodal local que combina STT, LLM, tool calling, visión y TTS sin necesidad de recurrir a la nube. Para los dispositivos edge es una señal potente. Hasta ahora, este tipo de escenarios se asociaba más a menudo con un servidor o con demos muy recortadas en las que el modelo se limita a responder texto. Aun así, la guía muestra con honestidad sus limitaciones. El primer arranque es lento, porque
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.