Together AI Blog
مصدر أخبار الذكاء الاصطناعي. تُختار المقالات وتُعدَّل من قِبَل تحرير Hamidun News.
أحدث المنشورات

شركة Together AI تطلق خدمة Post-Training: تدريب بالتعزيز (RL) وضبط دقيق (SFT) على شريحة B200 مقابل $9 لكل ساعة GPU
أطلقت Together AI خدمة Post-Training لتدريب RL وSFT على وحدات GPU مخصصة عبر LoRA والأوزان الكاملة ونقل سهل من Tinker. سعر B200 يبدأ من $9 لكل ساعة GPU لأول 8 أسابيع.

Together AI وY Combinator تطلقان أول مجموعة GPU مخصصة لشركات YC الناشئة
أطلقت Together AI وY Combinator أول مجموعة GPU مخصصة للشركات الناشئة في مجتمع YC، من دون عقود إلزامية لاستئجار القدرات الحاسوبية لمدة عامين.

Kimi K2.7 Code في مواجهة Claude Fable 5: صفحات هبوط بتكلفة أقل بنسبة 94%
قارنت Together AI بين Kimi K2.7 Code وClaude Fable 5 على 12 صفحة هبوط: كانت تكلفة Kimi أقل بنسبة 94% تقريبًا، ولم يتأخر كثيرًا عنه في جودة النتيجة.

Together AI تعرض تسعة أبحاث في مؤتمر ICML 2026 في سيول
أعلنت Together AI قبول تسعة من أبحاثها في ICML 2026 بسيول، وتغطي الأوراق كامل مكدس بنية الذكاء الاصطناعي التحتية، من الوكلاء إلى نوى GPU.

Mamba-3: بديل للمحوّلات بتعقيد حسابي خطي
قدّم باحثون من CMU وTogether AI نموذج Mamba-3، وهو بنية جديدة قائمة على SSM ومُحسَّنة لتوليد النصوص بسرعة.
نماذج مفتوحة بضمان 99%: Together AI تطلق خدمة استدلال موثوقة
أطلقت Together AI خدمة Provisioned Throughput، وهي قدرات استدلال محجوزة لنموذجي MiniMax M3 وGLM-5.2 باتفاقية مستوى خدمة بنسبة 99% وتوفير يصل إلى 90% مقارنة بواجهات API المغلقة.
Together AI تجمع 800 مليون دولار في جولة Series C لتطوير الذكاء الاصطناعي مفتوح المصدر
أغلقت Together AI جولة Series C بقيمة 800 مليون دولار بمشاركة NVIDIA وAramco Ventures وVista Equity. تراهن المنصة على نماذج مفتوحة المصدر أرخص من نظيراتها المغلقة بما يتراوح بين 6 و20 ضعفًا.
Together AI: GPT-5.5 وGemini وOpus عاجزة عن كتابة نوى سريعة لوحدات معالجة رسومية متعددة
أظهر المعيار الجديد ParallelKernelBench أن أفضل النماذج اللغوية تنجح في أقل من ثلث مهام توليد نوى CUDA للأنظمة متعددة المعالجات.
Together AI تحصل على شهادة ISO 27001:2022 لأحمال الذكاء الاصطناعي المؤسسية
اجتازت Together AI تدقيق ISO 27001:2022 الدولي، وأكدت جهة مستقلة نضج منظومة أمن المعلومات لديها لخدمة عملاء الشركات.
Together AI تطلق MiniMax M3 بسياق يبلغ مليون رمز ودعم متعدد الوسائط
أصبحت Together AI شريكًا لـ MiniMax في إطلاق M3، النموذج الرائد الذي يدعم سياقًا من مليون رمز ومعالجة أصيلة للصور وتسريعًا للاستدلال يصل إلى 125%.
Together AI في NVIDIA GTC 2026: Dynamo والنماذج متعددة الوكلاء والذكاء الاصطناعي الصوتي
عرضت Together AI في GTC 2026 تكاملها مع NVIDIA Dynamo 1.0، وأطلقت حزمة NemoClaw للوكلاء، وفتحت الوصول إلى نموذج Nemotron 3 Super بحجم 120B.
Together AI تتفوق على TensorRT-LLM بنسبة 31% في اختبارات أداء وكلاء البرمجة
سجّل Together Inference Engine عدد رموز في الثانية أكثر بنسبة 31% وزمنًا أفضل بمرتين لأول رمز عند ذروة الحمل، في أول اختبار واقعي لوكلاء الإنتاج.
DeepSeek أسرع بأربع مرات: كيف يعمل نظام ATLAS لنماذج LLM
تقنية ATLAS الجديدة من Together AI، وهي adaptive-learning speculator، تسرّع استدلال LLM بمقدار 4 مرات دون ضبط يدوي، إذ تتكيّف تلقائيًا مع عبء عمل المستخدم.
البنية التحتية للذكاء الاصطناعي: عناقيد GPU سحابية للشركات
أطلقت Together AI رسميًا خدمة Instant Clusters، وهي عناقيد GPU ذاتية الخدمة مبنية على NVIDIA H100 وB200 تُنشر في دقائق وتكون جاهزة للإنتاج دون موافقات طويلة.
Together AI ترفع حدود Batch Inference API بمقدار 3000 ضعف وتخفض الأسعار بنسبة 50%
يعالج Batch Inference API الآن ما يصل إلى 30 مليار توكن (بدلاً من 10 ملايين) بتكلفة تقل بمقدار النصف عن real-time API، ويدعم جميع نماذج المنصة التي يتجاوز عددها 40 نموذجاً.
كيف تُدرّب شبكة عصبية كبيرة لمهامك الخاصة: الضبط الدقيق (fine-tuning) لنموذج DeepSeek
تتيح منصة الضبط الدقيق من Together AI الآن تدريب أقوى النماذج المفتوحة، وهي DeepSeek-R1 وQwen3-235B وLlama 4، مع دعم السياقات الموسّعة والتكامل مع Hugging Face.
الشبكات العصبية أسرع مرتين: FlashAttention-3 من NVIDIA
أطلقت Together AI خوارزمية FlashAttention-3 التي تسرّع المحوّلات بمعدل 1.5-2 مرة وتستغل 75% من أداء وحدة GPU من طراز H100، مع دعم الدقة المنخفضة FP8.
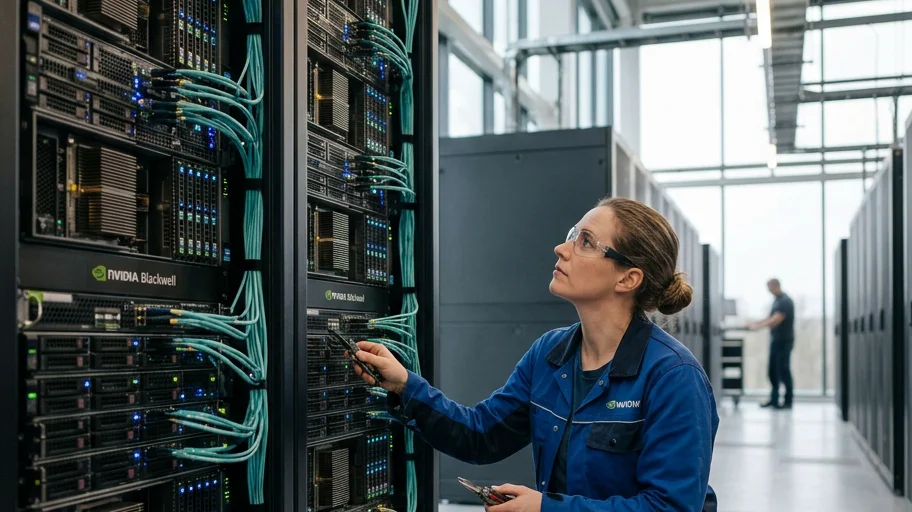
Together AI تحقق تسريعًا بنسبة 90% في التدريب على معالجات NVIDIA Blackwell
أعلنت Together AI إتاحة عناقيد GPU من NVIDIA Blackwell مع تحسينات خاصة بها، وحققت تسريعًا بنسبة 90% في تدريب Llama 70B وبلغت 15,264 رمزًا في الثانية لكل GPU.
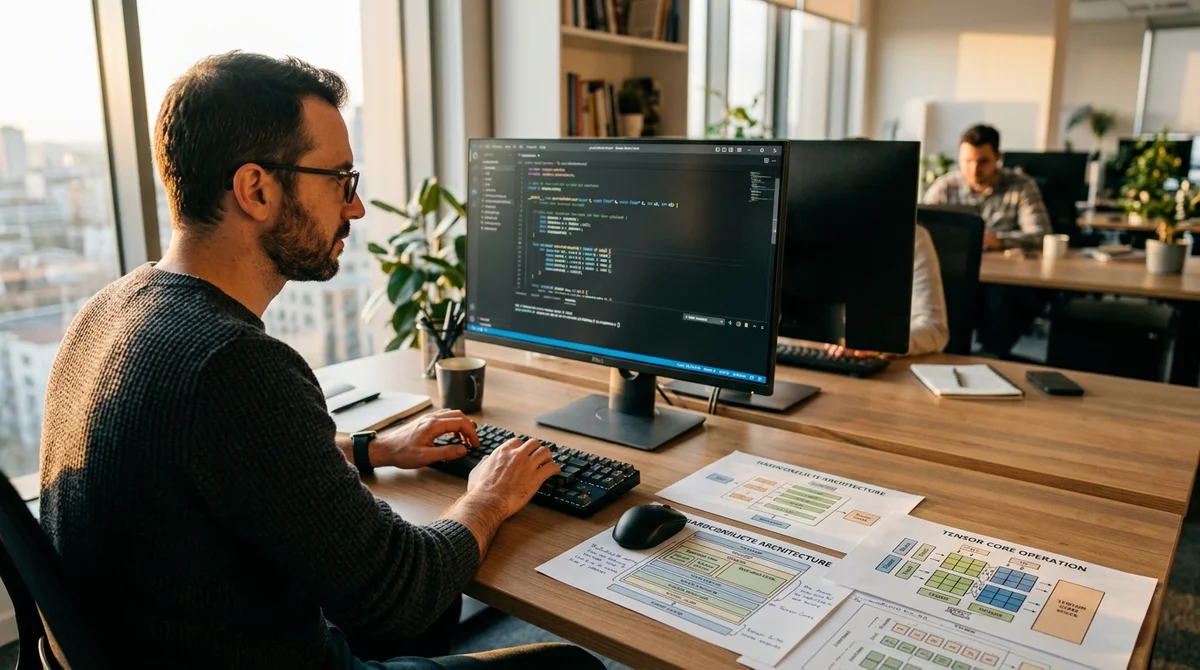
ThunderKittens من Together AI: لغة جديدة لكتابة GPU kernels بكفاءة
قدّمت Together AI لغة ThunderKittens لبرمجة GPU kernels، تُكتب بأسلوب PyTorch وتعمل بكفاءة CUDA الخالصة. وعلى H100 يتفوق كودها في السرعة على FlashAttention2 التقليدي.
وكلاء الذكاء الاصطناعي لتحليل البيانات: إطار العمل DSGym
نشرت Together AI إطار DSGym الموحد لتقييم وتدريب وكلاء LLM على مهام علم البيانات. يضم أكثر من 90 مهمة في المعلوماتية الحيوية و92 مسابقة Kaggle، وتم تدريب نموذج بحجم 4B على بيانات اصطناعية وحقق نتائج SOTA.
سحابة للذكاء الاصطناعي: لماذا تختلف بنيتها عن السحابات المخصصة للويب
شركات الذكاء الاصطناعي الناشئة مثل Cursor تُطوّر منتجاتها أسبوعيًا وتستهلك وحدات GPU كما كانت تطبيقات الويب تفعل في 2012. حدّدت Together AI مواصفات السحابة القادرة على مواكبة سرعة هذه الشركات.
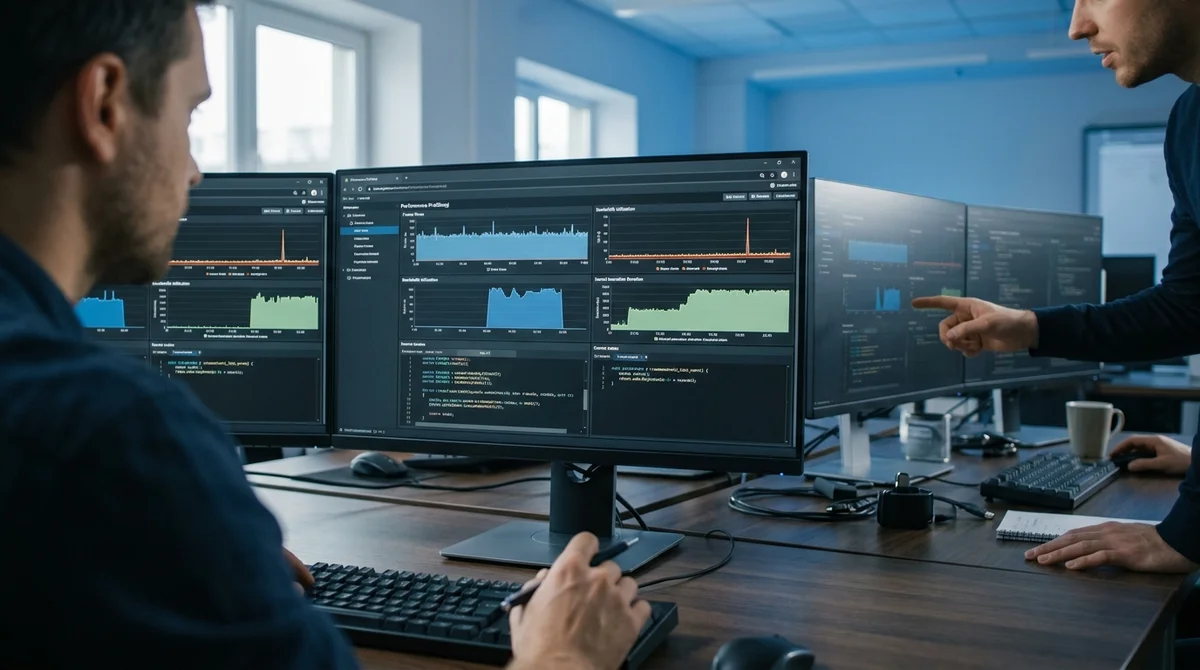
تحسين الشبكات العصبية على وحدات GPU: كيف تُسرّع Together AI الذكاء الاصطناعي
ابتكر فريق تحسين الأنوية في Together AI تقنية تُسرّع عمل وحدات GPU بمقدار 2–3x. وخلال أسبوع واحد، كيّف الفريق الأنوية لوحدات Blackwell GPU الجديدة، وهو عمل استغرق NVIDIA عامًا كاملًا.
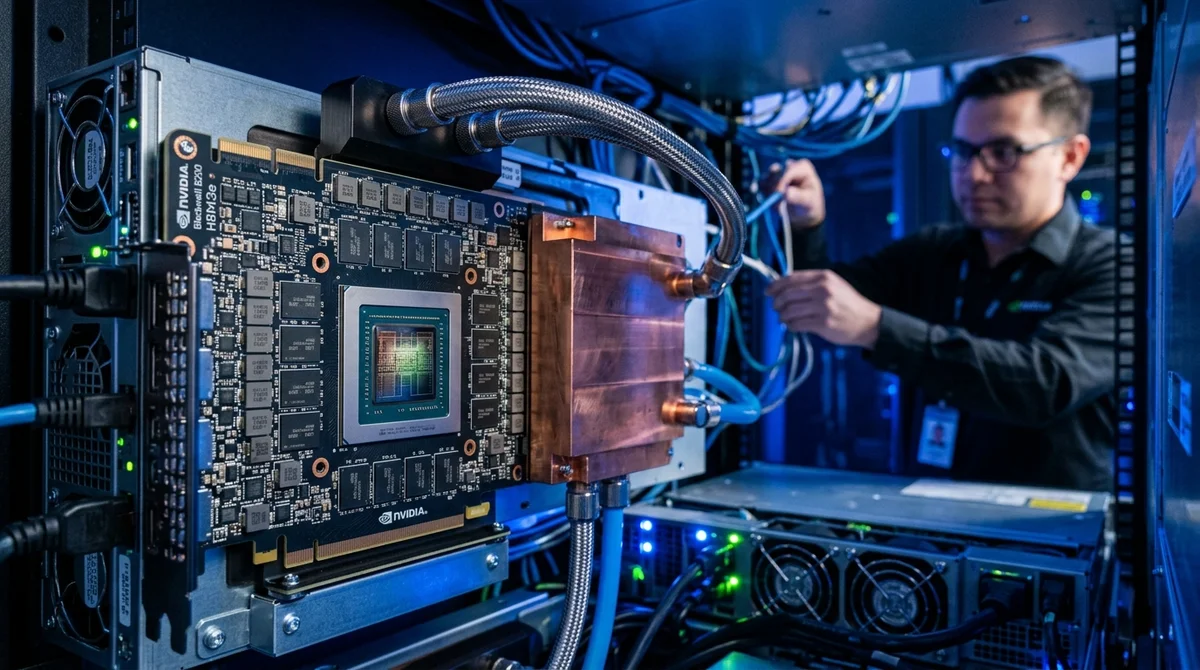
FlashAttention-4: كيف سرّعت Together AI آلية الانتباه على معالجات Blackwell
قدّمت Together AI نسخة FlashAttention-4، وهي تحسين لخوارزمية الانتباه على معالجات Blackwell يصل إلى 1605 TFLOPs/s ويعمل أسرع بـ 2.7 مرة من Triton.